1. 理解FlashAttention原理
任务目标
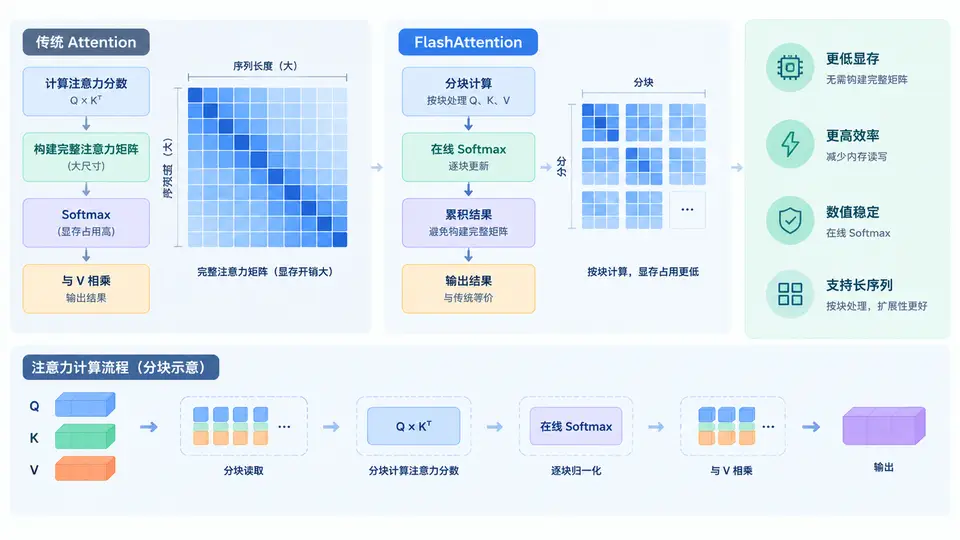
在不实际编写完整CUDA内核的前提下,通过Python逐步实现标准Attention与FlashAttention的前向计算逻辑,对比两者在内存访问模式与中间结果存储上的本质差异,从而理解FlashAttention为何能减少HBM(高带宽内存)读写。
核心原理
标准Attention需要将完整的 \( S = QK^T \in \mathbb{R}^{N \times N} \) 矩阵写入HBM,再读回计算Softmax,产生 \( O(N^2) \) 内存访问。FlashAttention的核心在于分块(tiling)与在线Softmax(online softmax):将Q、K、V按块加载到SRAM中,在块内计算局部Softmax,并通过运行最大值 \( m \) 与运行归一化项 \( l \) 的递推更新,最终得到与全局Softmax完全一致的结果,全程无需实例化完整的 \( N \times N \) 矩阵。
实现代码
import numpy as np

def standard_attention(Q, K, V):
    """标准Attention:完整计算 S = QK^T,再softmax。"""
    scores = Q @ K.T          # (N, N)
    scores = scores - scores.max(axis=-1, keepdims=True)  # 数值稳定
    exp_scores = np.exp(scores)
    probs = exp_scores / exp_scores.sum(axis=-1, keepdims=True)
    return probs @ V, probs

def flash_attention_v2(Q, K, V, block_size=2):
    """FlashAttention-2风格的前向计算(纯numpy模拟,验证正确性)。"""
    N, d = Q.shape
    out = np.zeros((N, d))
    l = np.zeros(N)          # 运行归一化项
    m = np.full(N, -np.inf)  # 运行最大值

    for i in range(0, N, block_size):
        Qi = Q[i:i+block_size]
        mi_prev = m[i:i+block_size].copy()
        li_prev = l[i:i+block_size].copy()
        out_prev = out[i:i+block_size].copy()

        # 内循环:遍历K/V块
        for j in range(0, N, block_size):
            Kj = K[j:j+block_size]
            Vj = V[j:j+block_size]

            S_ij = Qi @ Kj.T          # (block_size, block_size)
            m_new = np.maximum(mi_prev, S_ij.max(axis=-1))
            P_ij = np.exp(S_ij - m_new[:, None])
            l_new = li_prev * np.exp(mi_prev - m_new) + P_ij.sum(axis=-1)

            # 更新输出:按比例修正旧输出并累加新块贡献
            out_new = out_prev * np.exp(mi_prev - m_new)[:, None] + P_ij @ Vj

            mi_prev, li_prev, out_prev = m_new, l_new, out_new

        # 写回当前行块
        m[i:i+block_size] = mi_prev
        l[i:i+block_size] = li_prev
        out[i:i+block_size] = out_prev

    # 最终归一化
    out = out / l[:, None]
    return out

# 验证:随机输入,对比两种实现
np.random.seed(42)
N, d = 4, 8
Q = np.random.randn(N, d).astype(np.float64)
K = np.random.randn(N, d).astype(np.float64)
V = np.random.randn(N, d).astype(np.float64)

out_std, _ = standard_attention(Q, K, V)
out_flash = flash_attention_v2(Q, K, V, block_size=2)

# 判定:数值误差小于1e-8
diff = np.abs(out_std - out_flash).max()
print(f"最大误差: {diff:.2e}")
assert diff < 1e-8, "FlashAttention结果与标准Attention不一致!"
print("验证通过:FlashAttention前向计算正确。")
运行与验证
- 依赖:仅需Python 3.8+与NumPy(
pip install numpy)。 - 运行方式:将代码保存为
flash_attn_demo.py,执行python flash_attn_demo.py。 - 通过条件:控制台输出
最大误差: x.xxe-xx(数值小于1e-8)且打印验证通过,即证明分块在线Softmax与标准Attention数学等价。
内存访问对比
- 标准Attention:需将 \( N \times N \) 的S矩阵写入HBM再读回,内存复杂度 \( O(N^2) \)。
- FlashAttention:每个Q块只与所有K/V块交互,中间结果 \( S_{ij} \) 与 \( P_{ij} \) 在SRAM内计算后立即使用,不落HBM;整体HBM访问量降至 \( O(N^2 d^2 / M) \)(\( M \) 为SRAM大小),本案例中通过分块循环模拟了这一过程。
关键理解点
- 在线Softmax递推:第8~10行代码展示了当新块到来时,如何用旧最大值 \( m_{prev} \) 与新块最大值比较得到 \( m_{new} \),再按比例修正旧输出 \( out_{prev} \) 的缩放系数 \( \exp(m_{prev}-m_{new}) \),保证累加结果与全局Softmax一致。
- 分块粒度:本案例
block_size=2仅为演示递推逻辑;真实GPU实现中block_size由SRAM容量决定(通常为64或128)。 - 数值等价性:验证代码通过随机输入对比两种实现的最大误差,误差小于1e-8即证明分块计算没有引入近似误差,结果与标准Attention逐位一致。