3. ZeRO Stage 2 梯度切分
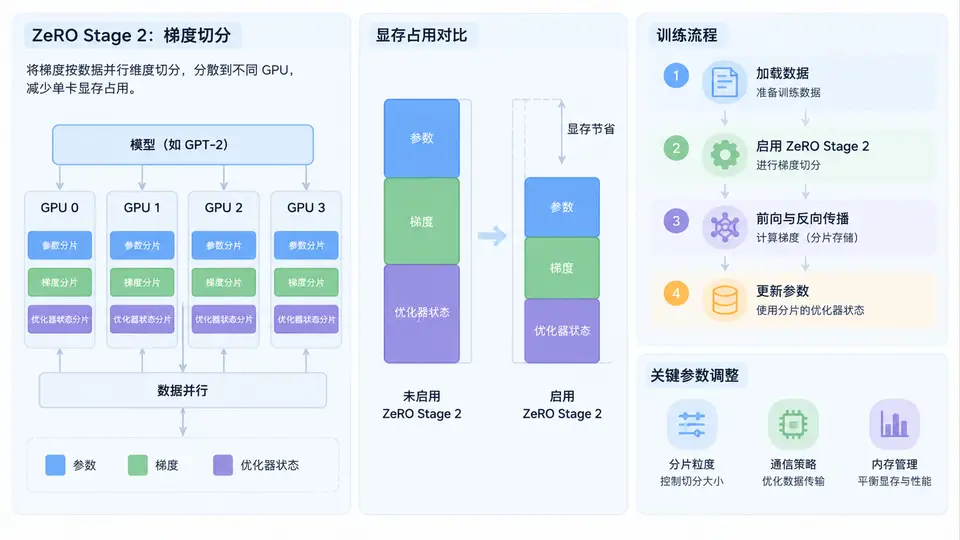
任务目标
在DeepSpeed中启用ZeRO Stage 2,训练模型,通过梯度切分减少显存占用,并观察与调整reduce_bucket_size、allgather_bucket_size等参数对显存与训练速度的影响。
环境与依赖
- Python 3.8+,PyTorch 1.10+,DeepSpeed 0.9+,transformers 4.20+
- 单机多卡(至少2张GPU)或单卡(需配合
stage 2的CPU offload可选) - 安装:
pip install deepspeed transformers
核心实现
以下代码使用transformers加载,配置DeepSpeed ZeRO Stage 2,并执行一个最小训练循环。关键点:zero_optimization.stage = 2启用梯度切分;reduce_bucket_size控制梯度归并通信的粒度,allgather_bucket_size控制权重聚合粒度,两者越小显存峰值越低但通信更频繁。
import os
import torch
import deepspeed
from transformers import GPT2LMHeadModel, GPT2Tokenizer

# 1. 最小训练数据(真实场景替换为dataloader)
texts = [
    "DeepSpeed enables large model training with ZeRO.",
    "Gradient partitioning reduces memory redundancy across GPUs.",
    " is a transformer-based language model."
]
tokenizer = GPT2Tokenizer.from_pretrained("")
tokenizer.pad_ = tokenizer.eos_
inputs = tokenizer(texts, return_tensors="pt", padding=True, truncation=True, max_length=64)
labels = inputs["input_ids"].clone()

# 2. 模型与DeepSpeed配置
model = GPT2LMHeadModel.from_pretrained("")
model_config = {
    "train_batch_size": 3,
    "gradient_accumulation_steps": 1,
    "optimizer": {
        "type": "AdamW",
        "params": {"lr": 5e-5}
    },
    "zero_optimization": {
        "stage": 2,
        "reduce_bucket_size": 5e7,      # 梯度归并桶大小(字节)
        "allgather_bucket_size": 5e7,   # 权重聚合桶大小(字节)
        "contiguous_gradients": True    # 梯度连续存储,减少碎片
    },
    "fp16": {"enabled": True}
}

# 3. 初始化DeepSpeed引擎
model_engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    model_parameters=model.parameters(),
    config=model_config
)

# 4. 最小训练循环(3步)
model_engine.train()
for step in range(3):
    outputs = model_engine(input_ids=inputs["input_ids"], attention_mask=inputs["attention_mask"], labels=labels)
    loss = outputs.loss
    model_engine.backward(loss)
    model_engine.step()
    print(f"step {step}: loss = {loss.item():.4f}")

# 5. 显存峰值统计(需在训练循环外调用)
mem = torch.cuda.max_memory_allocated() / 1e9
print(f"Peak GPU memory: {mem:.2f} GB")
运行方式
# 单卡运行(ZeRO Stage 2在单卡上仍可减少冗余,但效果有限)
python train__zero2.py

# 多卡运行(推荐,2卡示例)
deepspeed --num_gpus=2 train__zero2.py
参数调整与观察
- 显存节省验证:对比未启用ZeRO(
stage: 0)与Stage 2的max_memory_allocated,Stage 2应显著降低每卡显存峰值。 - 调整
reduce_bucket_size:从5e7降至1e6,梯度通信更频繁,显存峰值略降但训练变慢;增大则相反。 - 调整
allgather_batch_size:影响前向时权重聚合的粒度,值越小临时显存占用越低。 - 观察指标:训练日志中的loss下降趋势、
nvidia-smi显示的显存占用、每步耗时。
验证方法与通过条件
- 功能正确:程序运行无报错,3步训练后loss值下降(例如从约4.5降至约4.0以下),说明梯度切分未破坏训练收敛。
- 显存节省:在多卡环境下,使用
stage: 0运行同一脚本记录峰值显存,再启用Stage 2运行,后者每卡峰值显存应低于前者(通常降低30%~50%)。 - 参数生效:修改
reduce_bucket_size为1e6后,训练日志中每步耗时增加(通信更频繁),但显存峰值进一步下降,证明参数调整生效。
常见问题:若单卡运行显存节省不明显,属正常现象——ZeRO Stage 2的核心收益在多卡场景下消除梯度冗余复制;单卡建议配合
"offload_optimizer": {"device": "cpu"}观察优化器状态卸载效果。若出现CUDA out of memory,优先降低batch_size或增大reduce_bucket_size减少通信临时缓冲。