1. DeepSpeed环境搭建与基础配置
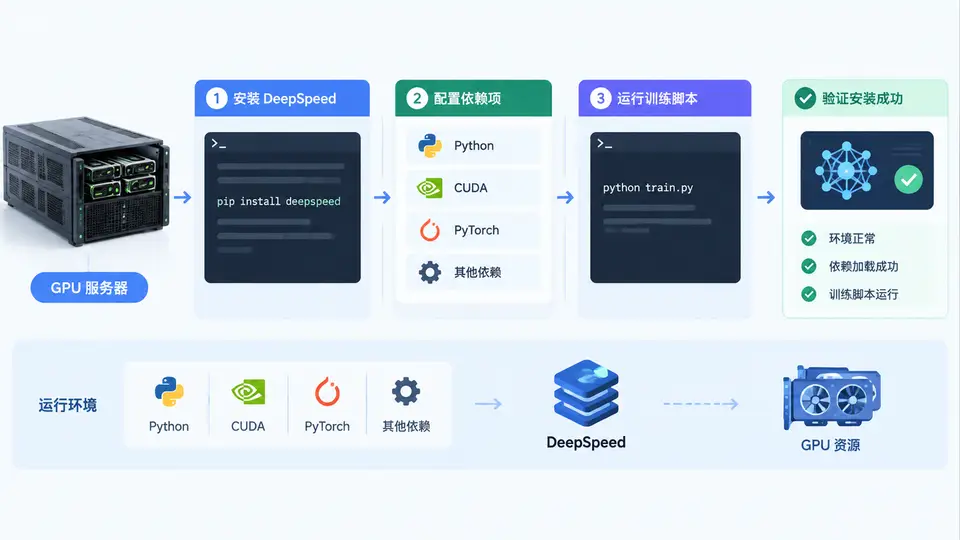
任务目标
在GPU服务器上完成DeepSpeed及其依赖的安装,编写一个最小训练脚本并启动DeepSpeed训练,以验证环境可用。通过观察训练损失下降和DeepSpeed引擎启动日志,确认安装与基础配置正确。
环境与依赖
- 操作系统:Ubuntu 20.04/22.04(或其他Linux发行版)
- GPU:NVIDIA GPU(驱动已安装,支持CUDA 11.7+)
- Python:3.8~3.11
- PyTorch:2.0+(需与CUDA版本匹配)
- DeepSpeed:0.12+
安装步骤
- 创建虚拟环境(可选但推荐):
python -m venv ds_env && source ds_env/bin/activate - 安装PyTorch(以CUDA 11.8为例):
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu118 - 安装DeepSpeed:
pip install deepspeed - 验证安装:
ds_report,确认输出中包含GPU信息且无报错
最小训练脚本
以下脚本定义了一个两层的线性网络,在随机生成的数据上进行回归训练。该脚本不依赖额外数据集,可直接运行验证DeepSpeed环境。
import torch
import torch.nn as nn
import deepspeed

# 定义最小模型
class SimpleNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Sequential(
            nn.Linear(64, 32),
            nn.ReLU(),
            nn.Linear(32, 1)
        )

    def forward(self, x):
        return self.fc(x)

# 构造随机训练数据
torch.manual_seed(42)
x = torch.randn(1024, 64)
y = torch.randn(1024, 1)

model = SimpleNet()
loss_fn = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

# 初始化DeepSpeed引擎
model_engine, optimizer, _, _ = deepspeed.initialize(
    model=model,
    optimizer=optimizer,
    model_parameters=model.parameters(),
    config_params={
        "train_batch_size": 32,
        "gradient_accumulation_steps": 1,
        "fp16": {"enabled": False}
    }
)

# 训练5个epoch
model_engine.train()
for epoch in range(5):
    for i in range(0, len(x), 32):
        batch_x = x[i:i+32].to(model_engine.device)
        batch_y = y[i:i+32].to(model_engine.device)
        outputs = model_engine(batch_x)
        loss = loss_fn(outputs, batch_y)
        model_engine.backward(loss)
        model_engine.step()
    print(f"Epoch {epoch+1}, Loss: {loss.item():.6f}")
运行方式
在GPU服务器上执行以下命令启动训练:
deepspeed train.py如果希望指定GPU编号,可使用:deepspeed --include localhost:0 train.py(使用第0号GPU)。
验证方法与通过条件
- 启动日志:终端输出包含
DeepSpeed info和deepspeed.initialize相关日志,无报错退出。 - 训练输出:每个epoch打印的Loss值应持续下降(例如从约0.9降至0.1以下),说明模型参数正常更新。
- GPU占用:在另一终端运行
nvidia-smi,可观察到python进程占用GPU显存。 - 退出码:训练完成后进程正常退出,无traceback错误。
满足以上条件即说明DeepSpeed安装成功且基础配置正确。
常见问题
- CUDA版本不匹配:运行
python -c "import torch; print(torch.version.cuda)"确认PyTorch的CUDA版本与驱动兼容。 - 显存不足:若GPU显存小于4GB,可将
train_batch_size从32调小至8或16。 - ds_report无GPU信息:检查NVIDIA驱动是否正常(
nvidia-smi),并确认PyTorch能检测到GPU(torch.cuda.is_available()返回True)。