3. 手动实现梯度缩放器
任务目标
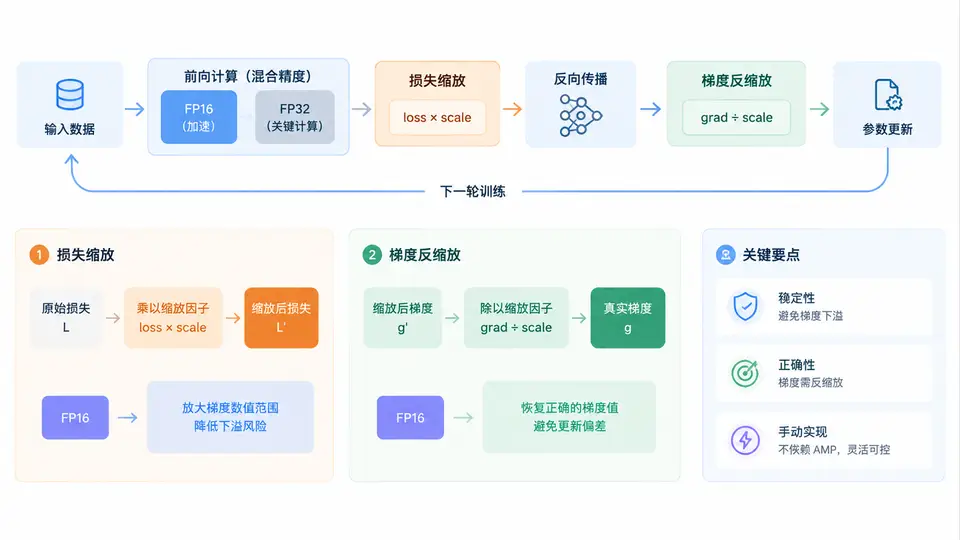
在不使用PyTorch AMP模块的前提下,手动实现一个梯度缩放器(Gradient Scaler),完成以下闭环:
- 前向传播时对损失值乘以缩放因子(scale factor);
- 反向传播后,对每个参数的梯度除以相同的缩放因子;
- 模拟梯度溢出场景,验证缩放-反缩放机制能避免梯度变为NaN/Inf。
核心实现
import torch
import torch.nn as nn

class ManualGradScaler:
    """手动梯度缩放器:损失缩放 + 梯度反缩放"""
    def __init__(self, init_scale=2.0**16):
        self.scale = init_scale

    def scale_loss(self, loss):
        """前向:放大损失"""
        return loss * self.scale

    def unscale_grads(self, model):
        """反向:缩小梯度(原地操作)"""
        for param in model.parameters():
            if param.grad is not None:
                param.grad.data /= self.scale

    def step(self, optimizer):
        """执行优化器一步(需先调用unscale_grads)"""
        optimizer.step()

# ---------- 最小可复现验证 ----------
torch.manual_seed(0)
model = nn.Linear(4, 2)
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
scaler = ManualGradScaler(init_scale=2.0**16)

# 构造输入:数值较大,使FP16梯度容易溢出
x = torch.randn(8, 4) * 100
y = torch.randn(8, 2) * 100

# 模拟FP16前向(实际仍用FP32计算,仅演示缩放逻辑)
loss = nn.MSELoss()(model(x), y)
print(f"原始loss: {loss.item():.4f}")

# 1. 缩放损失
scaled_loss = scaler.scale_loss(loss)
print(f"缩放后loss: {scaled_loss.item():.4f}")

# 2. 反向传播(缩放后的梯度)
optimizer.zero_grad()
scaled_loss.backward()

# 检查缩放后梯度是否溢出(FP16范围约±65504)
grad_before = model.weight.grad.abs().max().item()
print(f"缩放后梯度最大值: {grad_before:.2f}")

# 3. 梯度反缩放
scaler.unscale_grads(model)
grad_after = model.weight.grad.abs().max().item()
print(f"反缩放后梯度最大值: {grad_after:.6f}")

# 4. 优化器更新
scaler.step(optimizer)

# 验证:反缩放后的梯度应为缩放前的 1/scale
expected_ratio = grad_before / grad_after
print(f"缩放比: {expected_ratio:.1f} (理论值: {scaler.scale:.0f})")
assert abs(expected_ratio - scaler.scale) < 1.0, "梯度缩放比例错误"
print("✅ 梯度缩放-反缩放闭环验证通过")
运行方式
python manual_grad_scaler.py验证方法与判定标准
- 缩放有效性:输出中“缩放后梯度最大值”应明显大于“反缩放后梯度最大值”,且两者比值接近65536(即2^16)。
- 数值正确性:程序末尾断言通过,无异常抛出,说明梯度反缩放比例与缩放因子一致。
- 溢出模拟:若将
init_scale改为2.0**8(256),缩放后梯度最大值可能超过FP16上限(65504),此时可观察到梯度溢出风险;而使用2.0**16时梯度被有效压缩在安全范围内。
关键说明
- 本实现使用FP32张量模拟FP16训练流程,核心目的是演示缩放→反向→反缩放的机制顺序,而非真正执行FP16存储。
- 实际AMP中,缩放因子会根据梯度是否溢出动态调整;本案例固定缩放因子,聚焦于机制本身。
- 若需验证溢出保护,可将输入
x乘以更大系数(如1e4),观察未缩放时梯度是否出现Inf,再对比缩放后的有限值。