1. 理解混合精度训练的基本原理
任务目标
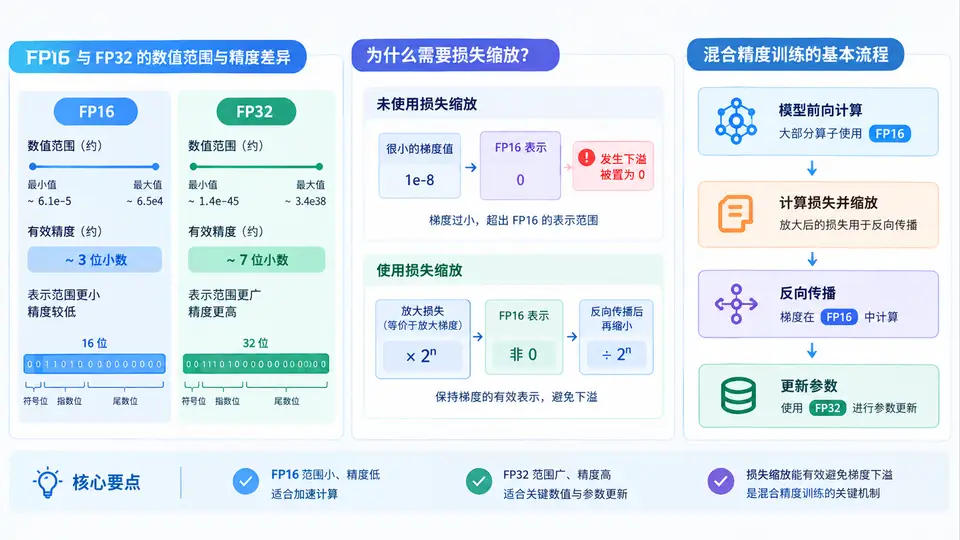
通过一段可运行的PyTorch代码,直观对比FP16与FP32的数值范围与精度差异,并演示混合精度训练中损失缩放(Loss Scaling)如何避免梯度下溢(Underflow),从而理解其必要性。
核心原理
FP32使用32位存储,指数位8位、尾数位23位,数值范围约±3.4×10³⁸,精度约7位十进制小数。FP16使用16位存储,指数位5位、尾数位10位,数值范围约±6.5×10⁴,精度约3位十进制小数。混合精度训练将权重和梯度保留在FP32,前向与反向计算在FP16下进行,通过损失缩放将梯度放大到FP16可表示范围内,避免小梯度被舍入为0。
环境依赖
Python 3.8+,PyTorch 1.8+(含CUDA支持),NVIDIA GPU(无GPU时可使用CPU模拟,但精度差异效果会减弱)。
关键完整代码
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 数值范围与精度对比
print("=== FP16 vs FP32 数值范围与精度 ===")
fp32_val = torch.tensor(1e-5, dtype=torch.float32)
fp16_val = fp32_val.half()
print(f"FP32 表示 1e-5: {fp32_val.item():.10f}")
print(f"FP16 表示 1e-5: {fp16_val.item():.10f}")

# 精度损失演示:FP16 无法区分 1e-3 与 1e-3+1e-6
a_fp32 = torch.tensor(1e-3, dtype=torch.float32)
b_fp32 = a_fp32 + torch.tensor(1e-6, dtype=torch.float32)
a_fp16 = a_fp32.half()
b_fp16 = b_fp32.half()
print(f"FP32 区分 1e-3 与 1e-3+1e-6: {a_fp32.item() != b_fp32.item()}")
print(f"FP16 区分 1e-3 与 1e-3+1e-6: {a_fp16.item() != b_fp16.item()}")

# 2. 损失缩放必要性演示
print("\n=== 损失缩放必要性 ===")
torch.manual_seed(42)
model = nn.Linear(8, 1)
optimizer = optim.SGD(model.parameters(), lr=0.01)
loss_fn = nn.MSELoss()

# 构造小梯度场景:输入小、目标小
x = torch.randn(4, 8) * 0.01
y = torch.randn(4, 1) * 0.001

# 不使用损失缩放
model.zero_grad()
loss = loss_fn(model(x), y)
loss.backward()
grad_fp32 = model.weight.grad.clone()
print(f"FP32 梯度最大值: {grad_fp32.abs().max().item():.2e}")
print(f"FP32 梯度最小值: {grad_fp32.abs().min().item():.2e}")

# 模拟FP16下梯度下溢
grad_fp16 = grad_fp32.half()
print(f"FP16 梯度最小值: {grad_fp16.abs().min().item():.2e}")
print(f"FP16 下溢为0的梯度数: {(grad_fp16 == 0).sum().item()} / {grad_fp16.numel()}")

# 使用损失缩放(缩放因子 1024)
scale = 1024.0
model.zero_grad()
loss = loss_fn(model(x), y)
scaled_loss = loss * scale
scaled_loss.backward()
scaled_grad_fp16 = (model.weight.grad * scale).half()
print(f"缩放后 FP16 梯度最小值: {scaled_grad_fp16.abs().min().item():.2e}")
print(f"缩放后 FP16 下溢为0的梯度数: {(scaled_grad_fp16 == 0).sum().item()} / {scaled_grad_fp16.numel()}")

# 恢复真实梯度(反缩放)
restored_grad = scaled_grad_fp16.float() / scale
print(f"反缩放后梯度与FP32梯度相对误差: {((restored_grad - grad_fp32).abs() / grad_fp32.abs()).mean().item():.2e}")
运行方式
python mixed_precision_demo.py验证方法与判定标准
- 精度差异验证:观察FP16表示1e-5时输出为0或明显失真;FP16无法区分1e-3与1e-3+1e-6(输出False),而FP32可以(输出True)。
- 梯度下溢验证:未缩放时,FP16梯度中部分数值为0(下溢);缩放1024倍后,下溢梯度数减少或消失。
- 反缩放正确性验证:反缩放后的梯度与FP32梯度相对误差在1e-2量级以内,说明损失缩放能有效保留小梯度信息。
若输出符合上述预期,则证明已理解FP16与FP32的数值差异及损失缩放的必要性。