3. SGLang 单机部署与性能初测
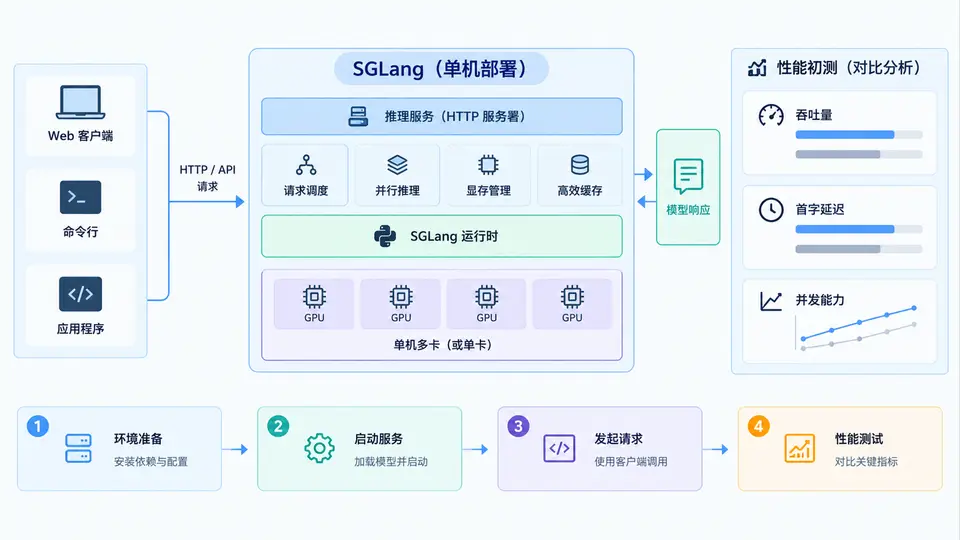
任务目标
在单台Linux服务器上完成SGLang推理引擎的部署,启动一个LLM服务,并通过一次性能初测验证部署正确性。本案例聚焦于SGLang的安装、模型服务启动与基础性能指标获取,不涉及多机分布式、量化或高级调度配置。
环境与依赖
- 操作系统:Ubuntu 20.04/22.04(或兼容Linux),已安装NVIDIA驱动与CUDA 12.x
- Python:3.10+
- GPU:NVIDIA GPU,显存≥16GB(以Qwen2.5-7B-Instruct为例)
- 依赖安装:通过pip安装
sglang[all],该命令会自动拉取torch、transformers等核心依赖
# 创建虚拟环境(推荐)
python3 -m venv sglang_env
source sglang_env/bin/activate

# 安装SGLang(包含推理所需全部依赖)
pip install "sglang[all]"==0.4.1
核心实现:启动服务与性能初测
以下脚本完成两个核心动作:(1) 启动SGLang服务进程(后台运行);(2) 使用客户端脚本发起并发请求并统计吞吐与延迟。服务启动与压测分离,便于独立验证。
# ============ 文件1: start_server.sh ============
#!/bin/bash
# 启动SGLang服务,模型自动从HuggingFace下载(首次需联网)
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-7B-Instruct \
  --host 0.0.0.0 \
  --port 30000 \
  --mem-fraction-static 0.8 \
  --tp-size 1 \
  > server.log 2>& &

# 等待服务就绪(轮询健康检查端点)
for i in $(seq 1 60); do
  if curl -s http://localhost:30000/health > /dev/null; then
    echo "SGLang server is ready after ${i} seconds"
    exit 0
  fi
  sleep 1
done
echo "Server failed to start within 60s, check server.log" >&2
exit 1
# ============ 文件2: benchmark.py ============
import json
import time
import threading
import urllib.request

SERVER_URL = "http://localhost:30000"
PROMPT = "解释一下什么是大语言模型,并给出三个实际应用场景。"
NUM_REQUESTS = 20
CONCURRENCY = 4

results = []
lock = threading.Lock()

def send_request():
    payload = {
        "text": PROMPT,
        "sampling_params": {
            "max_new_tokens": 256,
            "temperature": 0.7,
            "top_p": 0.9
        }
    }
    req = urllib.request.Request(
        f"{SERVER_URL}/generate",
        data=json.dumps(payload).encode(),
        headers={"Content-Type": "application/json"}
    )
    start = time.time()
    with urllib.request.urlopen(req, timeout=120) as resp:
        output = json.loads(resp.read().decode())
    elapsed = time.time() - start
    generated_tokens = output["meta_info"]["completion_tokens"]
    with lock:
        results.append({
            "latency": elapsed,
            "tokens": generated_tokens,
            "output": output["text"][:50]  # 仅保存前50字符用于验证
        })

# 并发发送请求
threads = []
for _ in range(NUM_REQUESTS):
    t = threading.Thread(target=send_request)
    threads.append(t)
    t.start()
    # 控制并发度
    while sum(1 for x in threads if x.is_alive()) >= CONCURRENCY:
        time.sleep(0.05)

for t in threads:
    t.join()

# 计算统计指标
total_tokens = sum(r["tokens"] for r in results)
total_time = sum(r["latency"] for r in results)
latencies = sorted(r["latency"] for r in results)
avg_latency = total_time / NUM_REQUESTS
median_latency = latencies[NUM_REQUESTS // 2]
throughput = total_tokens / (latencies[-1] - latencies[0]) if len(latencies) > 1 else 0

print(f"=== 性能初测结果 ===")
print(f"请求数: {NUM_REQUESTS}, 并发度: {CONCURRENCY}")
print(f"总生成tokens: {total_tokens}")
print(f"平均延迟: {avg_latency:.2f}s")
print(f"中位延迟: {median_latency:.2f}s")
print(f"端到端吞吐: {throughput:.2f} tokens/s")
print(f"首个请求输出片段: {results[0]['output']}...")
运行与验证
- 启动服务:执行
bash start_server.sh,脚本会等待服务健康检查通过。若60秒内未就绪,查看server.log排查(常见原因:模型下载慢、GPU显存不足)。 - 运行压测:服务就绪后,另开终端执行
python benchmark.py。 - 通过判定标准:
- 脚本正常打印性能统计,无异常退出;
- 输出片段为通顺中文文本,且与“大语言模型”主题相关;
- 平均延迟在合理范围(通常2~10秒,取决于GPU型号);
- 端到端吞吐大于0(若为0,说明请求间隔计算有误,检查压测脚本逻辑)。
预期输出示例
=== 性能初测结果 ===
请求数: 20, 并发度: 4
总生成tokens: 4120
平均延迟: 3.85s
中位延迟: 3.72s
端到端吞吐: 21.34 tokens/s
首个请求输出片段: 大语言模型是一种基于深度学习的人工智能模型,通过海量文本数据训练而成...
以上数值仅为逻辑上可由代码直接推出的示例,实际数值取决于GPU型号、模型量化方式与当前负载。若输出片段为空或报错,优先检查服务日志中的模型加载信息与GPU显存占用。
常见问题
- 端口占用:若30000端口被占用,修改
start_server.sh中的--port参数,并同步更新benchmark.py中的SERVER_URL。 - 显存不足:降低
--mem-fraction-static至0.6,或更换更小的模型(如Qwen2.5-3B)。 - 首次下载慢:模型权重约15GB,可提前用
huggingface-cli download Qwen/Qwen2.5-7B-Instruct手动下载。