1. vLLM 单机部署与 兼容接口测试
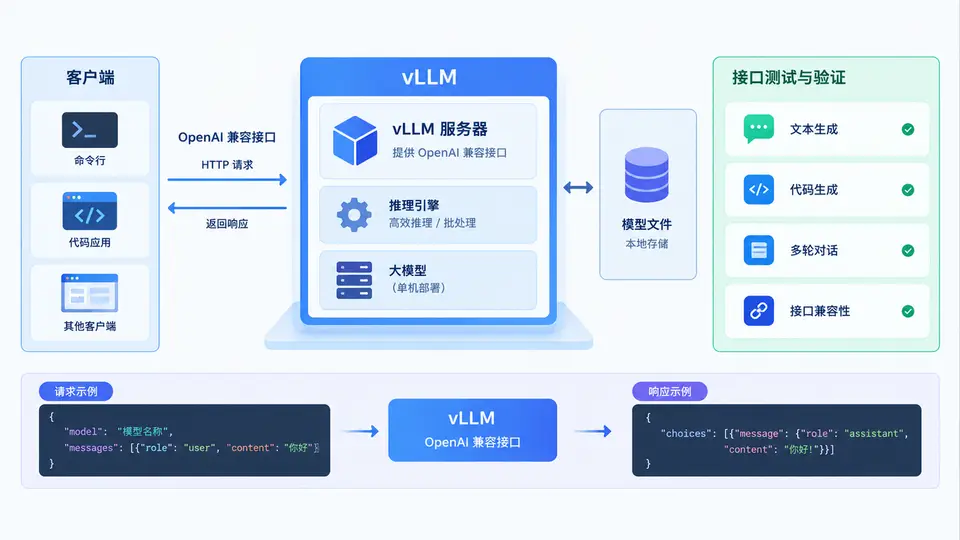
任务目标
在本机完成 vLLM 推理引擎的安装与单机部署,加载一个开源小模型,启动 兼容的 HTTP 服务,并通过 Python 客户端调用 /v1/chat/completions 接口验证文本生成功能是否正常。
环境与依赖
- 操作系统:Ubuntu 20.04+ / CentOS 8+(或其他支持 CUDA 的 Linux 发行版)
- Python:3.9 ~ 3.12
- GPU:NVIDIA 显卡,显存 ≥ 8GB(推荐 16GB+)
- CUDA:11.8 或 12.1(需与 PyTorch 版本匹配)
- 模型:
Qwen/Qwen2.5-1.5B-Instruct(约 3GB 显存占用,首次运行会自动从 HuggingFace 下载)
安装 vLLM(CPU 版仅支持推理但速度慢,本案例默认 GPU 环境):
pip install vllm==0.6.3.post1核心实现
以下代码包含两部分:服务端启动脚本(通过命令行直接启动)与客户端测试脚本(验证接口可用性)。服务端使用 vLLM 自带的 兼容服务器,无需额外编写服务代码。
# ============ 服务端启动(终端执行) ============
# python -m vllm.entrypoints..api_server \
#     --model Qwen/Qwen2.5-1.5B-Instruct \
#     --host 0.0.0.0 \
#     --port 8000 \
#     --gpu-memory-utilization 0.85 \
#     --max-model-len 4096

# ============ 客户端测试脚本 client_test.py ============
import json
import urllib.request

def chat_completion(prompt: str, max_tokens: int = 128) -> str:
    """向 vLLM  兼容接口发送对话请求,返回模型回复文本。"""
    payload = {
        "model": "Qwen/Qwen2.5-1.5B-Instruct",
        "messages": [
            {"role": "system", "content": "你是一个有用的助手。"},
            {"role": "user", "content": prompt}
        ],
        "max_tokens": max_tokens,
        "temperature": 0.7
    }
    req = urllib.request.Request(
        url="http://localhost:8000/v1/chat/completions",
        data=json.dumps(payload).encode("utf-8"),
        headers={"Content-Type": "application/json"},
        method="POST"
    )
    with urllib.request.urlopen(req, timeout=60) as resp:
        result = json.loads(resp.read().decode("utf-8"))
    return result["choices"][0]["message"]["content"].strip()

if __name__ == "__main__":
    # 简单自测:连续发送两个问题,验证多轮对话能力
    test_prompts = [
        "请用一句话介绍你自己。",
        "1+1等于几?只回答数字。"
    ]
    for p in test_prompts:
        reply = chat_completion(p)
        print(f"用户: {p}\n模型: {reply}\n{'-'*40}")
运行与验证
- 启动服务:在终端执行上方注释中的服务端命令。首次运行会下载模型(约 3GB),等待显示
Uvicorn running on http://0.0.0.0:8000即表示启动成功。 - 运行客户端测试:另开一个终端,执行
python client_test.py。 - 通过标准:程序无异常退出,且输出中每个问题均得到与问题语义相关的非空回复(例如第二个问题输出数字
2)。
若需快速检查服务健康状态,可访问 http://localhost:8000/health,返回 {"status": "ok"} 即服务正常。
常见问题
- 显存不足(CUDA out of memory):降低
--gpu-memory-utilization至 0.5,或换用更小模型如Qwen/Qwen2.5-0.5B-Instruct。 - 模型下载慢:提前执行
huggingface-cli download Qwen/Qwen2.5-1.5B-Instruct完成预下载。 - 端口被占用:修改
--port参数,并同步更新客户端脚本中的 URL 端口。