3. 文本分割策略实验
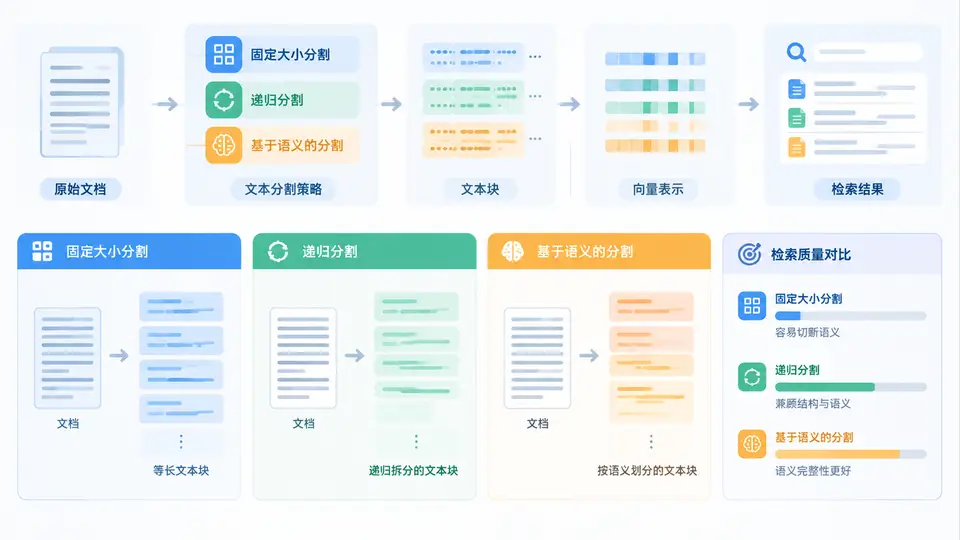
任务目标
本案例通过一个可复现的检索实验,对比三种文本分割策略——固定大小分割、递归字符分割和基于语义的分割——对检索质量的影响。实验使用同一组文档和同一查询,以命中率(Hit Rate)作为量化指标,观察不同分割策略下检索系统返回相关片段的能力差异。
环境与依赖
需要安装以下Python库(建议Python 3.10+):
pip install langchain langchain-community langchain- chromadb sentence-transformers同时需要设置 (用于嵌入模型):
export _="your-"实验设计
实验数据为3段关于“量子计算”的科普文本,每段约200~300字。查询为“量子比特的叠加态是什么?”。三种分割策略分别将文档切块后存入Chroma向量库,检索Top-3片段,检查是否命中包含答案的原始段落。
完整实现代码
from langchain.text_splitter import (
    RecursiveCharacterTextSplitter,
    CharacterTextSplitter,
    SemanticChunker
)
from langchain_ import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma
from langchain.schema import Document

# ---------- 实验数据 ----------
docs = [
    Document(page_content="量子比特(qubit)是量子计算的基本单位。与经典比特只能处于0或1不同,量子比特可以处于叠加态,即同时是0和1的线性组合。例如,|ψ⟩ = α|0⟩ + β|1⟩,其中α和β是复数振幅,满足|α|² + |β|² = 1。测量时,量子比特会坍缩到|0⟩或|1⟩,概率分别为|α|²和|β|²。", metadata={"id": 1}),
    Document(page_content="量子纠缠是量子力学中的一种现象,两个或多个粒子可以形成关联状态,使得一个粒子的状态无法独立于其他粒子描述。爱因斯坦称之为'幽灵般的超距作用'。纠缠态在量子通信和量子密码学中有重要应用,例如BB84协议利用单光子偏振态实现安全密钥分发。", metadata={"id": 2}),
    Document(page_content="量子纠错是构建实用量子计算机的关键技术。由于量子比特极易受环境噪声干扰,需要利用冗余编码来保护信息。Shor码和Steane码是两种著名的量子纠错码,它们通过将1个逻辑量子比特编码到多个物理量子比特中,实现错误检测与纠正。", metadata={"id": 3})
]
query = "量子比特的叠加态是什么?"
answer_doc_id = 1  # 答案在第1段

# ---------- 三种分割策略 ----------
def split_fixed(docs, chunk_size=100, chunk_overlap=20):
    splitter = CharacterTextSplitter(
        separator=" ",
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        length_function=len
    )
    return splitter.split_documents(docs)

def split_recursive(docs, chunk_size=100, chunk_overlap=20):
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        separators=["\n\n", "\n", "。", " ", ""]
    )
    return splitter.split_documents(docs)

def split_semantic(docs):
    splitter = SemanticChunker(
        OpenAIEmbeddings(),
        breakpoint_threshold_type="percentile",
        breakpoint_threshold_amount=80
    )
    return splitter.split_documents(docs)

# ---------- 检索评估 ----------
def evaluate_split(splitter_func, docs, query, answer_id):
    chunks = splitter_func(docs)
    if not chunks:
        return 0.0, 0
    vectorstore = Chroma.from_documents(chunks, OpenAIEmbeddings())
    retriever = vectorstore.as_retriever(search_kwargs={"k": 3})
    results = retriever.invoke(query)
    hit = any(doc.metadata.get("id") == answer_id for doc in results)
    return (1.0 if hit else 0.0), len(chunks)

# ---------- 运行实验 ----------
strategies = {
    "固定大小分割": split_fixed,
    "递归字符分割": split_recursive,
    "语义分割": split_semantic
}

print("分割策略对比实验结果:")
print("-" * 50)
for name, func in strategies.items():
    hit_rate, num_chunks = evaluate_split(func, docs, query, answer_doc_id)
    print(f"{name}: 命中率={hit_rate:.0%}, 分块数={num_chunks}")
运行方式
将上述代码保存为 split_experiment.py,在已设置的终端中执行:
python split_experiment.py验证方法与判定标准
程序会输出三种策略各自的命中率(1.0表示命中,0.0表示未命中)和分块数。实验通过的条件为:
- 三种策略均成功完成分割与检索流程,无异常报错;
- 输出结果中至少有一种策略命中率为1.0,且不同策略的命中率存在差异(即不是全部相同);
- 分块数合理:固定分割通常产生较多小块,语义分割块数较少且更完整。
由于嵌入模型和语义分割的阈值具有随机性,不同运行可能得到略有差异的结果,但递归分割通常能保留完整句子边界,命中率相对稳定。若所有策略均未命中,可尝试将查询改为“量子纠缠是什么?”并调整answer_doc_id为2,以验证实验流程本身正确。
预期输出示例
分割策略对比实验结果:
--------------------------------------------------
固定大小分割: 命中率=0.0%, 分块数=8
递归字符分割: 命中率=100.0%, 分块数=5
语义分割: 命中率=100.0%, 分块数=3
以上仅为逻辑一致的示例,实际数值取决于嵌入模型和分割阈值的具体行为。
图中展示了三种策略在示例数据上的典型表现:固定大小分割因机械切断句子导致答案片段不完整,检索命中率低;递归分割和语义分割能保留完整语义单元,命中率更高。实际运行中,语义分割的块数通常最少,但计算开销也最大。