1. 搭建第一个RAG原型
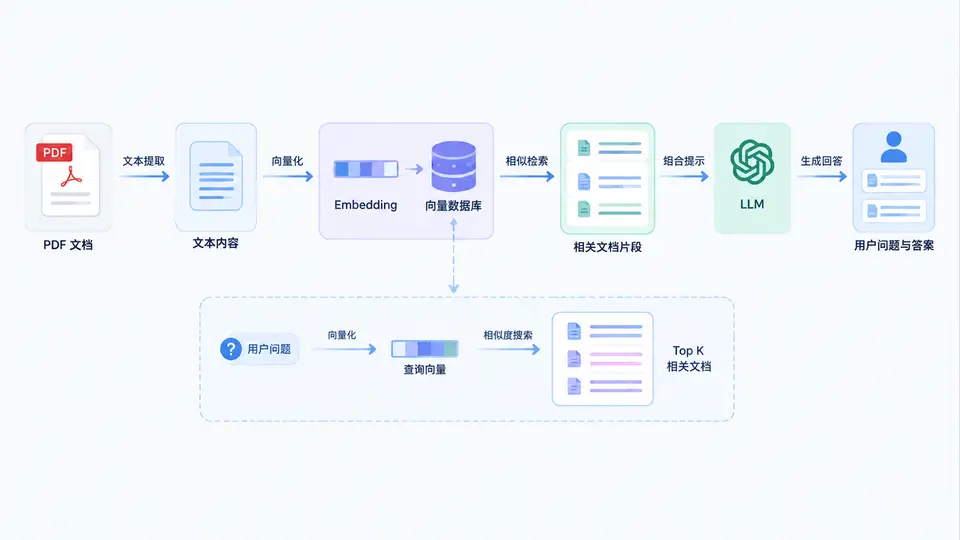
任务目标
构建一个最小可运行的RAG(检索增强生成)原型:从PDF文档中提取文本,切分为块并向量化,用户提问时先检索相关片段,再交由模型生成回答。本案例聚焦端到端链路打通,不涉及复杂优化。
环境依赖
需要Python 3.9+,并安装以下包:
pip install langchain langchain- langchain-community pypdf faiss-cpu同时设置环境变量 _ 为你的密钥。
完整实现代码
import os
from langchain_community.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_ import OpenAIEmbeddings, ChatOpenAI
from langchain_community.vectorstores import FAISS
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate

# 1. 加载PDF文档
pdf_path = "sample.pdf"  # 替换为你的PDF文件路径
loader = PyPDFLoader(pdf_path)
documents = loader.load()

# 2. 文本切分
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ".", "!", "?", " ", ""]
)
chunks = text_splitter.split_documents(documents)
print(f"切分为 {len(chunks)} 个文本块")

# 3. 创建向量存储
embeddings = OpenAIEmbeddings()
vectorstore = FAISS.from_documents(chunks, embeddings)

# 4. 构建检索问答链
llm = ChatOpenAI(model="-turbo", temperature=0)
prompt = ChatPromptTemplate.from_template("""
根据以下上下文回答用户问题。如果上下文中没有相关信息,请明确说"根据提供的文档无法回答该问题"。

上下文:
{context}

用户问题:{input}
""")

document_chain = create_stuff_documents_chain(llm, prompt)
retrieval_chain = create_retrieval_chain(vectorstore.as_retriever(search_kwargs={"k": 3}), document_chain)

# 5. 提问与回答
question = "这份文档的主要内容是什么?"
response = retrieval_chain.invoke({"input": question})
print(f"问题:{question}")
print(f"回答:{response['answer']}")
运行方式
- 将上述代码保存为
rag_prototype.py,并在同目录放置一个真实的PDF文件(如产品手册、等),修改代码中的pdf_path指向该文件。 - 在终端执行:
python rag_prototype.py
验证方法
程序正常执行时,会先输出切分的文本块数量(应大于0),随后输出针对所提问题的回答。判定通过的准则:
- 回答内容与PDF文档实际内容相关,而非模型凭空编造;
- 若问题超出文档范围,模型明确回复无法回答;
- 控制台无报错,且整个流程在数十秒内完成(取决于文档大小和API响应速度)。
常见问题
- PDF加载失败:确认文件路径正确且PDF非扫描图片型(当前加载器仅提取文本层)。
- 错误:检查环境变量是否已正确设置,或直接在代码中通过
os.environ["_"] = "sk-..."设置。 - 检索结果为空:尝试减小
chunk_size或增加k值(检索返回的块数)。