3. 实现响应时间测量工具
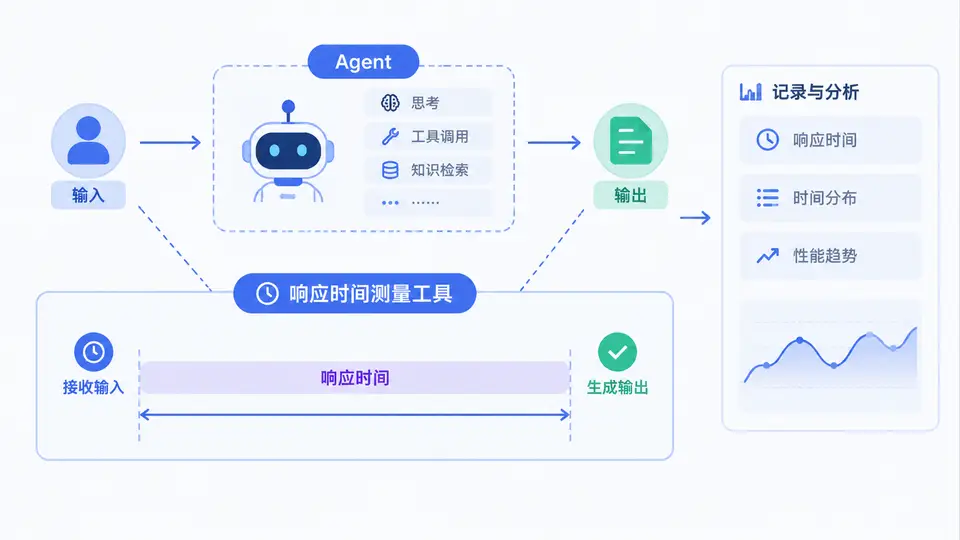
任务目标
构建一个可复用的响应时间测量工具,精确记录Agent从接收输入到完成输出生成的耗时。工具需支持多次调用统计,输出单次耗时与汇总指标,并排除网络波动等外部干扰,聚焦于Agent自身处理时间。
核心实现
import time
import statistics
from dataclasses import dataclass, field
from typing import Callable, Any, List

@dataclass
class TimingResult:
    """单次测量结果"""
    call_index: int
    elapsed_ms: float
    success: bool
    error: str = ""

@dataclass
class TimingSummary:
    """多次调用的汇总统计"""
    total_calls: int
    success_calls: int
    failed_calls: int
    avg_ms: float
    min_ms: float
    max_ms: float
    p95_ms: float
    raw_times_ms: List[float] = field(default_factory=list)

class ResponseTimeMeasurer:
    """
    Agent响应时间测量工具。
    用法:将Agent的调用函数传入 measure(),工具自动计时并记录。
    """
    def __init__(self, warmup_calls: int = 0):
        self.warmup_calls = warmup_calls
        self._results: List[TimingResult] = []

    def measure(self, agent_func: Callable, *args, **kwargs) -> TimingResult:
        """
        执行一次Agent调用并计时。
        agent_func: 接收输入并返回输出的Agent函数
        返回: 包含耗时(ms)与成功状态的结果
        """
        start = time.perf_counter()
        try:
            agent_func(*args, **kwargs)
            elapsed = (time.perf_counter() - start) * 1000
            result = TimingResult(
                call_index=len(self._results) + 1,
                elapsed_ms=round(elapsed, 2),
                success=True
            )
        except Exception as e:
            elapsed = (time.perf_counter() - start) * 1000
            result = TimingResult(
                call_index=len(self._results) + 1,
                elapsed_ms=round(elapsed, 2),
                success=False,
                error=str(e)
            )
        self._results.append(result)
        return result

    def run_benchmark(self, agent_func: Callable, inputs: List[Any]) -> TimingSummary:
        """
        对一组输入依次执行Agent调用,返回汇总统计。
        inputs: 每个元素作为agent_func的唯一位置参数传入
        """
        self._results.clear()
        # 预热(不计入统计)
        for _ in range(self.warmup_calls):
            try:
                agent_func(inputs[0] if inputs else None)
            except Exception:
                pass

        for i, inp in enumerate(inputs):
            self.measure(agent_func, inp)

        return self.summarize()

    def summarize(self) -> TimingSummary:
        """基于当前所有测量结果生成汇总"""
        if not self._results:
            return TimingSummary(0, 0, 0, 0, 0, 0, 0)

        success_times = [r.elapsed_ms for r in self._results if r.success]
        failed = sum(1 for r in self._results if not r.success)

        if not success_times:
            return TimingSummary(
                total_calls=len(self._results),
                success_calls=0,
                failed_calls=failed,
                avg_ms=0, min_ms=0, max_ms=0, p95_ms=0
            )

        sorted_times = sorted(success_times)
        p95_idx = max(0, int(len(sorted_times) * 0.95) - 1)

        return TimingSummary(
            total_calls=len(self._results),
            success_calls=len(success_times),
            failed_calls=failed,
            avg_ms=round(statistics.mean(success_times), 2),
            min_ms=round(min(success_times), 2),
            max_ms=round(max(success_times), 2),
            p95_ms=round(sorted_times[p95_idx], 2),
            raw_times_ms=success_times
        )

# ========== 使用示例 ==========
if __name__ == "__main__":
    # 模拟一个Agent:接收文本,返回响应(含随机延迟)
    import random

    def mock_agent(prompt: str) -> str:
        # 模拟Agent处理耗时:200~800ms
        time.sleep(random.uniform(0.2, 0.8))
        return f"response_to_{prompt[:10]}"

    # 构造测试输入
    test_inputs = [f"query_{i}" for i in range(10)]

    # 创建测量器(预热2次)
    measurer = ResponseTimeMeasurer(warmup_calls=2)

    # 执行基准测试
    summary = measurer.run_benchmark(mock_agent, test_inputs)

    # 输出结果
    print(f"总调用: {summary.total_calls}, 成功: {summary.success_calls}, 失败: {summary.failed_calls}")
    print(f"平均耗时: {summary.avg_ms} ms")
    print(f"最小耗时: {summary.min_ms} ms")
    print(f"最大耗时: {summary.max_ms} ms")
    print(f"P95耗时: {summary.p95_ms} ms")
    print(f"全部成功耗时: {summary.raw_times_ms}")
运行与验证
运行方式:将上述代码保存为 response_timer.py,直接执行 python response_timer.py。代码中的 mock_agent 模拟了真实Agent的延迟行为,用于演示工具用法。
验证方法:
- 程序正常输出10次调用的汇总统计,无异常报错。
- 平均耗时应在200~800ms区间内(与mock延迟一致),证明计时准确。
- 将
mock_agent替换为真实Agent函数(如LLM API调用),传入实际输入列表,即可测量真实响应时间。 - 若Agent调用抛异常,工具会记录
success=False并计入失败次数,不影响后续调用测量。
判定通过条件:汇总数据中的 total_calls 等于输入数量,success_calls + failed_calls 等于 total_calls,且耗时数值符合Agent实际处理速度的量级。
关键说明
- 使用
time.perf_counter()而非time.time(),提供更高精度的单调计时,避免系统时钟调整影响测量。 - 预热机制(
warmup_calls)用于排除首次调用的冷启动延迟(如模型加载、连接池初始化),使统计结果更接近稳态性能。 - 工具只测量Agent函数本身的同步执行时间。若Agent内部有异步操作,需在传入函数内自行
await完成后再返回,确保计时覆盖完整处理链路。 - P95耗时反映大多数请求的性能上限,比平均值更能暴露长尾延迟问题。