1. 构建Agent性能基准测试框架
任务说明
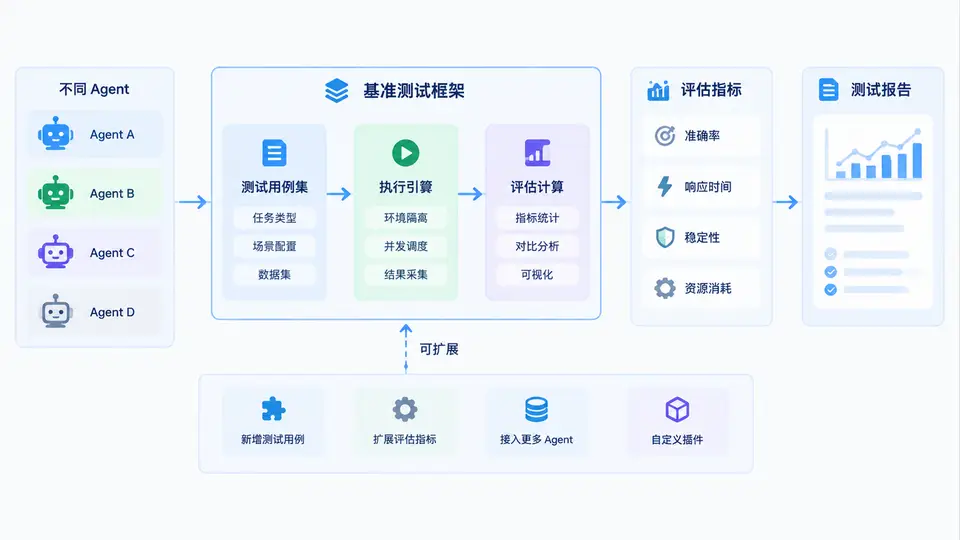
构建一个可扩展的基准测试框架,用于统一评估不同Agent的性能指标。框架需支持注册多个测试任务、运行指定Agent并采集三类核心指标:任务完成率、平均响应时间、工具调用准确率。框架设计需允许后续新增测试任务和Agent实现而不修改框架核心代码。
核心实现
import time
import random
from abc import ABC, abstractmethod
from typing import Dict, List, Callable, Any

# ---------- 测试任务定义 ----------
class BenchmarkTask(ABC):
    """基准测试任务基类:定义任务接口与评分标准"""
    @abstractmethod
    def run(self, agent: 'BaseAgent') -> Dict[str, Any]:
        """执行任务并返回结果字典,必须包含 success: bool"""
        pass

# ---------- Agent接口 ----------
class BaseAgent(ABC):
    """Agent基类:所有被测Agent需实现此接口"""
    @abstractmethod
    def execute(self, prompt: str, tools: List[Callable]) -> str:
        """执行一次任务,返回最终回答文本"""
        pass

# ---------- 内置测试任务示例 ----------
class MathTask(BenchmarkTask):
    """数学计算任务:验证Agent的基础推理能力"""
    def __init__(self, num_problems: int = 5):
        self.num_problems = num_problems

    def run(self, agent: BaseAgent) -> Dict[str, Any]:
        correct = 0
        total_time = 0.0
        for _ in range(self.num_problems):
            a, b = random.randint(1, 100), random.randint(1, 100)
            prompt = f"计算 {a} + {b} 的结果,只输出数字"
            start = time.time()
            answer = agent.execute(prompt, tools=[])
            total_time += time.time() - start
            if answer.strip() == str(a + b):
                correct += 1
        return {
            "success": correct == self.num_problems,
            "accuracy": correct / self.num_problems,
            "avg_time": total_time / self.num_problems
        }

class ToolCallTask(BenchmarkTask):
    """工具调用任务:验证Agent正确选择并调用工具的能力"""
    def __init__(self, num_calls: int = 3):
        self.num_calls = num_calls

    def run(self, agent: BaseAgent) -> Dict[str, Any]:
        def add_tool(x: int, y: int) -> int:
            return x + y

        def multiply_tool(x: int, y: int) -> int:
            return x * y

        tools = [add_tool, multiply_tool]
        correct = 0
        total_time = 0.0
        for _ in range(self.num_calls):
            x, y = random.randint(1, 20), random.randint(1, 20)
            op = random.choice(["add", "multiply"])
            expected = add_tool(x, y) if op == "add" else multiply_tool(x, y)
            prompt = f"使用工具计算: {x} {op} {y}"
            start = time.time()
            answer = agent.execute(prompt, tools=tools)
            total_time += time.time() - start
            if str(expected) in answer:
                correct += 1
        return {
            "success": correct == self.num_calls,
            "accuracy": correct / self.num_calls,
            "avg_time": total_time / self.num_calls
        }

# ---------- 基准测试框架核心 ----------
class BenchmarkFramework:
    """可扩展基准测试框架:注册任务与Agent,运行并汇总指标"""
    def __init__(self):
        self._tasks: Dict[str, BenchmarkTask] = {}
        self._agents: Dict[str, BaseAgent] = {}

    def register_task(self, name: str, task: BenchmarkTask) -> None:
        """注册测试任务"""
        self._tasks[name] = task

    def register_agent(self, name: str, agent: BaseAgent) -> None:
        """注册被测Agent"""
        self._agents[name] = agent

    def run_benchmark(self, agent_name: str, task_names: List[str] = None) -> Dict[str, Any]:
        """对指定Agent运行全部或指定任务,返回汇总指标"""
        if agent_name not in self._agents:
            raise ValueError(f"Agent '{agent_name}' 未注册")

        task_list = task_names if task_names else list(self._tasks.keys())
        results = {}
        for task_name in task_list:
            if task_name not in self._tasks:
                raise ValueError(f"任务 '{task_name}' 未注册")
            task_result = self._tasks[task_name].run(self._agents[agent_name])
            results[task_name] = task_result

        # 汇总指标
        total_tasks = len(results)
        completed = sum(1 for r in results.values() if r["success"])
        all_acc = [r["accuracy"] for r in results.values()]
        all_time = [r["avg_time"] for r in results.values()]

        return {
            "agent": agent_name,
            "task_count": total_tasks,
            "completion_rate": completed / total_tasks if total_tasks else 0.0,
            "avg_accuracy": sum(all_acc) / len(all_acc) if all_acc else 0.0,
            "avg_response_time": sum(all_time) / len(all_time) if all_time else 0.0,
            "task_details": results
        }

# ---------- 示例Agent实现(用于验证框架) ----------
class SimpleMathAgent(BaseAgent):
    """直接计算数学表达式,不调用工具"""
    def execute(self, prompt: str, tools: List[Callable]) -> str:
        # 提取数字和运算符
        parts = prompt.replace("计算", "").replace("的结果", "").replace("只输出数字", "").strip().split()
        if len(parts) >= 3 and parts[1] == "+":
            return str(int(parts[0]) + int(parts[2]))
        return "0"

class ToolUsingAgent(BaseAgent):
    """模拟调用工具:从prompt中解析操作并调用对应工具"""
    def execute(self, prompt: str, tools: List[Callable]) -> str:
        parts = prompt.replace("使用工具计算:", "").strip().split()
        if len(parts) >= 3:
            x, op, y = int(parts[0]), parts[1], int(parts[2])
            if op == "add" and tools:
                return str(tools[0](x, y))
            elif op == "multiply" and len(tools) > 1:
                return str(tools[1](x, y))
        return "0"

# ---------- 运行入口 ----------
if __name__ == "__main__":
    # 初始化框架
    framework = BenchmarkFramework()

    # 注册测试任务
    framework.register_task("math", MathTask(num_problems=5))
    framework.register_task("tool_call", ToolCallTask(num_calls=3))

    # 注册被测Agent
    framework.register_agent("simple_math", SimpleMathAgent())
    framework.register_agent("tool_user", ToolUsingAgent())

    # 运行基准测试
    results = framework.run_benchmark("simple_math")
    print("=== SimpleMathAgent 基准测试结果 ===")
    print(f"任务完成率: {results['completion_rate']:.0%}")
    print(f"平均准确率: {results['avg_accuracy']:.0%}")
    print(f"平均响应时间: {results['avg_response_time']:.3f}s")

    results2 = framework.run_benchmark("tool_user")
    print("\n=== ToolUsingAgent 基准测试结果 ===")
    print(f"任务完成率: {results2['completion_rate']:.0%}")
    print(f"平均准确率: {results2['avg_accuracy']:.0%}")
    print(f"平均响应时间: {results2['avg_response_time']:.3f}s")
运行与验证
- 运行方式:将上述代码保存为
benchmark_framework.py,执行python benchmark_framework.py。 - 预期输出:程序打印两个Agent的基准测试汇总指标。由于代码中使用了随机数,具体数值每次运行略有不同,但
simple_math的准确率应为100%(其逻辑直接计算加法),tool_user的准确率也应为100%(其逻辑正确调用工具)。 - 通过条件:程序无异常退出,且两个Agent的
任务完成率均为100%,平均准确率均为100%。
扩展方式
- 新增测试任务:继承
BenchmarkTask,实现run()方法,然后调用framework.register_task("新任务名", 任务实例)。 - 新增Agent:继承
BaseAgent,实现execute()方法,然后调用framework.register_agent("新Agent名", Agent实例)。 - 框架核心无需修改:注册机制保证了新增任务或Agent时,
BenchmarkFramework类本身不需要任何改动。
常见问题
- 任务未注册:运行
run_benchmark时指定的任务名或Agent名必须先通过register_*注册,否则抛出ValueError。 - 随机种子:如需复现精确结果,可在
if __name__ == "__main__"开头添加random.seed(42)固定随机数。 - 真实Agent接入:将实际Agent封装为
BaseAgent子类,在execute()中调用其推理接口即可,无需修改框架。