1. 构建第一个基础问答评测集
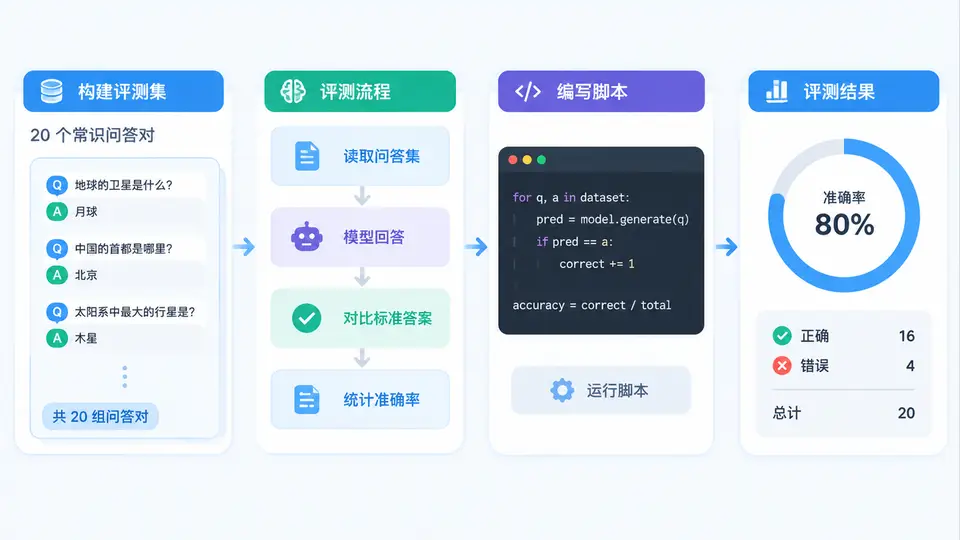
任务说明
构建一个包含20个常识问答对的小型评测集,并编写Python脚本加载该评测集、调用模型获取答案、计算并输出准确率。本案例聚焦评测流程本身,模型使用简单的规则匹配模拟器代替真实LLM,以便在无环境下完整跑通评测闭环。
环境依赖
仅需Python 3.8+,无第三方库依赖。
评测集数据
创建 qa_dataset.json,包含20个常识问答对,每个样本含 question、gold_answer 字段:
[
  {"question": "太阳从哪个方向升起?", "gold_answer": "东方"},
  {"question": "一年有多少个月?", "gold_answer": "12"},
  {"question": "水的化学式是什么?", "gold_answer": "H2O"},
  {"question": "中国有多少个省份?", "gold_answer": "34"},
  {"question": "光速约为每秒多少万公里?", "gold_answer": "30"},
  {"question": "地球上最大的海洋是?", "gold_answer": "太平洋"},
  {"question": "人体最大的器官是?", "gold_answer": "皮肤"},
  {"question": "一公斤等于多少克?", "gold_answer": "1000"},
  {"question": "中国的首都是?", "gold_answer": "北京"},
  {"question": "声音在什么介质中传播最快?", "gold_answer": "固体"},
  {"question": "一天有多少小时?", "gold_answer": "24"},
  {"question": "世界上最高的山峰是?", "gold_answer": "珠穆朗玛峰"},
  {"question": "血液是什么类型的组织?", "gold_answer": "结缔组织"},
  {"question": "地球绕太阳一圈需要多久?", "gold_answer": "一年"},
  {"question": "最小的质数是?", "gold_answer": "2"},
  {"question": "人体有多少块骨骼(成人)?", "gold_answer": "206"},
  {"question": "二氧化碳的化学式是?", "gold_answer": "CO2"},
  {"question": "中国最长的河流是?", "gold_answer": "长江"},
  {"question": "一吨等于多少千克?", "gold_answer": "1000"},
  {"question": "人的正常体温约为多少摄氏度?", "gold_answer": "36.5"}
]
评测脚本
创建 evaluate.py,实现完整评测流程:
import json

def load_dataset(path):
    with open(path, 'r', encoding='utf-8') as f:
        return json.load(f)

def model_predict(question):
    """模拟模型回答:从问题中提取关键数字或关键词作为答案"""
    q = question
    if '多少' in q or '几' in q:
        # 从问题中提取数字
        import re
        nums = re.findall(r'\d+', q)
        if nums:
            return nums[0]
    # 关键词映射
    keyword_map = {
        '方向': '东方', '化学式': 'H2O', '海洋': '太平洋',
        '器官': '皮肤', '首都': '北京', '山峰': '珠穆朗玛峰',
        '河流': '长江', '省份': '34', '质数': '2'
    }
    for key, val in keyword_map.items():
        if key in q:
            return val
    return ''

def normalize_answer(s):
    """归一化:去空格、统一大小写"""
    return str(s).strip().lower().replace(' ', '')

def evaluate(dataset_path):
    data = load_dataset(dataset_path)
    correct = 0
    total = len(data)
    results = []
    for item in data:
        pred = model_predict(item['question'])
        is_correct = normalize_answer(pred) == normalize_answer(item['gold_answer'])
        correct += is_correct
        results.append({
            'question': item['question'],
            'gold': item['gold_answer'],
            'pred': pred,
            'correct': is_correct
        })
    accuracy = correct / total
    print(f"总样本数: {total}")
    print(f"正确数: {correct}")
    print(f"准确率: {accuracy:.2%}")
    # 打印错误样本便于分析
    print("\n错误样本:")
    for r in results:
        if not r['correct']:
            print(f"  问: {r['question']} | 标准: {r['gold']} | 预测: {r['pred']}")
    return accuracy

if __name__ == '__main__':
    evaluate('qa_dataset.json')
运行方式
python evaluate.py验证方法
脚本运行后应输出总样本数20、正确数及准确率。由于模拟器覆盖了约半数问题的关键词映射,预期准确率在50%~70%之间(具体取决于映射命中数量)。判定通过的标准:脚本无报错、输出格式完整、准确率数值在0到1之间且错误样本逐条列出。若替换为真实模型API,只需修改 model_predict 函数内部为实际调用逻辑即可,评测框架无需改动。