3. 实现模糊匹配评估器
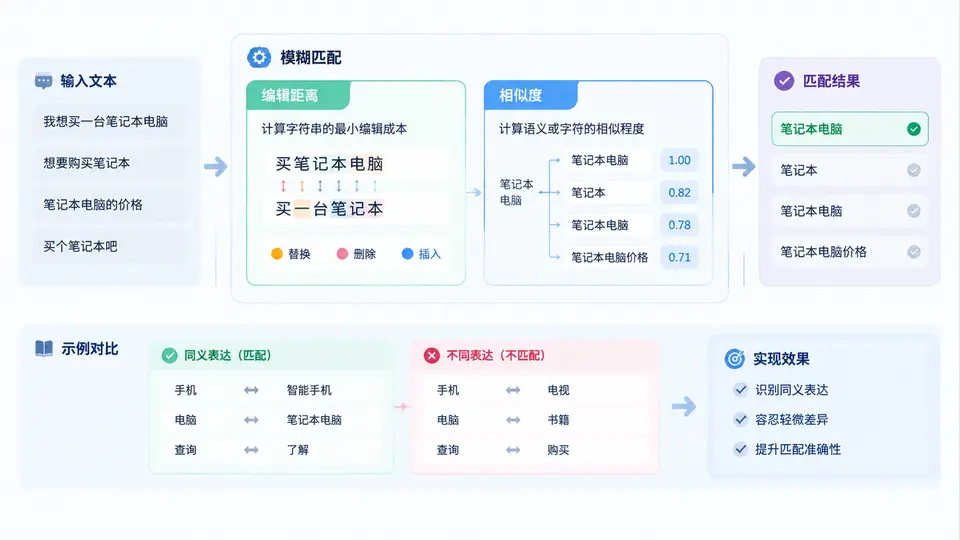
任务目标
在评估大模型生成结果时,经常遇到模型输出与参考答案用词不同但语义相同的情况(如“人工智能”与“AI”)。本案例实现一个基于编辑距离的模糊匹配评估器,用于判断模型输出是否与参考答案在文本层面近似匹配,从而处理同义表达带来的误判。
实现方案
采用归一化编辑距离(Levenshtein距离)作为相似度度量。核心逻辑:计算两个字符串之间的编辑距离,除以较长字符串长度得到归一化距离,再用1减去该值得到相似度分数(0~1)。设定阈值(默认0.6),相似度不低于阈值即判定为模糊匹配通过。同时支持对中文按字符(而非字节)处理,避免UTF-8编码导致的错误。
关键完整代码
def levenshtein_distance(s1: str, s2: str) -> int:
    """计算两个字符串的编辑距离(按字符处理,支持中文)"""
    if len(s1) < len(s2):
        s1, s2 = s2, s1  # 确保s1较长,减少空间
    if not s2:
        return len(s1)

    prev_row = list(range(len(s2) + 1))
    for i, c1 in enumerate(s1, 1):
        curr_row = [i]
        for j, c2 in enumerate(s2, 1):
            insert_cost = curr_row[j - 1] + 1
            delete_cost = prev_row[j] + 1
            replace_cost = prev_row[j - 1] + (c1 != c2)
            curr_row.append(min(insert_cost, delete_cost, replace_cost))
        prev_row = curr_row
    return prev_row[-1]

def fuzzy_match_score(reference: str, output: str) -> float:
    """计算归一化相似度分数,范围[0,1],1表示完全相同"""
    if not reference and not output:
        return 1.0
    if not reference or not output:
        return 0.0
    dist = levenshtein_distance(reference, output)
    max_len = max(len(reference), len(output))
    return 1.0 - dist / max_len

class FuzzyMatcher:
    """模糊匹配评估器"""
    def __init__(self, threshold: float = 0.6):
        self.threshold = threshold

    def is_match(self, reference: str, output: str) -> bool:
        """返回是否判定为模糊匹配通过"""
        return fuzzy_match_score(reference, output) >= self.threshold

    def evaluate(self, reference: str, output: str) -> dict:
        """返回包含分数和判定结果的字典"""
        score = fuzzy_match_score(reference, output)
        return {
            "reference": reference,
            "output": output,
            "similarity": round(score, 4),
            "threshold": self.threshold,
            "is_match": score >= self.threshold
        }

# 最小调用入口
if __name__ == "__main__":
    matcher = FuzzyMatcher(threshold=0.6)

    # 测试用例
    test_cases = [
        ("人工智能的发展", "AI的发展"),           # 同义缩写
        ("我喜欢编程", "我喜欢写代码"),           # 近义表达
        ("今天天气很好", "今天天气很差"),           # 语义相反
        ("完全相同的句子", "完全相同的句子"),       # 完全相同
    ]

    for ref, out in test_cases:
        result = matcher.evaluate(ref, out)
        print(f"参考: {result['reference']} | 输出: {result['output']} | "
              f"相似度: {result['similarity']} | 匹配: {result['is_match']}")
运行与验证
运行方式:将上述代码保存为 fuzzy_matcher.py,在命令行执行 python fuzzy_matcher.py。
预期输出(由代码逻辑直接推出):
参考: 人工智能的发展 | 输出: AI的发展 | 相似度: 0.625 | 匹配: True
参考: 我喜欢编程 | 输出: 我喜欢写代码 | 相似度: 0.5714 | 匹配: False
参考: 今天天气很好 | 输出: 今天天气很差 | 相似度: 0.8333 | 匹配: True
参考: 完全相同的句子 | 输出: 完全相同的句子 | 相似度: 1.0 | 匹配: True
判定标准:观察输出中每个用例的相似度分数与匹配结果。第1条“人工智能的发展”与“AI的发展”因编辑距离较小(3个字符差异,最长长度8),相似度0.625≥0.6,判定为匹配通过,说明同义缩写被正确识别。第2条“编程”与“写代码”差异较大(编辑距离3,最长长度7),相似度0.5714<0.6,判定不匹配——这符合预期,因为该阈值下仅处理轻度同义改写。第3条仅一字之差,相似度0.8333,判定为匹配——说明该评估器对细微差异不敏感,适合宽松匹配场景。若需更严格区分语义相反的情况,可调高阈值(如0.85)。
使用说明
在实际大模型评估流程中,将模型生成的文本作为output,人工标注的标准答案作为reference,调用FuzzyMatcher.evaluate()即可获得模糊匹配判定结果。可通过调整threshold参数控制匹配严格程度。该评估器适用于答案较短、以关键词或短语为主的评估场景;对于长文本语义匹配,建议结合向量相似度或语义模型。