1. 构建自定义评估数据集
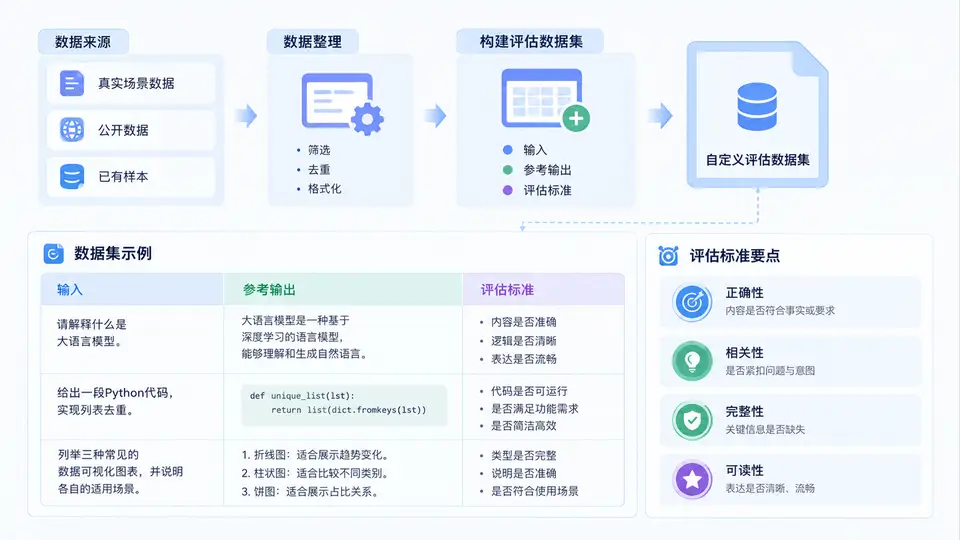
任务目标
构建一个用于大模型评估实验的小型自定义数据集。数据集包含三个核心字段:输入(模型待处理的提示)、参考输出(理想答案或基准答案)、评估标准(针对该样本的评分维度与判定说明)。该数据集将作为后续评估实验的统一输入格式。
数据集格式设计
采用 JSON 格式存储,每个样本包含以下字段:
id:样本唯一标识input:发送给模型的提示文本reference_output:期望的理想输出,用于与模型生成结果对比eval_criteria:评估该样本时使用的具体标准,包含评分维度与通过条件
完整实现代码
import json
from typing import List, Dict

def create_eval_dataset() -> List[Dict]:
    """创建包含输入、参考输出和评估标准的小型评估数据集。"""
    dataset = [
        {
            "id": "sample_001",
            "input": "请用一句话解释什么是梯度消失。",
            "reference_output": "梯度消失是指在深度神经网络反向传播过程中,梯度随层数增加而指数级减小,导致浅层参数难以更新的现象。",
            "eval_criteria": {
                "dimensions": ["准确性", "简洁性"],
                "pass_condition": "必须包含'反向传播'和'梯度减小'两个关键概念,且不超过30个字。"
            }
        },
        {
            "id": "sample_002",
            "input": "将以下句子翻译成英文:'机器学习是人工智能的一个分支。'",
            "reference_output": "Machine learning is a branch of artificial intelligence.",
            "eval_criteria": {
                "dimensions": ["翻译准确性", "语法正确性"],
                "pass_condition": "核心术语'machine learning'和'artificial intelligence'必须正确,语法无错误。"
            }
        },
        {
            "id": "sample_003",
            "input": "给定数字列表 [3, 1, 4, 1, 5],请返回排序后的结果。",
            "reference_output": "[1, 1, 3, 4, 5]",
            "eval_criteria": {
                "dimensions": ["结果正确性"],
                "pass_condition": "输出必须与参考输出完全一致,包括顺序和格式。"
            }
        },
        {
            "id": "sample_004",
            "input": "请列出深度学习中常用的三种激活函数。",
            "reference_output": "ReLU、Sigmoid、Tanh",
            "eval_criteria": {
                "dimensions": ["完整性", "准确性"],
                "pass_condition": "必须包含ReLU、Sigmoid、Tanh中的至少两个,且不能包含错误函数名。"
            }
        }
    ]
    return dataset

def save_dataset(dataset: List[Dict], filepath: str = "eval_dataset.json") -> None:
    """将数据集保存为JSON文件。"""
    with open(filepath, "w", encoding="utf-8") as f:
        json.dump(dataset, f, ensure_ascii=False, indent=2)
    print(f"数据集已保存至: {filepath}")

def load_dataset(filepath: str = "eval_dataset.json") -> List[Dict]:
    """从JSON文件加载数据集。"""
    with open(filepath, "r", encoding="utf-8") as f:
        return json.load(f)

if __name__ == "__main__":
    # 创建并保存数据集
    data = create_eval_dataset()
    save_dataset(data)

    # 验证:加载并打印样本数量与首条记录
    loaded = load_dataset()
    print(f"数据集样本总数: {len(loaded)}")
    print(f"首条样本ID: {loaded[0]['id']}")
    print(f"字段完整性验证: {all(all(k in item for k in ['id', 'input', 'reference_output', 'eval_criteria']) for item in loaded)}")
运行与验证方法
- 运行环境:Python 3.6+,无需额外安装第三方库(仅使用标准库
json)。 - 执行方式:将上述代码保存为
build_dataset.py,在终端运行python build_dataset.py。 - 通过条件:程序正常结束,控制台输出以下信息即表示数据集构建成功:
- 输出
数据集已保存至: eval_dataset.json - 输出
数据集样本总数: 4 - 输出
首条样本ID: sample_001 - 输出
字段完整性验证: True
- 输出
- 产物检查:打开生成的
eval_dataset.json文件,确认每个样本均包含id、input、reference_output、eval_criteria四个字段,且eval_criteria内含dimensions与pass_condition子字段。
后续使用说明
该数据集文件 eval_dataset.json 即为后续评估实验的标准输入。评估时,将每个样本的 input 发送给待测模型,获取模型输出后,依据 reference_output 和 eval_criteria 进行打分或判定。如需扩展数据集,按相同字段结构向列表中添加新字典即可。