3. LoRA秩的选择
任务目标
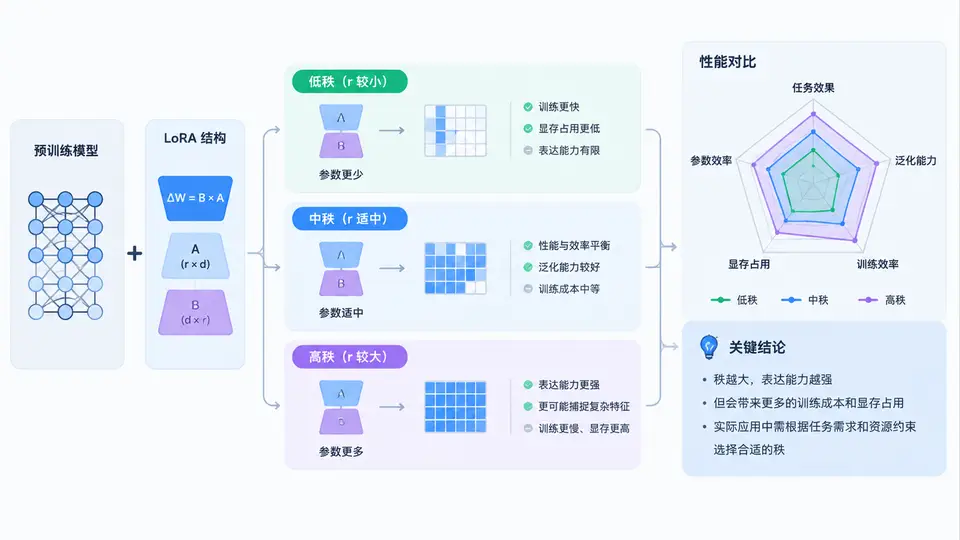
本案例通过控制LoRA的秩(rank)参数,在固定数据集和训练配置下对比不同秩对模型微调效果的影响。你将使用Hugging Face PEFT库对bert-base-uncased进行LoRA微调,在AG News测试集上评估并比较秩为1、4、16时的分类准确率,从而建立秩与模型容量/性能之间关系的直观认识。
环境与依赖
需要安装以下Python包:
pip install transformers datasets peft evaluate torch完整实现代码
import torch
from datasets import load_dataset
from transformers import (
    AutoTokenizer,
    AutoModelForSequenceClassification,
    TrainingArguments,
    Trainer,
    DataCollatorWithPadding,
)
from peft import LoraConfig, get_peft_model, TaskType
import evaluate
import numpy as np

# 1. 加载数据集(使用AG News子集加速实验)
dataset = load_dataset("ag_news", split="train[:2000]")
test_dataset = load_dataset("ag_news", split="test[:500]")

# 2. 加载tokenizer和基础模型
model_name = "bert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_fn(examples):
    return tokenizer(examples["text"], truncation=True, max_length=128)

tokenized_train = dataset.map(tokenize_fn, batched=True, remove_columns=["text"])
tokenized_test = test_dataset.map(tokenize_fn, batched=True, remove_columns=["text"])
data_collator = DataCollatorWithPadding(tokenizer=tokenizer)

# 3. 定义评估指标
accuracy = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    predictions, labels = eval_pred
    preds = np.argmax(predictions, axis=1)
    return accuracy.compute(predictions=preds, references=labels)

# 4. 实验不同秩
def train_with_rank(rank):
    model = AutoModelForSequenceClassification.from_pretrained(
        model_name, num_labels=4
    )

    # 配置LoRA
    lora_config = LoraConfig(
        task_type=TaskType.SEQ_CLS,
        r=rank,
        lora_alpha=rank * 2,  # 保持alpha/r=2的常见比例
        target_modules=["query", "value"],
        lora_dropout=0.1,
    )
    peft_model = get_peft_model(model, lora_config)

    # 训练参数(统一配置保证公平对比)
    training_args = TrainingArguments(
        output_dir=f"./lora_rank_{rank}",
        learning_rate=2e-4,
        per_device_train_batch_size=16,
        per_device_eval_batch_size=32,
        num_train_epochs=2,
        evaluation_strategy="epoch",
        save_strategy="no",
        logging_dir=f"./logs_rank_{rank}",
        report_to=[],
        disable_tqdm=True,
    )

    trainer = Trainer(
        model=peft_model,
        args=training_args,
        train_dataset=tokenized_train,
        eval_dataset=tokenized_test,
        tokenizer=tokenizer,
        data_collator=data_collator,
        compute_metrics=compute_metrics,
    )

    trainer.train()
    eval_result = trainer.evaluate()

    # 统计可训练参数量
    trainable_params = sum(p.numel() for p in peft_model.parameters() if p.requires_grad)
    total_params = sum(p.numel() for p in peft_model.parameters())

    return {
        "rank": rank,
        "eval_accuracy": eval_result["eval_accuracy"],
        "trainable_params": trainable_params,
        "trainable_ratio": trainable_params / total_params,
    }

# 5. 运行实验
if __name__ == "__main__":
    results = []
    for r in [1, 4, 16]:
        print(f"正在训练 rank={r} ...")
        result = train_with_rank(r)
        results.append(result)
        print(f"rank={r} 完成,准确率: {result['eval_accuracy']:.4f}")

    # 打印汇总
    print("\n===== 实验结果汇总 =====")
    for res in results:
        print(f"rank={res['rank']:2d} | 准确率: {res['eval_accuracy']:.4f} | "
              f"可训练参数: {res['trainable_params']:,} ({res['trainable_ratio']:.2%})")
运行方式
将上述代码保存为lora_rank_experiment.py,直接运行:
python lora_rank_experiment.py程序会依次训练三个不同秩的LoRA模型,每个模型训练2个epoch(使用2000条训练样本),并在500条测试样本上评估。总运行时间取决于GPU性能,CPU环境下约需15-30分钟。
验证方法与判定标准
实验完成后,观察终端输出的汇总表格。判定实验有效的标准:
- 三个秩的模型均成功完成训练且无报错;
- 每个秩都输出了eval_accuracy值,且数值在合理范围(AG News四分类随机基线为25%,有效微调应显著高于此值);
- 可训练参数比例随秩增大而增加(rank=1时约0.1%,rank=16时约1%左右),且远低于全量微调(100%);
- 预期可观察到:秩增大通常带来准确率提升,但提升幅度递减——rank从1到4的提升明显,从4到16的提升可能较小甚至持平,这体现了低秩瓶颈效应。
注意:由于使用数据子集且训练轮次较少,具体准确率数值会与完整实验不同,但上述趋势应可复现。若rank=1与rank=16的准确率差异小于0.5个百分点,说明当前任务对秩不敏感,可尝试增大训练数据量或使用更复杂的任务验证差异。
关键说明
本实验固定了lora_alpha/r=2的比例,这是PEFT库的常见默认设置。实际应用中,调整秩的同时也可独立调整alpha值来改变LoRA更新的缩放幅度。若需观察更明显的性能差异,可将训练数据增至10000条并训练3个epoch,但会相应增加运行时间。