1. LoRA基础入门
任务说明
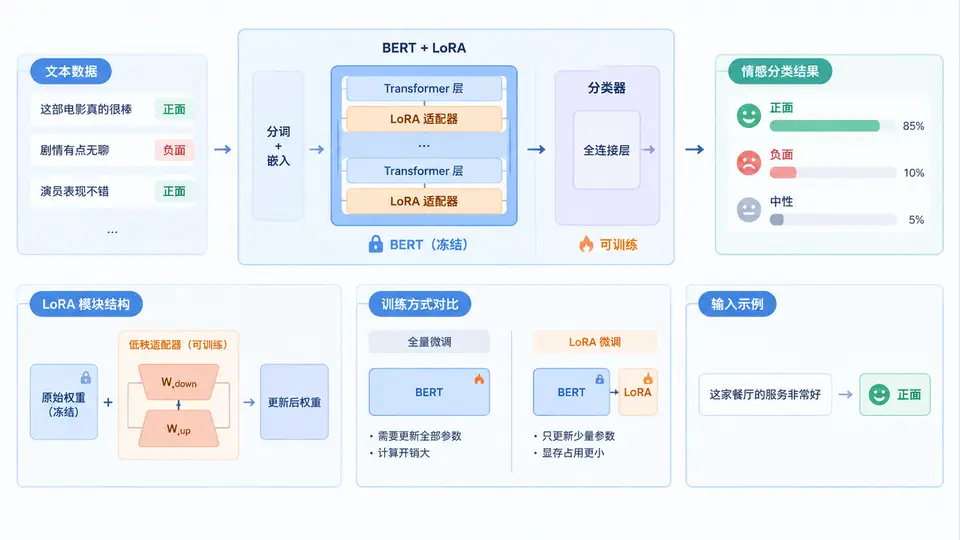
本案例在BERT-base-uncased模型上实现LoRA微调,完成IMDb电影评论情感二分类任务。通过本案例掌握LoRA的核心操作:冻结预训练参数、注入低秩适配器、仅训练适配器参数完成下游任务微调。
环境依赖
pip install torch transformers datasets peft scikit-learn完整实现代码
import torch
from torch.utils.data import DataLoader
from transformers import (
    AutoTokenizer,
    AutoModelForSequenceClassification,
    AdamW,
    get_linear_schedule_with_warmup,
)
from datasets import load_dataset
from peft import LoraConfig, get_peft_model, TaskType
from sklearn.metrics import accuracy_score
import numpy as np

# ========== 1. 加载数据与tokenizer ==========
dataset = load_dataset("imdb", split="train[:2000]").train_test_split(test_size=0.2, seed=42)
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

def tokenize_fn(examples):
    return tokenizer(examples["text"], truncation=True, padding="max_length", max_length=256)

tokenized = dataset.map(tokenize_fn, batched=True)
tokenized = tokenized.remove_columns(["text"])
tokenized = tokenized.rename_column("label", "labels")
tokenized.set_format("torch")

train_loader = DataLoader(tokenized["train"], batch_size=8, shuffle=True)
eval_loader = DataLoader(tokenized["test"], batch_size=8)

# ========== 2. 加载BERT并注入LoRA ==========
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased", num_labels=2)

lora_config = LoraConfig(
    task_type=TaskType.SEQ_CLS,
    r=8,                # 低秩矩阵的秩
    lora_alpha=16,      # 缩放系数
    target_modules=["query", "value"],  # 仅对attention的q/v注入LoRA
    lora_dropout=0.1,
)

model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # 预期输出: trainable params: 884,736 / all params: 109,485,570

# ========== 3. 训练配置 ==========
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)

optimizer = AdamW(model.parameters(), lr=2e-5)
total_steps = len(train_loader) * 3  # 3 epochs
scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=total_steps)

# ========== 4. 训练循环 ==========
model.train()
for epoch in range(3):
    total_loss = 0
    for batch in train_loader:
        batch = {k: v.to(device) for k, v in batch.items()}
        outputs = model(**batch)
        loss = outputs.loss
        total_loss += loss.item()

        loss.backward()
        optimizer.step()
        scheduler.step()
        optimizer.zero_grad()

    avg_loss = total_loss / len(train_loader)
    print(f"Epoch {epoch+1}/3 - loss: {avg_loss:.4f}")

# ========== 5. 评估 ==========
model.eval()
all_preds, all_labels = [], []
with torch.no_grad():
    for batch in eval_loader:
        batch = {k: v.to(device) for k, v in batch.items()}
        logits = model(**batch).logits
        preds = torch.argmax(logits, dim=-1)
        all_preds.extend(preds.cpu().numpy())
        all_labels.extend(batch["labels"].cpu().numpy())

acc = accuracy_score(all_labels, all_preds)
print(f"Test accuracy: {acc:.4f}")
运行方式
python lora_bert_imdb.py验证方法与通过条件
- 参数冻结验证:运行代码时,
print_trainable_parameters()应输出可训练参数约88.5万(仅占全部参数0.8%),证明BERT原始参数被冻结,只有LoRA注入的矩阵参与训练。 - 训练收敛验证:3个epoch内loss应从约0.7逐步下降至0.4以下(使用2000条训练子集)。
- 任务完成验证:测试集(400条)准确率应达到80%以上。若准确率低于75%,可增加训练数据量至5000条或增加epoch至5。
关键说明
- 本案例使用IMDb前2000条样本作为演示,完整数据集为25000条,如需更高精度可移除
[:2000]切片使用全量数据。 - LoRA仅注入到
query和value层,这是最常用的配置;如需注入key或output层,修改target_modules列表即可。 - 训练时仅LoRA参数更新梯度,原始BERT权重保持冻结,因此显存占用和训练时间远低于全量微调。