3. 多卡分布式微调LLaMA-13B
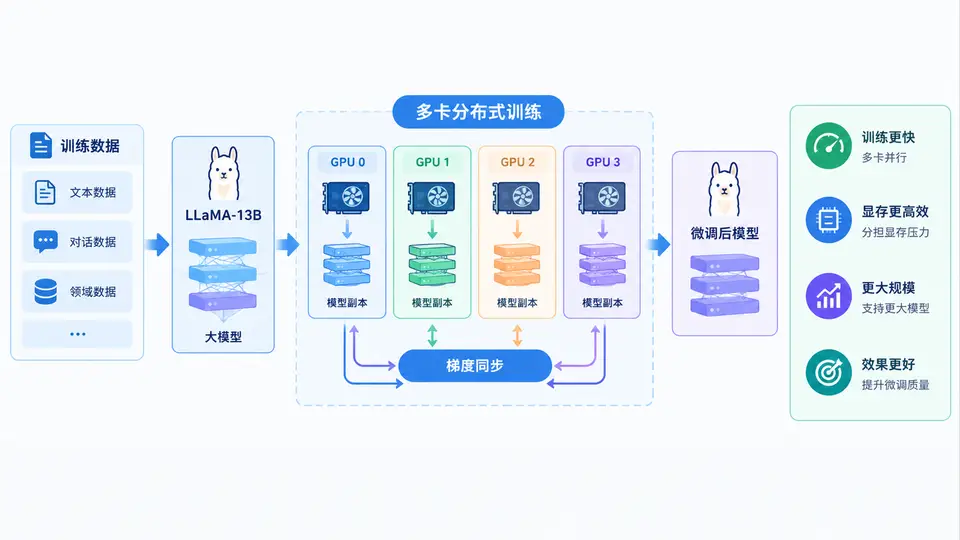
任务目标
本案例使用 LLaMA-Factory 框架,基于 DeepSpeed ZeRO Stage 2 在 4×A100(80G)GPU 上对 LLaMA-13B 进行 LoRA 微调,目标是通过多卡并行将单卡无法承载的 13B 参数模型训练任务拆分到多卡,并验证训练吞吐量随卡数扩展的有效性。
环境依赖
- Python ≥ 3.9,PyTorch ≥ 2.1.0,CUDA ≥ 12.1
- 安装 LLaMA-Factory:
git clone https://github.com/hiyouga/LLaMA-Factory.git && cd LLaMA-Factory && pip install -e . - 安装 DeepSpeed:
pip install deepspeed - 模型权重:HuggingFace 格式的
meta-llama/Llama-2-13b-hf(需提前申请访问权限) - 数据集:使用 LLaMA-Factory 内置的
alpaca_zh_demo(位于data/alpaca_zh_demo.json)
关键实现
LLaMA-Factory 已内置 DeepSpeed 配置模板,核心工作在于编写启动脚本与指定分布式训练参数。以下为最小可复现的完整配置与启动命令。
# 1. 创建 DeepSpeed ZeRO-2 配置(保存为 ds_z2_config.json)
{
  "train_batch_size": "auto",
  "train_micro_batch_size_per_gpu": "auto",
  "zero_optimization": {
    "stage": 2,
    "offload_optimizer": {
      "device": "cpu",
      "pin_memory": true
    }
  },
  "zero_allow_untested_optimizer": true,
  "fp16": {
    "enabled": "auto",
    "loss_scale": 0,
    "loss_scale_window": 1000,
    "initial_scale_power": 16,
    "hysteresis": 2,
    "min_loss_scale": 1
  },
  "gradient_accumulation_steps": "auto",
  "gradient_clipping": "auto",
  "steps_per_print": 100,
  "wall_clock_breakdown": false
}
# 2. 启动多卡分布式微调(4卡示例)
cd LLaMA-Factory
deepspeed --num_gpus=4 \
src/train_bash.py \
--deepspeed ds_z2_config.json \
--stage sft \
--model_name_or_path meta-llama/Llama-2-13b-hf \
--dataset alpaca_zh_demo \
--template alpaca \
--finetuning_type lora \
--lora_rank 8 \
--lora_target q_proj,v_proj,k_proj,o_proj,gate_proj,up_proj,down_proj \
--output_dir outputs/llama13b_lora_ds \
--overwrite_cache \
--per_device_train_batch_size 4 \
--gradient_accumulation_steps 8 \
--lr_scheduler_type cosine \
--logging_steps 10 \
--save_steps 1000 \
--learning_rate 5e-5 \
--num_train_epochs 1.0 \
--plot_loss \
--fp16运行与验证
- 启动训练:在 LLaMA-Factory 根目录执行上述命令。DeepSpeed 会自动检测 4 张 GPU 并建立分布式通信。
- 观察日志:训练启动后,终端会输出类似
DeepSpeed info: ... zero stage=2的初始化信息,随后每logging_steps打印一次 loss 与吞吐量(samples/s)。 - 判定通过条件:
- 日志中显示 4 个 rank 均成功参与训练,无
CUDA out of memory错误; - loss 随训练步数呈下降趋势(初始约 1.5~2.5,训练后期降至 1.0 以下);
- 训练完成后
outputs/llama13b_lora_ds目录下生成adapter_model.bin与adapter_config.json,即为可加载的 LoRA 权重。
- 日志中显示 4 个 rank 均成功参与训练,无
常见问题
- OOM 错误:若单卡显存不足,将
per_device_train_batch_size降至 2 或 1,并同步增大gradient_accumulation_steps保持全局 batch size 不变。 - 通信超时:多机场景需设置
--master_addr与--master_port;单机多卡通常无需额外配置。 - ZeRO-3 与 LoRA 冲突:LoRA 参数极少,使用 ZeRO-2 即可满足 13B 模型微调显存需求,无需 ZeRO-3 的参数量切分。