1. 环境搭建与数据准备
任务目标
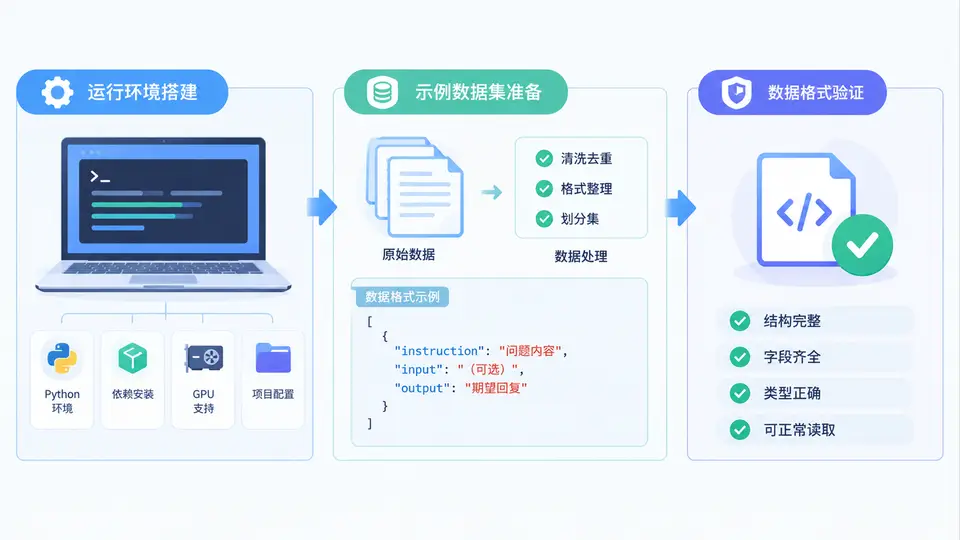
本案例完成两项工作:一是搭建LLaMA-Factory的Python运行环境并验证安装成功;二是构造一个用于微调的示例数据集(JSON格式),并校验其结构符合LLaMA-Factory的输入规范。
环境依赖
- 操作系统:Linux / macOS / Windows(WSL2)
- Python版本:3.10+
- CUDA(可选):如需GPU训练需安装对应版本驱动与CUDA Toolkit
环境搭建与验证
创建虚拟环境并安装LLaMA-Factory及其依赖:
python -m venv llama_env
source llama_env/bin/activate  # Windows: llama_env\Scripts\activate
pip install llama-factory==0.9.1
验证安装:
llamafactory-cli version若输出包含版本号(如 0.9.1),说明安装成功。若命令不可用,可尝试 python -m llamafactory.cli version。
示例数据集准备
LLaMA-Factory的微调数据格式支持多种对话模板,本案例采用最常用的 alpaca 格式。每条数据包含 instruction(指令)、input(可选输入)和 output(期望输出)。
创建文件 data/example_data.json,内容如下:
[
  {
    "instruction": "将以下句子翻译成英文:",
    "input": "今天天气很好。",
    "output": "The weather is nice today."
  },
  {
    "instruction": "总结下面这段文字的主旨。",
    "input": "人工智能正在改变医疗行业,通过图像识别辅助诊断、个性化治疗方案设计以及药物研发加速等方式,提高医疗效率和准确性。",
    "output": "人工智能通过图像识别、个性化治疗和药物研发等方式提升医疗行业的效率与准确性。"
  },
  {
    "instruction": "写一句关于春天的诗。",
    "input": "",
    "output": "春风又绿江南岸,明月何时照我还。"
  }
]
数据格式验证
运行以下Python脚本校验数据格式是否符合LLaMA-Factory要求:
import json

with open("data/example_data.json", "r", encoding="utf-8") as f:
    data = json.load(f)

assert isinstance(data, list), "数据必须是JSON数组"
for i, item in enumerate(data):
    assert isinstance(item, dict), f"第{i}条数据必须是对象"
    assert "instruction" in item and isinstance(item["instruction"], str), f"第{i}条缺少instruction字段"
    assert "output" in item and isinstance(item["output"], str), f"第{i}条缺少output字段"
    if "input" not in item:
        item["input"] = ""  # 自动补全缺失的input字段
    assert isinstance(item["input"], str), f"第{i}条的input字段必须是字符串"

print(f"验证通过:共{len(data)}条数据,格式正确。")
# 输出修正后的数据(如需覆盖原文件可取消下一行注释)
# with open("data/example_data.json", "w", encoding="utf-8") as f:
#     json.dump(data, f, ensure_ascii=False, indent=2)
运行方式:
python validate_data.py若输出 验证通过:共3条数据,格式正确。,则说明数据已准备好,可被LLaMA-Factory的 --dataset 参数直接引用。
验证路径与通过条件
- 环境验证:
llamafactory-cli version能输出版本号。 - 数据验证:上述脚本无异常输出,且打印“验证通过”。
- 集成验证(可选):在LLaMA-Factory的
data/dataset_info.json中注册该数据集(添加键example_data,指向文件路径),然后运行llamafactory-cli train --model_name_or_path Qwen/Qwen2-0.5B --dataset example_data ...,若开始加载数据且无格式报错,则说明数据与框架完全兼容。
常见问题
- 安装缓慢或超时:使用国内镜像源
pip install llama-factory -i https://pypi.tuna.tsinghua.edu.cn/simple。 - JSON解析错误:检查文件编码是否为UTF-8,且无多余逗号。
- 缺少input字段:LLaMA-Factory允许省略input,但脚本会自动补空字符串,不影响训练。