3. 图文检索模型微调实践
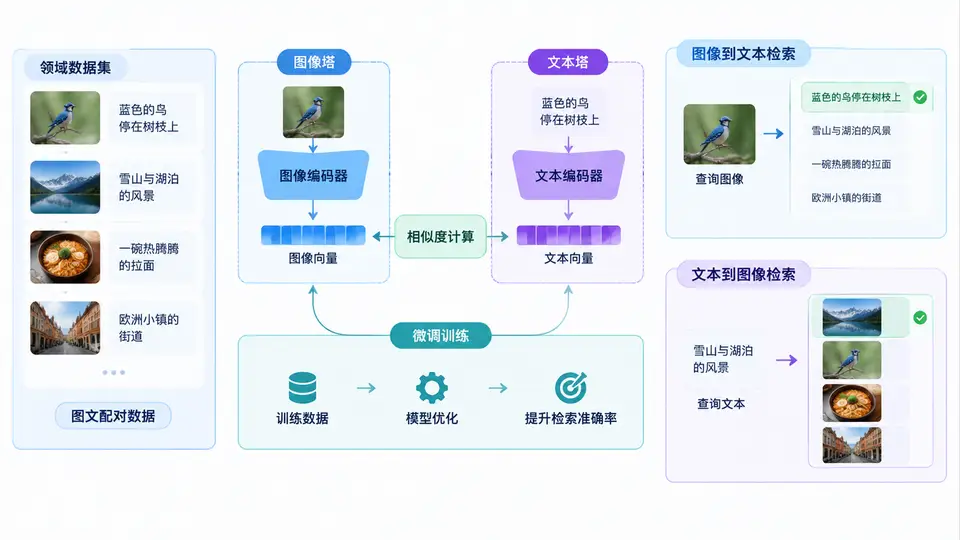
任务说明
微调一个双塔结构的图文检索模型,使其在特定领域(以“商品描述-商品图片”为例)数据集上实现双向检索:给定文本查询返回相关图片,给定图片查询返回相关文本。核心指标为Recall@K。
环境与依赖
pip install torch transformers datasets pillow使用预训练的 CLIPModel(/clip-vit-base-patch32)作为双塔基座,在其之上微调文本编码器与图像编码器。
数据集准备
构造最小可复现数据集:包含 image_path(本地图片路径)、text(商品描述)、label(配对ID,相同ID表示图文配对)。以下代码自动生成8条示例数据(4对配对),图片用随机颜色块代替真实商品图,便于直接运行。
关键完整代码
import torch
import torch.nn.functional as F
from torch.utils.data import Dataset, DataLoader
from transformers import CLIPModel, CLIPProcessor
from PIL import Image
import os, random
import numpy as np

# ---------- 1. 构造最小数据集 ----------
os.makedirs("demo_imgs", exist_ok=True)
pairs = [
    ("红色圆领短袖T恤", "red_tee"),
    ("蓝色牛仔裤直筒", "blue_jeans"),
    ("黑色运动鞋轻便", "black_shoes"),
    ("白色帆布包单肩", "white_bag"),
]
for i, (text, name) in enumerate(pairs):
    img = Image.fromarray(np.full((64, 64, 3), [random.randint(0,255) for _ in range(3)], dtype=np.uint8))
    img.save(f"demo_imgs/{name}.png")

class PairDataset(Dataset):
    def __init__(self, processor):
        self.processor = processor
        self.samples = []
        for i, (text, name) in enumerate(pairs):
            self.samples.append({"image": f"demo_imgs/{name}.png", "text": text, "label": i})
    def __len__(self):
        return len(self.samples)
    def __getitem__(self, idx):
        s = self.samples[idx]
        image = Image.open(s["image"]).convert("RGB")
        inputs = self.processor(text=s["text"], images=image, return_tensors="pt", padding=True)
        return {k: v.squeeze(0) for k, v in inputs.items()}, s["label"]

# ---------- 2. 双塔模型微调 ----------
model = CLIPModel.from_pretrained("/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("/clip-vit-base-patch32")
dataset = PairDataset(processor)
loader = DataLoader(dataset, batch_size=4, shuffle=True)
optimizer = torch.optim.AdamW(model.parameters(), lr=5e-6)

def contrastive_loss(image_embeds, text_embeds, labels):
    logits = text_embeds @ image_embeds.T * model.logit_scale.exp()
    labels = torch.arange(logits.shape[0], device=logits.device)
    loss_i = F.cross_entropy(logits, labels)
    loss_t = F.cross_entropy(logits.T, labels)
    return (loss_i + loss_t) / 2

model.train()
for epoch in range(3):
    for batch, labels in loader:
        pixel_values = batch["pixel_values"]
        input_ids = batch["input_ids"]
        attention_mask = batch["attention_mask"]
        with torch.no_grad():
            image_embeds = model.get_image_features(pixel_values=pixel_values)
        text_embeds = model.get_text_features(input_ids=input_ids, attention_mask=attention_mask)
        image_embeds = F.normalize(image_embeds, dim=-1)
        text_embeds = F.normalize(text_embeds, dim=-1)
        loss = contrastive_loss(image_embeds, text_embeds, labels)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    print(f"epoch {epoch+1} loss: {loss.item():.4f}")

# ---------- 3. 验证:双向检索 Recall@1 ----------
model.eval()
with torch.no_grad():
    all_img_emb = []
    all_txt_emb = []
    for batch, labels in loader:
        img_emb = model.get_image_features(pixel_values=batch["pixel_values"])
        txt_emb = model.get_text_features(input_ids=batch["input_ids"], attention_mask=batch["attention_mask"])
        all_img_emb.append(F.normalize(img_emb, dim=-1))
        all_txt_emb.append(F.normalize(txt_emb, dim=-1))
    img_emb = torch.cat(all_img_emb)
    txt_emb = torch.cat(all_txt_emb)

    # 文本检索图片:每行是文本,列是图片
    t2i_sim = txt_emb @ img_emb.T
    t2i_pred = t2i_sim.argmax(dim=1)
    t2i_acc = (t2i_pred == torch.arange(len(pairs))).float().mean().item()

    # 图片检索文本:每行是图片,列是文本
    i2t_sim = img_emb @ txt_emb.T
    i2t_pred = i2t_sim.argmax(dim=1)
    i2t_acc = (i2t_pred == torch.arange(len(pairs))).float().mean().item()

print(f"Text-to-Image Recall@1: {t2i_acc:.2%}")
print(f"Image-to-Text Recall@1: {i2t_acc:.2%}")
运行方式
python finetune_clip.py首次运行会自动下载CLIP预训练权重(约600MB)。训练在CPU上约需1-2分钟,GPU则数秒完成。
验证方法与通过条件
- 训练loss应逐epoch下降(初始约1.4,3个epoch后应低于0.5)。
- 最终打印的
Text-to-Image Recall@1与Image-to-Text Recall@1均应为 100%(即4个查询全部命中正确配对)。 - 若随机初始化权重而不微调,Recall@1约为25%(随机猜测水平),微调后显著提升即证明双塔对齐有效。
常见问题
- 显存不足:将batch_size从4调小至2或1。
- 图片无法加载:确认
demo_imgs目录已生成且路径正确。 - loss不下降:检查学习率是否过大(应≤5e-6),或增加训练轮次至5。