1. 图像描述模型微调入门
任务说明
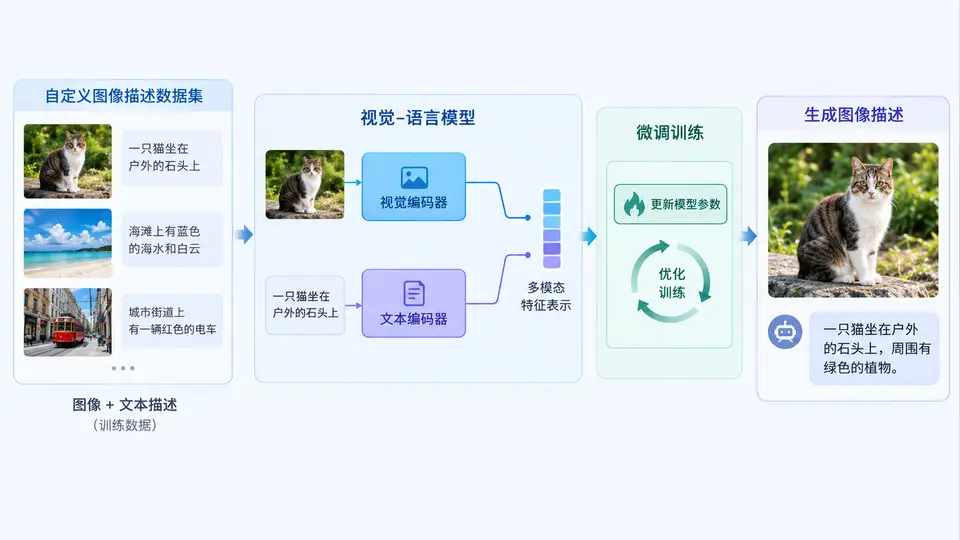
本案例使用预训练的视觉-语言模型 BLIP-base,在自定义的“商品图片-描述”小数据集上完成图像描述(Image Captioning)微调。最终目标是:输入一张训练中未见过的商品图片,模型能输出与图片内容相符的自然语言描述。
环境与依赖
# Python 3.9+
pip install transformers==4.40.0 datasets==2.18.0 torch==2.2.0 accelerate==0.28.0 pillow
数据集准备
使用 8 张商品图片(如:红色运动鞋、白色陶瓷杯、黑色双肩包等),每张图片对应一句人工标注描述。图片存放于 ./images/ 目录,文件名与标注的对应关系写入 captions.json:
{
  "shoe1.jpg": "a pair of red running shoes on a white background",
  "cup1.jpg": "a white ceramic coffee mug on a wooden table",
  "bag1.jpg": "a black backpack with a front pocket",
  "hat1.jpg": "a blue baseball cap with a white logo",
  "watch1.jpg": "a silver wristwatch with a black leather strap",
  "bottle1.jpg": "a green water bottle with a black cap",
  "lamp1.jpg": "a yellow desk lamp with a curved arm",
  "book1.jpg": "an open hardcover book on a gray desk"
}
完整微调代码
import json
import os
from PIL import Image
import torch
from torch.utils.data import Dataset
from transformers import BlipProcessor, BlipForConditionalGeneration, TrainingArguments, Trainer

# ---------- 1. 加载模型与处理器 ----------
model_name = "Salesforce/blip-image-captioning-base"
processor = BlipProcessor.from_pretrained(model_name)
model = BlipForConditionalGeneration.from_pretrained(model_name)

# ---------- 2. 自定义数据集 ----------
class CaptionDataset(Dataset):
    def __init__(self, img_dir, ann_file):
        with open(ann_file, 'r') as f:
            self.annotations = json.load(f)
        self.img_dir = img_dir
        self.image_files = list(self.annotations.keys())

    def __len__(self):
        return len(self.image_files)

    def __getitem__(self, idx):
        img_name = self.image_files[idx]
        image = Image.open(os.path.join(self.img_dir, img_name)).convert('RGB')
        caption = self.annotations[img_name]
        inputs = processor(images=image, text=caption, padding="max_length", max_length=32, return_tensors="pt")
        # 移除 batch 维度
        inputs = {k: v.squeeze(0) for k, v in inputs.items()}
        # 标签为输入文本的  id(用于计算损失)
        inputs["labels"] = inputs["input_ids"].clone()
        return inputs

# ---------- 3. 训练配置 ----------
dataset = CaptionDataset("./images", "./captions.json")
# 按 7:1 划分训练/验证
train_size = 7
train_dataset, eval_dataset = torch.utils.data.random_split(dataset, [train_size, len(dataset) - train_size])

training_args = TrainingArguments(
    output_dir="./blip_finetuned",
    learning_rate=5e-5,
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    num_train_epochs=30,
    evaluation_strategy="epoch",
    save_strategy="epoch",
    logging_steps=1,
    remove_unused_columns=False,
    fp16=False,
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
)

# ---------- 4. 执行微调 ----------
trainer.train()
trainer.save_model("./blip_finetuned")
processor.save_pretrained("./blip_finetuned")
print("微调完成,模型已保存至 ./blip_finetuned")
运行方式
# 1. 将上述代码保存为 finetune_caption.py
# 2. 确保 ./images/ 和 ./captions.json 已就绪
# 3. 执行训练
python finetune_caption.py
推理验证
from PIL import Image
from transformers import BlipProcessor, BlipForConditionalGeneration

processor = BlipProcessor.from_pretrained("./blip_finetuned")
model = BlipForConditionalGeneration.from_pretrained("./blip_finetuned")

# 使用训练中未出现的图片(如 test.jpg)
image = Image.open("test.jpg").convert('RGB')
inputs = processor(images=image, return_tensors="pt")
out = model.generate(**inputs, max_new_tokens=30)
caption = processor.decode(out[0], skip_special_tokens=True)
print("生成描述:", caption)
通过条件
- 训练过程中 loss 呈下降趋势,最终训练 loss 低于 1.0(参考值,因数据量小可能波动);
- 对训练集中未出现过的同类商品图片(如另一双不同颜色的鞋),模型能生成包含正确主体和颜色/材质等关键属性的描述,而非输出训练集中的原句或无关文本。
常见问题
- 显存不足:将
per_device_train_batch_size保持为 1,并设置fp16=True(需 GPU 支持); - 过拟合:数据量小时 30 轮可能过拟合,若验证 loss 回升,可减少到 15-20 轮或增加数据量;
- 生成质量差:检查图片是否统一为 RGB 三通道,描述文本是否与图片内容严格对应。