3. 卷积计算单元(MAC)
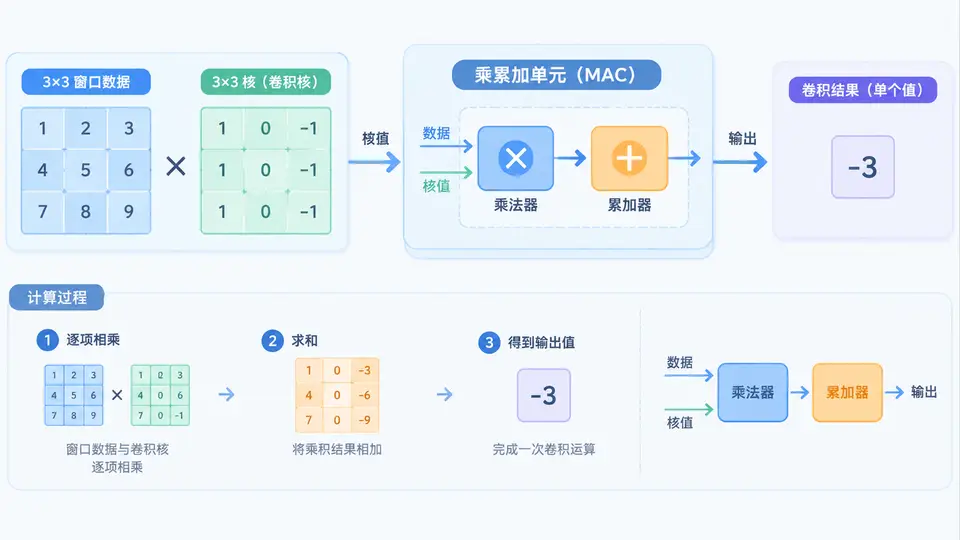
任务目标
实现一个可综合的乘累加单元(MAC),完成3×3卷积核与图像窗口的点积运算。输入为9个像素值与9个权重值,输出为单次乘累加结果。
接口定义
module mac_3x3 #(
    parameter DATA_WIDTH = 8,
    parameter ACC_WIDTH  = 24
)(
    input  wire                     clk,
    input  wire                     rst_n,
    input  wire                     valid_in,
    input  wire [DATA_WIDTH-1:0]    pixel [0:8],   // 3x3窗口像素
    input  wire [DATA_WIDTH-1:0]    weight [0:8],  // 3x3卷积核权重
    output reg                      valid_out,
    output reg  [ACC_WIDTH-1:0]     result         // 点积结果
);
核心实现
module mac_3x3 #(
    parameter DATA_WIDTH = 8,
    parameter ACC_WIDTH  = 24
)(
    input  wire                     clk,
    input  wire                     rst_n,
    input  wire                     valid_in,
    input  wire [DATA_WIDTH-1:0]    pixel [0:8],
    input  wire [DATA_WIDTH-1:0]    weight [0:8],
    output reg                      valid_out,
    output reg  [ACC_WIDTH-1:0]     result
);
    // 乘积宽度 = 8x8 = 16位,9个乘积累加最大需要 16+4 = 20位
    // ACC_WIDTH=24 留有余量,防止溢出
    reg [DATA_WIDTH*2-1:0] prod [0:8];
    reg [ACC_WIDTH-1:0]   sum;
    integer i;

    // 流水线第一级:乘法
    always @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            for (i = 0; i < 9; i = i + 1)
                prod[i] <= 0;
        end else if (valid_in) begin
            for (i = 0; i < 9; i = i + 1)
                prod[i] <= pixel[i] * weight[i];
        end
    end

    // 流水线第二级:加法树累加
    always @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            sum <= 0;
        end else begin
            // 加法树:3级并行加法
            sum <= ({ACC_WIDTH{1'b0}}, prod[0]) + ({ACC_WIDTH{1'b0}}, prod[1]) +
                   ({ACC_WIDTH{1'b0}}, prod[2]) + ({ACC_WIDTH{1'b0}}, prod[3]) +
                   ({ACC_WIDTH{1'b0}}, prod[4]) + ({ACC_WIDTH{1'b0}}, prod[5]) +
                   ({ACC_WIDTH{1'b0}}, prod[6]) + ({ACC_WIDTH{1'b0}}, prod[7]) +
                   ({ACC_WIDTH{1'b0}}, prod[8]);
        end
    end

    // 流水线第三级:输出寄存
    always @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            valid_out <= 1'b0;
            result    <= {ACC_WIDTH{1'b0}};
        end else begin
            valid_out <= valid_in;  // 两级延迟后输出有效标志
            result    <= sum;
        end
    end

endmodule
设计说明
采用三级流水线结构:第一级完成9个并行乘法,第二级通过加法树并行累加,第三级寄存输出。valid_out信号延迟两级与数据同步,保证输出时序正确。加法树使用位扩展防止累加溢出,ACC_WIDTH=24位可容纳最大结果(8位无符号数×8位无符号数×9=2^20量级)。
仿真验证
// testbench 关键片段
module tb_mac_3x3;
    reg clk = 0, rst_n = 0, valid_in = 0;
    reg [7:0] pixel [0:8], weight [0:8];
    wire valid_out;
    wire [23:0] result;

    mac_3x3 dut(.*);

    always #5 clk = ~clk;

    initial begin
        // 复位
        #20 rst_n = 1;

        // 输入:pixel = 1~9, weight = 1~9
        for (int i = 0; i < 9; i++) begin
            pixel[i] = i + 1;
            weight[i] = i + 1;
        end

        @(posedge clk);
        valid_in = 1;
        @(posedge clk);
        valid_in = 0;

        // 等待流水线输出
        #30;
        $display("result = %0d", result);
        // 预期:1*1+2*2+...+9*9 = 285
        if (result == 285 && valid_out)
            $display("TEST PASSED");
        else
            $display("TEST FAILED");
        $finish;
    end
endmodule
运行与验证
- 使用Vivado/Quartus或ModelSim/Verilator编译上述RTL与testbench;
- 运行仿真,观察波形或控制台输出;
- 通过条件:当输入pixel[i]=i+1、weight[i]=i+1时,result输出285,且valid_out在数据有效后延迟2个时钟周期拉高。
综合建议
若需提升吞吐率,可将乘法级与加法级之间插入额外寄存器;若资源紧张,可改为串行累加(需9个周期)。本设计为全并行结构,单周期完成一次3×3点积,适合作为卷积流水线的核心计算单元。