2. 算法方案选型中的基线、启发式与学习型方法对比
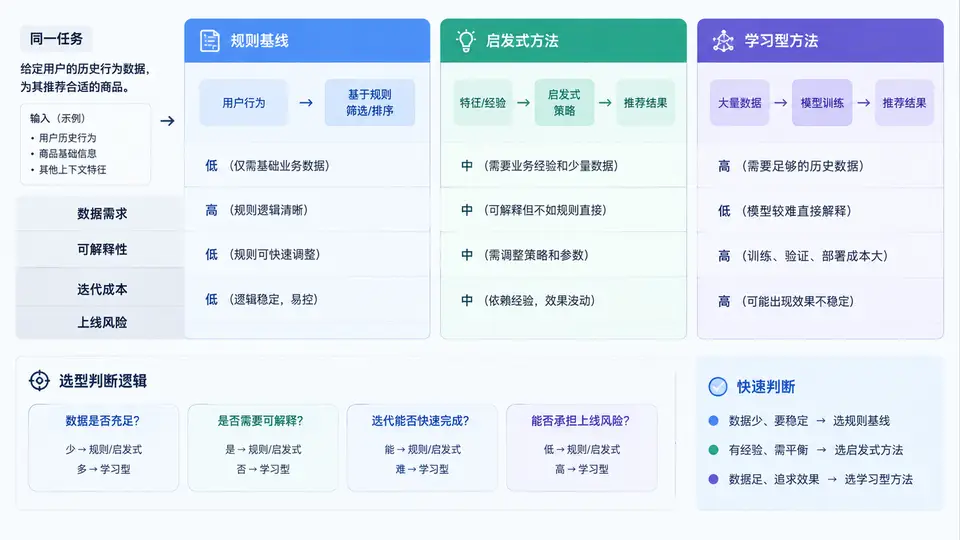
同一任务的三条实现路线
选型不是比较“哪个算法更先进”,而是比较三条路线在同一任务约束下的代价结构。假设任务为:根据订单的 12 个特征,判断该订单是否会在 24 小时内被取消,输出为二分类标签与置信度,评价指标为 F1 与召回率下限。三条路线分别是:
- 规则基线:人工枚举条件,如“距发货时间 < 2h 且支付方式为货到付款 → 高取消风险”。
- 启发式方法:用可调权重的评分函数,如对历史取消率、客户等级、库存紧张度加权求和后卡阈值。
- 学习型方法:用带标签样本训练梯度提升树或逻辑回归,由数据自动拟合特征与标签的关系。
三条路线的关键差异
| 维度 | 规则基线 | 启发式方法 | 学习型方法 |
|---|---|---|---|
| 数据需求 | 无需标注样本,依赖专家经验 | 需历史统计量(取消率、分布) | 需带标签样本,通常数千条以上 |
| 可解释性 | 完全透明,条件即理由 | 权重可读,但组合后需解释 | 需 SHAP/特征重要性等工具辅助 |
| 迭代成本 | 改条件即生效,分钟级 | 调权重与阈值,小时级 | 重训+调参+评估,天级 |
| 上线风险 | 低,但覆盖场景窄 | 中,需回归验证阈值 | 高,需监控数据漂移与性能衰减 |
| 典型适用 | 冷启动、强合规、快速验证 | 特征有效但样本不足 | 数据充足、收益显著、可承担运维 |
选型判断的可执行逻辑
不要一上来就训练模型。按以下顺序推进,每一步都产出可验证的结果,再决定是否进入下一步:
- 先写规则基线:用 3~5 条专家规则跑通全流程,确认任务可计算、指标可测。若基线 F1 已满足业务下限,直接上线,不必引入更复杂方法。
- 再试启发式:若基线覆盖不足,用历史统计量构造评分函数,网格搜索权重与阈值。若启发式相对基线提升明显且可解释,优先选它。
- 最后评估学习型:仅当启发式仍不达标、且标注样本量与迭代资源充足时,才训练学习型模型,并用同一测试集与基线、启发式对比。
选型决策的量化门槛(示例):设业务要求 F1 ≥ 0.75。规则基线 F1 = 0.62,启发式 F1 = 0.71,学习型 F1 = 0.83。此时学习型是唯一达标路线,但需确认:标注样本 ≥ 5000 条、可接受天级迭代、有监控能力。若样本仅 800 条,学习型 F1 可能降至 0.68,则启发式反而是更稳的选择。
实操建议:三条路线共用同一份测试集与同一套评价脚本,否则对比无效。规则基线的条件、启发式的权重、学习型的超参数都应记录在配置文件中,便于复现与回滚。
常见误区:把学习型方法当作默认答案。在样本不足、解释性要求高或迭代资源有限的场景中,规则基线与启发式往往更快上线、更易维护。选型的核心是匹配约束,而非追求技术复杂度。