1. 算法工程项目的需求拆解与可计算问题定义
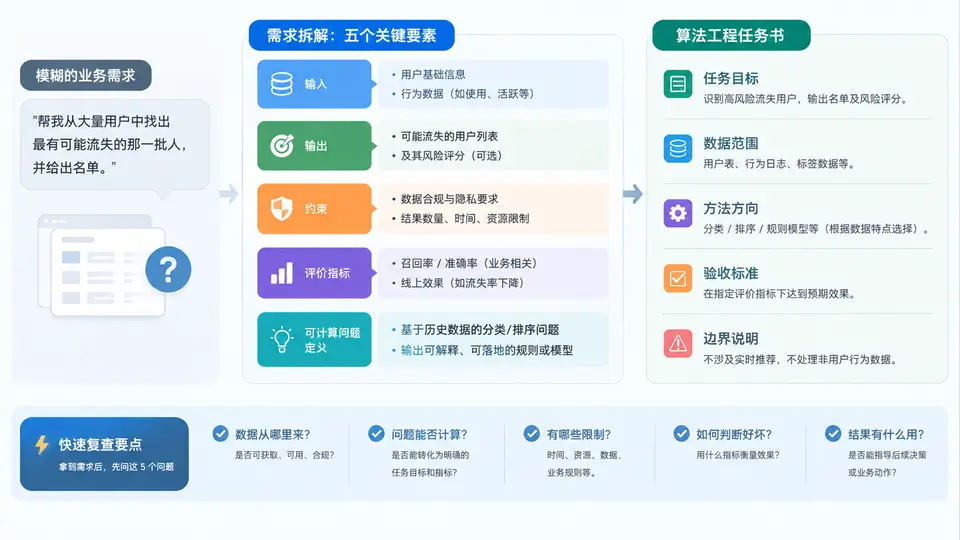
从模糊需求到可计算问题:拆解路径
业务方说“希望系统能自动识别异常订单”,这不是一个算法问题,而是一个业务愿望。算法工程的第一步,是把它翻译成机器能算、能验证、能交付的形式。拆解的核心动作是回答五个问题:输入是什么、输出是什么、约束在哪里、用什么指标评价、问题属于哪一类可计算形式。
下面这张图展示了从原始需求到算法工程任务书的完整拆解链路,以及每个环节需要落地的具体对象。
拆解过程中的关键判断
五要素中,约束和评价指标最容易在初期被忽略,却直接决定后续方案选型。例如“延迟 ≤ 200ms”会排除大量复杂模型,“误报率 ≤ 5%”会决定阈值策略,“可解释性要求”可能直接排除深度模型。这些约束必须在任务书中显式写出,而不是留到实现阶段再发现。
另一个常见问题是输出定义模糊。如果只写“输出是否异常”,后续无法做阈值调优和置信度排序。更可计算的定义是输出异常概率,再通过业务规则映射到最终决策。这样算法模块和业务规则解耦,便于独立迭代。
任务书最小字段清单:问题名称、输入字段及类型、输出字段及类型、硬约束(延迟/资源/合规)、软约束(可解释性/维护成本)、核心评价指标及目标值、问题形式化描述(输入空间、输出空间、目标函数)、数据来源与标注方式、验收条件。
从任务书到实现边界
任务书一旦确定,后续所有工作都在这个边界内进行。例2的方案选型、例3的接口契约设计,都直接引用任务书中的约束和指标。如果任务书本身模糊,后续每个环节都会反复返工。因此这一步的投入产出比极高:花1小时把任务书写清楚,可能节省后续10小时的沟通和重构成本。
判断任务书是否合格,可以用一个简单测试:把任务书交给一个没有参与讨论的工程师,他能否在不追问的情况下开始设计技术方案?如果能,说明输入输出、约束和指标已经足够明确;如果不能,说明还有关键信息停留在业务方的脑子里,需要继续拆解。