3. 为等值查询创建单列索引并验证效果
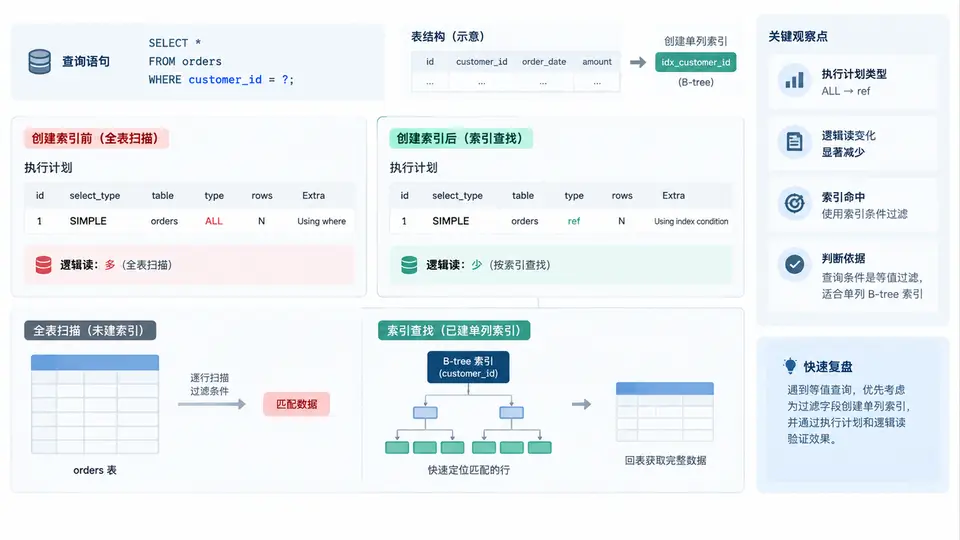
为什么等值查询适合单列 B-tree 索引
当 WHERE 条件形如 WHERE col = 常量 时,B-tree 索引能通过一次根到叶的定位直接找到匹配键值,把访问路径从全表扫描(TABLE ACCESS FULL)变为索引范围扫描(INDEX RANGE SCAN)。本节以一张订单表 orders 为例,对 customer_id 这一等值过滤字段创建单列索引,并用执行计划与逻辑读对比验证效果。
示例环境与数据准备
以下示例基于 Oracle 语法(其他数据库的 B-tree 索引原理一致,语法略有差异)。先构造一张有代表性的订单表,并让 customer_id 具有足够的选择性。
-- 示例表:订单表,约 100 万行
CREATE TABLE orders (
  order_id     NUMBER PRIMARY KEY,
  customer_id  NUMBER NOT NULL,
  order_date   DATE   NOT NULL,
  amount       NUMBER(10,2),
  status       VARCHAR2(20)
);

-- 插入示例数据:customer_id 在 1~5000 之间随机分布
INSERT INTO orders
SELECT level,
       TRUNC(DBMS_RANDOM.VALUE(1, 5001)),
       SYSDATE - DBMS_RANDOM.VALUE(0, 365),
       ROUND(DBMS_RANDOM.VALUE(10, 5000), 2),
       CASE WHEN DBMS_RANDOM.VALUE < 0.7 THEN 'PAID' ELSE 'PENDING' END
FROM dual CONNECT BY level <= 1000000;
COMMIT;

-- 收集统计信息,保证优化器有准确的行数估算
EXEC DBMS_STATS.GATHER_TABLE_STATS(USER, 'ORDERS');
创建索引前的基线测量
先对目标等值查询做一次基线测量,记录执行计划与逻辑读。这里使用 AUTOTRACE 获取真实统计,避免只看估算值。
-- 目标查询:按 customer_id 等值过滤
SELECT order_id, order_date, amount
FROM   orders
WHERE  customer_id = 88;

-- 查看执行计划与逻辑读
SET AUTOTRACE ON STATISTICS
SELECT order_id, order_date, amount
FROM   orders
WHERE  customer_id = 88;
SET AUTOTRACE OFF
基线预期现象:执行计划出现 TABLE ACCESS FULL,逻辑读(consistent gets)接近全表块数(示例约 1200)。这是后续对比的参照点。
创建单列 B-tree 索引
CREATE INDEX idx_orders_cust ON orders(customer_id);

-- 索引创建后重新收集统计信息
EXEC DBMS_STATS.GATHER_TABLE_STATS(USER, 'ORDERS');
索引列选择要点:只对出现在等值条件中的高选择性列建单列索引;若该列基数极低(如性别只有两个值),索引可能不被优化器选用,此时应优先考虑其他列或复合索引。
验证效果:执行计划与逻辑读对比
SET AUTOTRACE ON STATISTICS
SELECT order_id, order_date, amount
FROM   orders
WHERE  customer_id = 88;
SET AUTOTRACE OFF
对比两次输出,重点看三处:访问路径是否从 TABLE ACCESS FULL 变为 INDEX RANGE SCAN;逻辑读是否显著下降;返回行数是否一致(确保结果正确)。
| 观察项 | 创建索引前 | 创建索引后 | 判断标准 |
|---|---|---|---|
| 访问路径 | TABLE ACCESS FULL | INDEX RANGE SCAN | 出现 INDEX RANGE SCAN 即命中 |
| 逻辑读(consistent gets) | ≈1200 | ≈6 | 下降一个数量级以上 |
| 返回行数 | 示例约 200 行 | 示例约 200 行 | 两次必须一致 |
| 回表次数 | 不适用 | 等于命中行数 | 行数少时可接受 |
若创建索引后仍走全表扫描,常见原因:统计信息未更新、该列选择性太低、或查询返回行数占比过高(优化器认为全表扫描更划算)。可先执行
DBMS_STATS.GATHER_TABLE_STATS 再复测。索引会带来写入开销:每次 INSERT/UPDATE/DELETE 都需维护索引。对写入频繁的表,应只保留真正被等值查询高频使用的单列索引,避免冗余索引拖慢写入。
可复用的验证清单
- 确认 WHERE 条件为等值(
col = 常量),而非范围或函数包裹列。 - 创建索引后必须重新收集统计信息,否则优化器可能仍按旧估算选择全表扫描。
- 用
AUTOTRACE或EXPLAIN PLAN对比前后访问路径,确认出现INDEX RANGE SCAN。 - 对比逻辑读数值,下降一个数量级以上视为有效。
- 核对两次查询返回行数一致,排除因索引导致的结果偏差。
- 评估写入开销,确认该索引的查询收益大于维护成本。