1. 定位慢查询
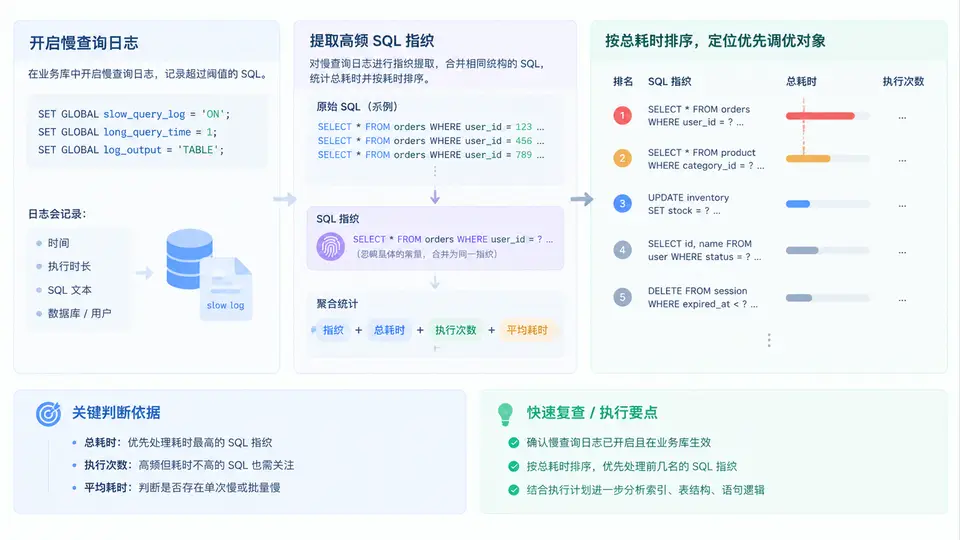
为什么“最慢的单条 SQL”不一定最值得先调
慢查询日志里通常同时存在两类记录:一类是单次执行极慢但一天只跑几次的报表 SQL,另一类是单次只要 200ms 却每分钟被调用上千次的业务 SQL。调优优先级应由总耗时决定,而不是单次耗时。总耗时的近似计算方式是:
因此第一步不是急着看执行计划,而是先把慢查询日志按“SQL 指纹”聚合,算出每条指纹的调用次数、平均耗时和总耗时,再按总耗时降序排列。
SQL 指纹:把“长得像”的 SQL 归为一类
同一条业务 SQL 每次执行时,WHERE 条件里的常量往往不同,例如 WHERE user_id = 1001 和 WHERE user_id = 1002。它们在日志里是两条不同文本,但本质是同一条 SQL。SQL 指纹就是把常量、字面量替换成占位符后得到的归一化文本:
原始 SQL : SELECT * FROM orders WHERE user_id = 1001 AND status = 'PAID'
SQL 指纹 : SELECT * FROM orders WHERE user_id = ? AND status = ?
只有按指纹聚合,才能把分散在成千上万条日志记录里的同一条 SQL 合并统计,得到真实的调用次数与总耗时。
上图中,报表 SQL 单次 8.5 秒,但因为一天只跑 6 次,总耗时不到 1 分钟;而订单查询单次仅 210ms,却因调用 12400 次累计 43.4 分钟,才是真正应该优先调优的对象。
开启慢查询日志并采集
在 MySQL 中,慢查询日志默认关闭。以下参数可在会话或全局动态设置(示例值,需按业务调整):
-- 开启慢查询日志(全局,重启后失效,需写入配置文件持久化)
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 1;          -- 超过 1 秒记录
SET GLOBAL log_queries_not_using_indexes = ON;  -- 记录未走索引的 SQL
SET GLOBAL log_output = 'TABLE';         -- 输出到 mysql.slow_log 表,便于 SQL 查询

-- 确认参数
SHOW VARIABLES LIKE 'slow_query_log%';
SHOW VARIABLES LIKE 'long_query_time';log_output='FILE' 或同时输出到文件,避免慢日志表写入影响性能;分析时再用工具导入。若使用 TABLE 输出,可直接用 SQL 聚合,适合本例的快速定位场景。从慢日志表提取指纹并排序
当 log_output='TABLE' 时,慢日志写入 mysql.slow_log,其中 sql_text 是原始 SQL,query_time 是执行耗时(秒)。下面的查询用正则把常量替换为 ?,生成指纹并聚合:
SELECT
  -- 将数字、单引号字符串、IN 列表统一替换为占位符,得到 SQL 指纹
  REGEXP_REPLACE(
    REGEXP_REPLACE(
      REGEXP_REPLACE(sql_text, '''[^'']*''', '?'),   -- 字符串常量 → ?
      '\\b[0-9]+\\b', '?'),                          -- 数字常量 → ?
    '[[:space:]]+', ' ')                             -- 压缩空白
    AS sql_fingerprint,
  COUNT(*)                          AS exec_count,
  ROUND(AVG(query_time), 3)         AS avg_sec,
  ROUND(SUM(query_time), 1)         AS total_sec,
  ROUND(SUM(query_time)/60, 1)      AS total_min
FROM mysql.slow_log
WHERE start_time >= NOW() - INTERVAL 1 DAY
GROUP BY sql_fingerprint
ORDER BY total_sec DESC
LIMIT 20;关键点:GROUP BY sql_fingerprint 把常量不同的同一条 SQL 合并;ORDER BY total_sec DESC 让总耗时最高的指纹排在最前,直接给出调优优先级。
结果判读与优先级划分
| 优先级 | 判断依据 | 处理动作 |
|---|---|---|
| P0 | 总耗时占比 > 30%,且次数高 | 立即用 EXPLAIN 分析,优先加索引或改写 |
| P1 | 总耗时占比 10%~30% | 排入本轮调优计划 |
| P2 | 总耗时占比 < 10%,但次数异常高 | 检查是否有缓存或批量优化空间 |
| P3 | 单次极慢但次数极少 | 可延后,或改为离线任务 |
IN (1,2,3) 这类列表,替换后可能仍保留括号结构差异,建议在应用层或使用 pt-query-digest 做更精确的指纹归一化。本例的 SQL 方案适合快速初筛,不作为唯一依据。可复用的采集与排序脚本
若慢日志输出为文件,可用 pt-query-digest 直接得到按总耗时排序的指纹报告:
pt-query-digest --since '24h' \
  --order-by 'Query_time:sum' \
  --limit 20 \
  /var/log/mysql/slow.log
输出中 Response time 的 total 列即为该指纹的总耗时,calls 为调用次数,R/Call 为平均耗时。按 total 降序阅读,即可得到与前面 SQL 方案一致的优先级列表。
执行检查清单
- 确认
slow_query_log=ON且long_query_time已按业务设定(建议 0.5~1 秒起步)。 - 确认采集窗口覆盖完整业务周期(至少 1 天,含高峰时段)。
- 按指纹聚合后,检查
exec_count是否合理,排除因日志重复写入导致的虚高。 - 按
total_sec降序取前 20 条,标记 P0/P1 作为本轮调优输入。 - 对 P0 指纹保留原始 SQL 样本,供下一步 EXPLAIN 分析使用。