4. Karpenter 与 Cluster Autoscaler 的共存边界判断
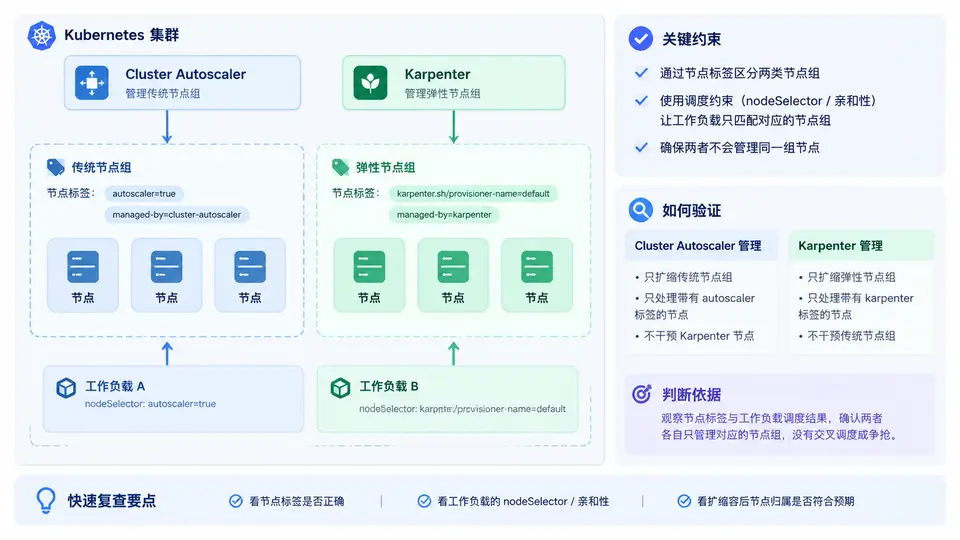
共存边界判断的核心:用标签与调度约束划清管理范围
当集群中同时运行 Cluster Autoscaler(CA)与 Karpenter 时,两者都会尝试通过伸缩节点来满足 Pending Pod。如果管理范围重叠,就会出现同一节点组被双方反复扩缩、节点刚被 Karpenter 创建又被 CA 判定为多余而缩容的争抢现象。共存的关键不是让两者协同决策,而是用互斥的边界把节点池切开:CA 只管理带特定标签的 Auto Scaling Group(ASG),Karpenter 只管理由 NodePool 匹配的节点,Pod 通过 nodeSelector / affinity / taint 明确落到其中一侧。
边界划分的三层约束
- 节点标签层:CA 管理的 ASG 节点打上
autoscaler=cluster-autoscaler;Karpenter 节点由 NodePool 自动打上karpenter.sh/nodepool等标签。两者标签集合不重叠。 - 调度约束层:需要 CA 扩容的工作负载加
nodeSelector: autoscaler: cluster-autoscaler;需要 Karpenter 供给的工作负载加nodeSelector: karpenter.sh/nodepool:或对应 taint 容忍。 - 控制器范围层:CA 通过
--node-group-auto-discovery的 ASG 标签限定只发现自己的 ASG;Karpenter 的 NodePool 通过 requirements 限定实例族、容量类型与可用区,不匹配 CA 节点。
判断边界是否生效,最直接的信号是:提交一个只带 CA nodeSelector 的 Pod,观察是否只有 CA 触发 ASG 扩容;再提交一个只带 Karpenter nodeSelector 的 Pod,观察是否只有 Karpenter 创建 NodeClaim。若两者都无动作或都动作,说明边界未生效。
验证两者不争抢同一节点组
边界配置完成后,用以下方式确认互斥生效。先记录当前节点与 ASG 状态,再分别提交两类 Pod,观察只有对应控制器产生动作。
| 验证项 | 操作 | 预期结果 | 异常信号 |
|---|---|---|---|
| CA 侧扩容 | 提交带 nodeSelector: autoscaler=cluster-autoscaler 的 Pending Pod |
CA 日志出现 scale-up,ASG 期望容量增加,Karpenter 无 NodeClaim 创建 | Karpenter 也创建了节点,说明 NodePool 匹配到了 CA 节点标签 |
| Karpenter 侧扩容 | 提交带 nodeSelector: karpenter.sh/nodepool=<name> 的 Pending Pod |
Karpenter 创建 NodeClaim 并启动 EC2,CA 无 scale-up 日志 | CA 也触发扩容,说明 ASG 发现标签覆盖了 Karpenter 节点 |
| 缩容互不干扰 | 删除 Karpenter 侧 Pod,等待 consolidation | Karpenter 终止对应节点,CA 管理的 ASG 容量不变 | CA 将 Karpenter 节点计入缩容候选,导致误缩容 |
| 标签隔离检查 | kubectl get nodes -L autoscaler,karpenter.sh/nodepool |
每个节点只带其中一组标签,无节点同时具备两者 | 存在节点同时带两组标签,边界已重叠 |
若 CA 的
--node-group-auto-discovery 使用了过于宽泛的 ASG 标签(例如只按 kubernetes.io/cluster/<name>=owned 发现),它可能把 Karpenter 启动的实例也纳入候选。务必让 CA 的发现标签与 Karpenter 节点标签互斥,并确认 Karpenter 启动的实例不携带 CA 的发现标签。可直接使用的边界检查清单
# 1. 查看 CA 发现的 ASG 标签范围
aws autoscaling describe-auto-scaling-groups \
  --query "AutoScalingGroups[].{Name:AutoScalingGroupName,Tags:Tags[?Key=='k8s.io/cluster-autoscaler/enabled']}"

# 2. 查看节点标签分布,确认无重叠
kubectl get nodes -L autoscaler,karpenter.sh/nodepool,node.kubernetes.io/instance-type

# 3. 查看 Karpenter NodePool 的 requirements 是否与 CA 节点组实例族重叠
kubectl get nodepool -o yaml | grep -A 20 requirements

# 4. 提交测试 Pod 后分别观察两侧控制器日志
kubectl logs -n kube-system deploy/cluster-autoscaler --tail=50 | grep -i "scale.up\|scale.down"
kubectl logs -n karpenter deploy/karpenter --tail=50 | grep -i "created nodeclaim\|launched"判断标准很明确:同一时刻,一个 Pending Pod 只应触发一侧控制器。如果两侧都响应,说明标签或调度约束存在交集,需要回到 NodePool requirements 与 CA 发现标签上收紧范围,直到节点标签集合完全互斥。