1. Karpenter 最小化安装与首个 NodePool 验证
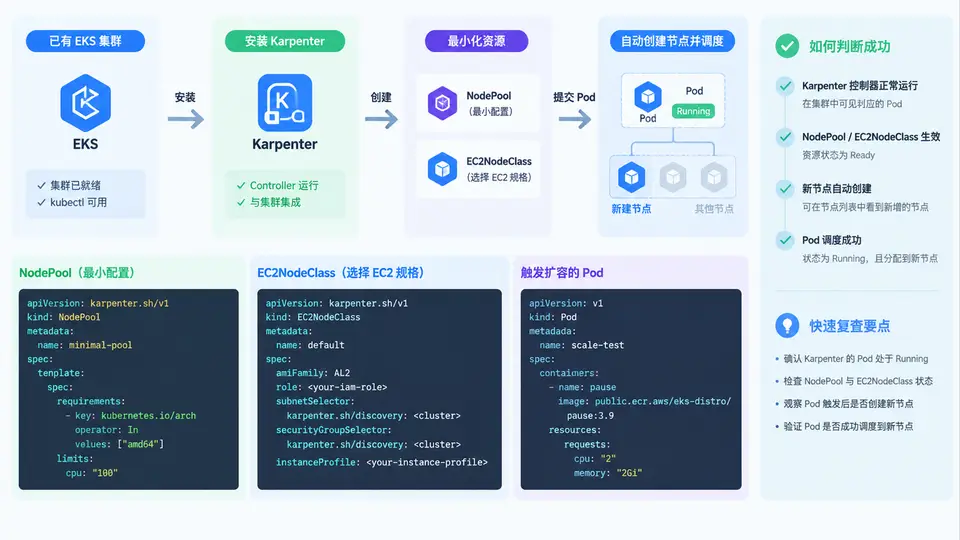
任务边界与前置条件
本例在已有 EKS 集群上完成 Karpenter 的最小化落地:安装控制器、定义最小 NodePool 与 EC2NodeClass、提交一个当前无法被现有节点满足的 Pod,观察 Karpenter 自动创建 EC2 节点并完成调度。为控制变量,本例只验证“能扩出来、能调度上”,不展开实例类型约束、中断处理与成本优化。
- EKS 集群版本 ≥ 1.25,节点组至少保留 1 个可运行系统组件的托管节点。
- 已安装
kubectl、helm、awsCLI,且当前身份可操作目标集群与对应 AWS 资源。 - 集群所在区域、集群名称、VPC 子网与安全组 ID 已确认,后续
EC2NodeClass直接引用。 - Karpenter 控制器需要 IRSA 才能调用 EC2 API;本例假设该角色已就绪(权限细节由后续案例展开)。
安装 Karpenter 控制器
使用 Helm 安装,关键是让控制器知道“自己管哪个集群、用哪个 IRSA 角色、监听哪个中断队列”。下面命令中的变量需替换为真实值。
export CLUSTER_NAME="demo-eks"
export AWS_REGION="cn-north-1"
export KARPENTER_VERSION="0.37.0"
export KARPENTER_NODE_ROLE="KarpenterNodeRole-demo-eks"
export KARPENTER_IRSA_ROLE_ARN="arn:aws-cn:iam::111122223333:role/KarpenterControllerRole-demo-eks"

helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \
  --version "${KARPENTER_VERSION}" \
  --namespace kube-system \
  --set "settings.clusterName=${CLUSTER_NAME}" \
  --set "settings.interruptionQueue=${CLUSTER_NAME}" \
  --set "serviceAccount.annotations.eks\.amazonaws\.com/role-arn=${KARPENTER_IRSA_ROLE_ARN}" \
  --set controller.resources.requests.cpu=1 \
  --set controller.resources.requests.memory=1Gi \
  --set controller.resources.limits.cpu=1 \
  --set controller.resources.limits.memory=1Gi \
  --wait
安装完成后确认控制器 Pod 处于 Running,且日志中已成功加载集群信息:
kubectl -n kube-system get pods -l app.kubernetes.io/name=karpenter
kubectl -n kube-system logs -l app.kubernetes.io/name=karpenter --tail=20
最小 NodePool 与 EC2NodeClass
EC2NodeClass 描述“用什么 AWS 资源起节点”,NodePool 描述“允不允许起、起多少、怎么回收”。最小可用版本只需指定 AMI 族、节点角色、子网与安全组选择器,以及一个容量上限。
apiVersion: karpenter.k8s.aws/v1beta1
kind: EC2NodeClass
metadata:
  name: default
spec:
  amiFamily: AL2
  role: KarpenterNodeRole-demo-eks
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: demo-eks
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: demo-eks
---
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      nodeClassRef:
        name: default
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["on-demand"]
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64"]
  limits:
    cpu: "20"
  disruption:
    consolidationPolicy: WhenUnderutilized
kubectl apply -f nodepool.yaml
kubectl get nodepool default
kubectl get ec2nodeclass defaultkarpenter.sh/discovery=demo-eks 标签,否则 EC2NodeClass 无法解析出可用资源,控制器会持续报错而不创建节点。提交触发扩容的 Pod
用一个资源请求明显高于现有节点余量的 Pod 触发扩容。示例请求 3 CPU、6Gi 内存,并加一个不存在的节点选择器,确保它不会被现有节点接走。
apiVersion: v1
kind: Pod
metadata:
  name: inflate-demo
spec:
  restartPolicy: Never
  nodeSelector:
    karpenter.sh/nodepool: default
  containers:
    - name: app
      image: public.ecr.aws/nginx/nginx:stable
      resources:
        requests:
          cpu: "3"
          memory: 6Gi
kubectl apply -f inflate.yaml
kubectl get pod inflate-demo -w验证链路与判读
下图给出从提交 Pod 到节点就绪的完整信号链,以及每一步应观察的对象与判据。Karpenter 的核心动作是:发现 Pending Pod → 计算满足条件的实例 → 调用 EC2 创建 → 节点注册进集群 → 调度器绑定 Pod。
结果判读与清理
当 inflate-demo 变为 Running 且其所在节点名与原有托管节点不同,说明 Karpenter 已完成“创建节点 + 调度”闭环。此时可查看 NodeClaim 与节点标签确认归属:
kubectl get nodeclaims
kubectl get nodes -l karpenter.sh/nodepool=default
kubectl describe node <新节点名> | grep -A3 "Allocatable"
验证完成后删除测试 Pod,若 NodePool 的 consolidationPolicy 为 WhenUnderutilized,Karpenter 会在节点空闲后自动回收,可观察节点数量回落:
kubectl delete pod inflate-demo
kubectl get nodes -w