2. EKS托管节点组创建与自动伸缩配置
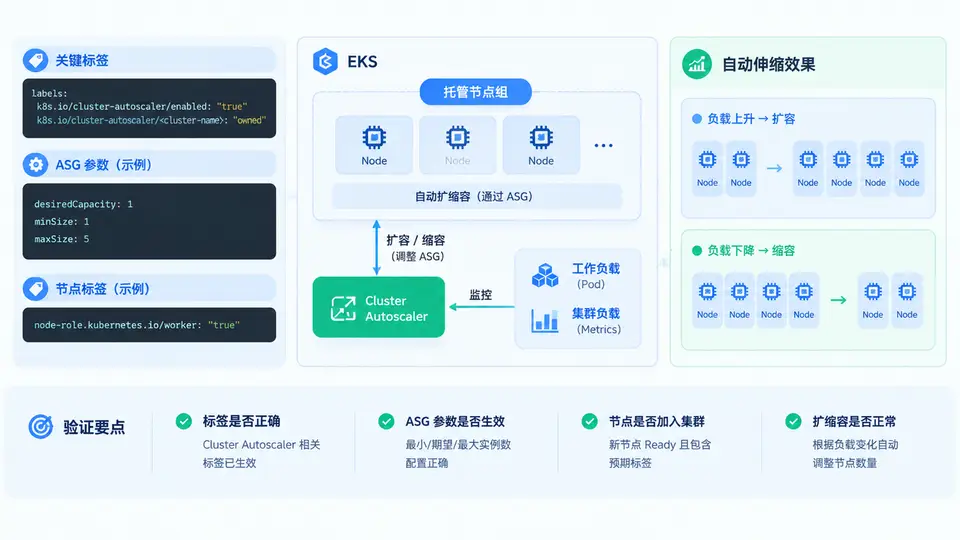
托管节点组与 Cluster Autoscaler 的协作关系
EKS 托管节点组(Managed Node Group)由 EKS 控制面托管节点生命周期,底层仍是一组 Auto Scaling Group(ASG)。要让 Cluster Autoscaler(CA)能够扩缩容,必须让 CA 能识别节点组边界、ASG 名称,并允许它调整 ASG 的期望容量。核心是三件事:给 ASG 打上 CA 发现标签、给节点打上归属标签、给 CA 授予修改 ASG 的 IAM 权限。
创建托管节点组并配置自动伸缩
以下使用 eksctl 创建带 CA 标签的托管节点组。关键参数:--nodes-min 和 --nodes-max 决定 ASG 的 Min/Max,CA 只能在此范围内调整 Desired。节点组名称和集群名称必须与 CA 标签中的值一致。
# 创建托管节点组(假设集群名为 my-eks-cluster,区域 ap-southeast-1)
eksctl create nodegroup \
  --cluster my-eks-cluster \
  --region ap-southeast-1 \
  --name ng-worker \
  --node-type t3.medium \
  --nodes 2 \
  --nodes-min 1 \
  --nodes-max 5 \
  --node-labels role=worker \
  --asg-access \
  --managed

# 验证节点组状态
eksctl get nodegroup --cluster my-eks-cluster --region ap-southeast-1

# 查看 ASG 标签是否已自动注入
aws autoscaling describe-auto-scaling-groups \
  --query "AutoScalingGroups[?contains(Tags[?Key=='eks:nodegroup-name'].Value[], 'ng-worker')].[AutoScalingGroupName,MinSize,MaxSize,DesiredCapacity,Tags]" \
  --output json
eksctl 的
--asg-access 会自动为节点组的 IAM 角色附加 CA 所需的策略,并给 ASG 打上 k8s.io/cluster-autoscaler/enabled 和 k8s.io/cluster-autoscaler/<cluster-name> 标签。如果使用 AWS CLI 手动创建,需要自行添加这些标签。部署 Cluster Autoscaler
CA 以 Deployment 形式运行在集群中,通过 ServiceAccount 的 IAM 角色(IRSA)获得修改 ASG 的权限。以下为关键配置片段:
# 创建 IRSA(如果集群已启用 OIDC)
eksctl create iamserviceaccount \
  --cluster my-eks-cluster \
  --region ap-southeast-1 \
  --name cluster-autoscaler \
  --namespace kube-system \
  --attach-policy-arn arn:aws:iam::aws:policy/AutoScalingFullAccess \
  --approve

# 部署 CA(使用官方 manifest,替换 cluster-name 和 region)
kubectl apply -f https://raw.githubusercontent.com/kubernetes/autoscaler/master/cluster-autoscaler/cloudprovider/aws/examples/cluster-autoscaler-autodiscover.yaml

# 修改 Deployment 中的关键参数
kubectl -n kube-system edit deployment cluster-autoscaler
# 确保以下参数存在:
#   --node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/my-eks-cluster
#   --balance-similar-node-groups
#   --skip-nodes-with-system-pods=false
验证自动扩缩容
通过部署一个资源需求超过当前节点容量的 Pod,观察 CA 是否触发扩容。以下为验证步骤:
# 1. 查看当前节点数
kubectl get nodes

# 2. 部署一个需要大量 CPU 的 Pod(示例:请求 3 核,超过单节点可分配量)
cat <<EOF | kubectl apply -f -
apiVersion: v1
kind: Pod
metadata:
  name: scale-test
spec:
  containers:
  - name: stress
    image: polinux/stress
    resources:
      requests:
        cpu: "3"
        memory: "2Gi"
    command: ["stress"]
    args: ["--cpu", "3", "--timeout", "300s"]
EOF

# 3. 观察 Pod 状态(应为 Pending)
kubectl get pod scale-test -w

# 4. 查看 CA 日志,确认扩容决策
kubectl -n kube-system logs deployment/cluster-autoscaler --tail=50

# 5. 等待 1-2 分钟,再次查看节点数(应增加)
kubectl get nodes

# 6. 删除测试 Pod,观察缩容(默认 10 分钟后触发)
kubectl delete pod scale-test
缩容默认有 10 分钟延迟(
--scale-down-delay-after-add),且节点上不能有无法迁移的 Pod(如未配置 PDB 的裸 Pod)。如果节点长时间不缩容,检查是否有 kube-system 命名空间的 Pod 未设置 --skip-nodes-with-system-pods=false。关键参数速查
| 参数 | 作用 | 推荐值 |
|---|---|---|
--nodes-min | ASG 最小容量,CA 不会缩到此值以下 | 1(生产建议 ≥2) |
--nodes-max | ASG 最大容量,CA 不会扩到此值以上 | 根据预算和配额设定 |
--node-group-auto-discovery | CA 发现 ASG 的标签过滤条件 | asg:tag=k8s.io/cluster-autoscaler/enabled,k8s.io/cluster-autoscaler/<cluster-name> |
--scale-down-delay-after-add | 扩容后多久才允许缩容 | 10m(默认) |
--scale-down-unneeded-time | 节点空闲多久才缩容 | 10m(默认) |
--balance-similar-node-groups | 多节点组间均衡扩缩 | true |