4. 平台服务等级目标(SLO)定义与错误预算策略
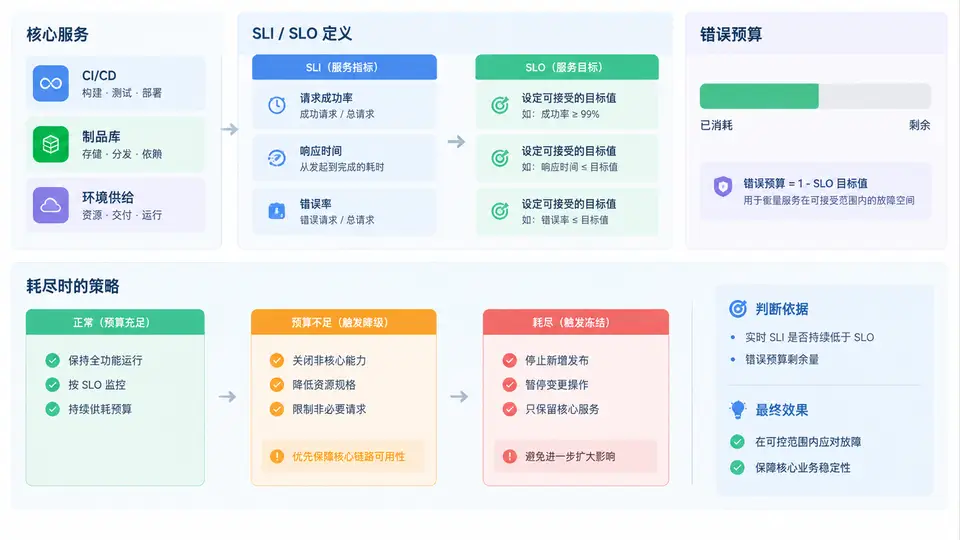
为什么平台服务需要 SLO 与错误预算
平台工程把 CI/CD、制品库、环境供给当作“内部产品”来运营,就必须回答两个问题:用户能感知到的可靠性到底是多少,以及可靠性投入与交付速度如何平衡。SLO(服务等级目标)给出可量化的可靠性承诺,错误预算则是这个承诺允许的“失败额度”。当预算被快速消耗时,平台团队应主动降级非关键功能或冻结高风险变更,而不是等到用户大面积投诉才被动响应。
SLI 选择:从用户旅程中提取可观测信号
SLI(服务等级指标)必须来自用户真实感知的路径,而不是服务器内部指标。对平台核心服务,建议按“请求—处理—结果”三段式选取:
| 平台服务 | 关键用户旅程 | 推荐 SLI | 数据来源 |
|---|---|---|---|
| CI/CD 流水线 | 提交代码 → 获得构建结果 | 流水线成功完成率、端到端时延 P95 | 流水线执行记录、事件时间戳 |
| 制品库 | 拉取依赖 / 推送制品 | 请求成功率、下载吞吐达标率 | 仓库访问日志、网关指标 |
| 环境供给 | 申请环境 → 环境可用 | 供给成功率、供给时延 P90 | 供给控制器事件、资源就绪探针 |
每个 SLI 都要明确分子、分母、统计窗口和排除条件。例如“流水线成功完成率 = 成功完成的流水线运行数 / 总运行数”,排除用户主动取消的运行,窗口取 28 天滚动。
SLO 与错误预算的量化关系
SLO 用百分比表达,错误预算就是 1 - SLO。以 28 天滚动窗口为例:
- SLO = 99.9% → 错误预算 = 0.1% → 28 天约允许 40 分钟不可用(按时间型)或 0.1% 请求失败(按请求型)。
- SLO = 99.5% → 错误预算 = 0.5% → 28 天约允许 3.4 小时不可用。
错误预算消耗速率(burn rate)比剩余额度更早暴露风险:若 1 小时内消耗了 28 天预算的 10%,说明按此速率 10 小时就会耗尽,必须立即介入。
错误预算耗尽时的降级与冻结策略
策略必须提前定义、自动触发,避免临时争论。以下是一份可直接落地的策略表:
| 状态 | 触发条件 | 平台团队动作 | 对用户的影响 |
|---|---|---|---|
| 正常 | burn rate < 1 | 正常发布,持续观察 | 无 |
| 预警 | 1 ≤ burn rate < 2 | 暂停非关键变更,启动根因排查 | 无直接降级 |
| 冻结 | burn rate ≥ 2 或预算剩余 < 20% | 冻结高风险发布,降级非核心功能 | 非核心功能可能延迟或降级 |
| 熔断 | 预算耗尽 | 仅允许修复类变更,强制复盘 | 核心功能保持,非核心暂停 |
注意:错误预算不是惩罚工具,而是决策工具。冻结期间应优先修复可靠性问题,而不是继续堆叠新功能。预算恢复后需复盘消耗原因,并评估是否调整 SLO 或架构。
可执行检查清单
- 每个平台核心服务是否至少有一个用户旅程对应的 SLI?
- SLI 的分子、分母、窗口、排除条件是否书面化?
- SLO 是否与用户期望对齐,而非拍脑袋定 99.99%?
- 错误预算是否按 28 天滚动窗口自动计算并可视化?
- burn rate 阈值是否配置了自动告警和分级响应?
- 冻结/降级策略是否经过平台团队与业务方共同评审?