1. 平台工程核心边界与最小可行平台定义
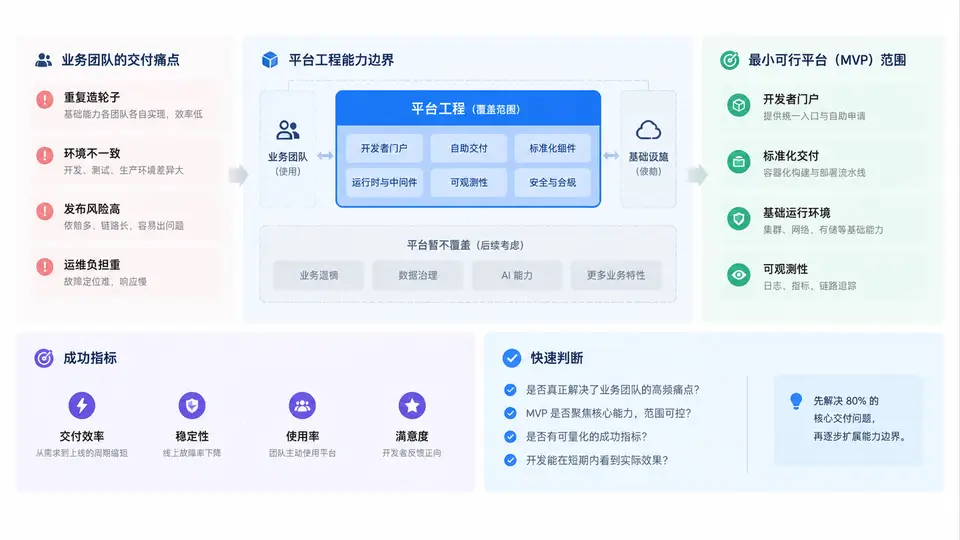
从交付痛点反推平台边界
平台工程不是把所有运维工具打包给开发团队,而是针对具体业务团队的交付瓶颈,划定一组可复用、可度量、可演进的能力边界。下面以一个 12 人电商业务团队为例,梳理其从代码提交到生产发布的真实痛点,并据此推导 MVP 范围。
痛点采集:用交付时间线定位阻塞点
先记录该团队当前一次典型发布的完整链路耗时(示例数据,用于教学推演):
| 阶段 | 当前做法 | 耗时 | 主要痛点 |
|---|---|---|---|
| 代码提交 | Git push 到主干 | 2 min | 无 |
| 构建 | 本地手动执行脚本 | 15 min | 环境不一致,偶发失败 |
| 镜像打包 | 手动写 Dockerfile | 20 min | 基础镜像版本混乱 |
| 测试环境部署 | 找运维开机器、配网络 | 1.5 天 | 排队等待,配置靠口口相传 |
| 生产发布 | 运维手动执行 kubectl | 40 min | 无回滚预案,发布窗口受限 |
| 可观测性接入 | 事后补日志和监控 | 2 天 | 故障定位慢,指标口径不统一 |
总交付周期约 4.5 天,其中等待与手工操作占 80% 以上。核心矛盾不是“缺工具”,而是缺少一条标准化、自助化的交付路径。
能力边界判定:该做什么、不该做什么
平台工程的能力边界应遵循“高频、共性、可标准化”三原则。以下用判定矩阵明确 MVP 的取舍:
| 候选能力 | 是否高频 | 是否共性 | 可否标准化 | MVP 决策 |
|---|---|---|---|---|
| CI 构建流水线 | 是 | 是 | 是 | 纳入 |
| 容器镜像构建与推送 | 是 | 是 | 是 | 纳入 |
| 测试环境自助申请 | 是 | 是 | 是 | 纳入 |
| 生产发布与回滚 | 是 | 是 | 是 | 纳入 |
| 日志/指标/追踪接入 | 是 | 是 | 是 | 纳入 |
| 业务领域建模 | 否 | 否 | 否 | 排除 |
| 数据库 Schema 设计 | 否 | 否 | 否 | 排除 |
| 前端组件库 | 中 | 部分 | 部分 | 暂缓 |
边界原则:平台只负责“从代码到运行”的通用路径,不介入业务逻辑、数据模型和产品决策。凡是需要业务语义判断的环节,都不应纳入平台 MVP。
MVP 范围说明
基于上述判定,该团队的最小可行平台定义为一条从提交到可观测的黄金路径,包含五个能力模块:
- 标准化 CI 模板:提供预置流水线模板,开发只需声明语言与测试命令,构建环境由平台统一维护。
- 镜像工厂:统一基础镜像、构建参数和安全扫描,产出可追溯的镜像标签。
- 环境自助服务:通过声明式配置申请测试环境,平台自动完成命名空间、网络策略和依赖注入。
- 发布与回滚:提供一键发布、灰度策略和自动回滚,发布记录可审计。
- 可观测性基线:应用接入即自动采集日志、指标和追踪,统一标签规范。
成功指标
MVP 是否有效,用以下四个指标衡量(目标值为示例设定,需根据团队基线调整):
| 指标 | 当前基线 | MVP 目标 | 测量方式 |
|---|---|---|---|
| 代码提交到测试环境就绪 | 约 2 天 | ≤ 30 分钟 | 流水线时间戳差值 |
| 生产发布频率 | 每周 1 次 | 每周 ≥ 5 次 | 发布系统记录 |
| 发布失败回滚时间 | 约 40 分钟 | ≤ 5 分钟 | 回滚操作日志 |
| 开发者平台自助率 | 约 20% | ≥ 80% | 无需运维介入的发布占比 |
边界判定口诀:高频共性可标准化 → 纳入 MVP;低频个性需业务判断 → 排除或暂缓。平台只做“从代码到运行”的通用路径,不碰业务语义。
落地检查清单
- 是否已记录当前交付链路的各阶段耗时与阻塞点?
- 每个候选能力是否经过“高频、共性、可标准化”三项判定?
- MVP 是否只覆盖一条端到端黄金路径,而非功能堆砌?
- 成功指标是否有当前基线、目标值和明确测量方式?
- 排除项是否已与业务团队达成共识,避免范围蔓延?