3. 性能分析基础
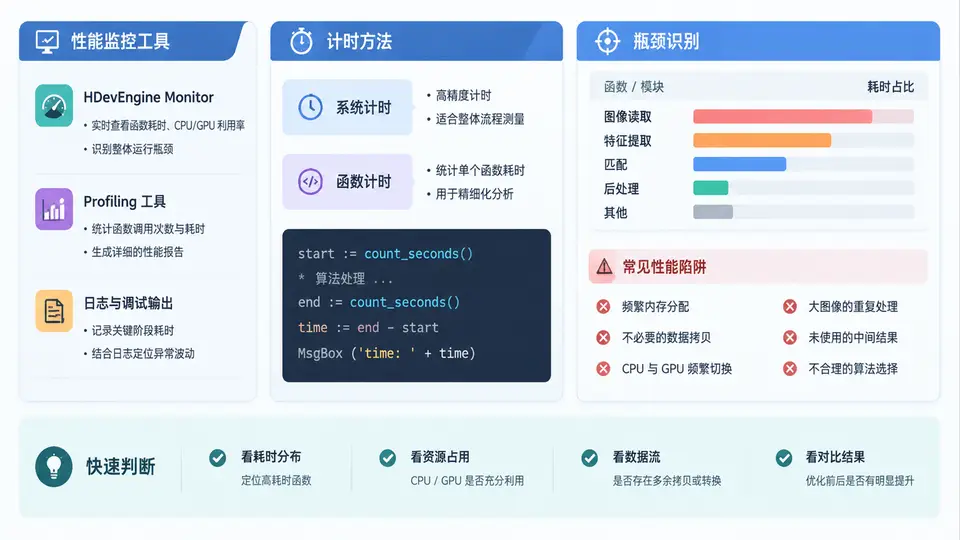
在视觉算法加速的实践中,有一条铁律:没有测量就没有优化。许多工程师在未做性能剖析的情况下,凭直觉猜测瓶颈所在,结果往往事倍功半——优化了耗时仅占 2% 的算子,却忽略了真正拖慢系统的图像采集或数据转换环节。本章将系统讲解 Halcon 提供的性能监控工具、精确计时方法、瓶颈识别流程,并剖析最常见的性能陷阱,帮助你建立一套可量化、可复现的性能分析方法论。
3.1 核心原理:性能分析的三层模型
Halcon 程序的执行时间由三个层面构成,任何优化都必须先明确瓶颈位于哪一层:
- 算子层(Operator Level):单个 Halcon 算子(如
threshold、find_shape_model)的内部执行时间。这是最常被关注的层面,但未必是系统瓶颈所在。 - 数据流层(Data Flow Level):图像数据在算子之间传递、格式转换(如从 RGB 转为灰度)、区域与图像的相互转换所消耗的时间。这一层常被忽略,但在多步骤视觉流程中占比可能高达 30%。
- 系统层(System Level):图像采集(相机 SDK 调用)、硬盘读写、网络传输、显示刷新等外部 I/O 操作的时间。当系统层耗时占比超过 50% 时,优化算子毫无意义。
性能分析的核心原则是:先定位层面,再定位算子,最后才动手优化。下图展示了典型的性能分析决策路径:
3.2 方法流程:Halcon 性能监控工具与计时方法
3.2.1 系统级计时:get_system_time 与 count_seconds
Halcon 提供两种基础计时接口。get_system_time 返回操作系统级别的时钟时间(精度通常为微秒级),适合测量整个程序段的总耗时;count_seconds 返回从程序启动到当前时刻的秒数(浮点数),适合测量相对耗时。推荐使用 count_seconds 进行算子级计时,因为它开销极小且精度足够。
// 基础计时模式
double t_start, t_end;
count_seconds(&t_start);

// 执行待测算子
threshold(Image, Region, 128, 255);
connection(Region, ConnectedRegions);

count_seconds(&t_end);
double elapsed_ms = (t_end - t_start) * 1000.0;
printf("算子链总耗时: %.3f ms\n", elapsed_ms);
3.2.2 算子级剖析:get_operator_time 与系统参数
Halcon 内置了算子级性能计数器。通过设置系统参数 'timer_mode' 为 'operator',Halcon 会自动记录每个算子的累计执行时间和调用次数。使用 get_operator_time 可以查询这些统计数据。
// 启用算子级计时
set_system('timer_mode', 'operator');

// 执行完整的视觉流程
read_image(Image, 'part.png');
rgb1_to_gray(Image, GrayImage);
threshold(GrayImage, Region, 100, 200);
connection(Region, ConnectedRegions);
select_shape(ConnectedRegions, SelectedRegions, 'area', 'and', 500, 99999);

// 查询各算子耗时
tuple_operator_time(OperatorNames, OperatorTimes);
for (i = 0; i < |OperatorNames|; i++) {
    printf("%-30s %10.3f ms\n", OperatorNames[i], OperatorTimes[i] * 1000.0);
}
输出示例:
read_image                    12.345 ms
rgb1_to_gray                   3.210 ms
threshold                      0.845 ms
connection                     1.230 ms
select_shape 0.567 ms从输出可以清晰看到,read_image 占据了绝大部分耗时,这属于系统层 I/O 瓶颈,而非算子本身的问题。
3.2.3 性能监控工具:HDevelop 的 Profiler
HDevelop 内置了图形化的性能分析器(Profiler)。在菜单栏选择 “运行” → “性能分析”,即可启动。Profiler 会以柱状图形式展示每个算子的执行时间、调用次数和耗时占比,并支持按耗时排序。对于复杂程序,建议先使用 Profiler 快速定位热点区域,再使用 count_seconds 进行精确测量。
set_system('timer_mode', 'operator') 和 get_operator_time 的代码嵌入到 C++/C# 工程中,进行真实运行环境下的性能采集。
3.3 瓶颈识别:从数据到结论的系统化方法
瓶颈识别不是简单地找耗时最长的算子,而是需要结合数据流和业务逻辑进行综合判断。推荐以下五步流程:
- 建立基线:在未做任何优化前,测量整个视觉流程的总耗时,并记录图像分辨率、相机帧率、CPU/GPU 型号等环境参数。
- 分层统计:将程序划分为采集、预处理、核心算法、后处理、输出五个阶段,分别计时,确定瓶颈所在层面。
- 算子级剖析:对瓶颈层面内的算子逐一计时,找出耗时排名前 3 的算子。
- 验证数据依赖:检查热点算子是否依赖前序算子的输出格式。例如,
find_shape_model对输入图像的通道数、类型(byte/uint2)有严格要求,若前序算子输出了不匹配的格式,会触发隐式转换,增加额外耗时。 - 制定优化策略:根据瓶颈类型选择优化手段——算子替换、参数调优、并行化、GPU 加速或算法重构。
3.3.1 常见性能陷阱清单
以下表格总结了视觉项目中最高频的性能陷阱,以及对应的检测方法和优化方向:
| 陷阱类型 | 典型表现 | 检测方法 | 优化方向 |
|---|---|---|---|
| 隐式图像转换 | RGB 图像直接传入灰度算子 | Profiler 中出现 convert_image_type |
在流程入口统一转换,避免重复转换 |
| 区域爆炸 | connection 后区域数量过多 |
统计 |ConnectedRegions| 数量 |
使用 select_shape 前置过滤,或使用 connection 的 'min_size' 参数 |
| 全图处理 | 对整幅图像执行 threshold 而非 ROI |
检查算子输入是否为完整图像 | 先 reduce_domain 缩小处理范围 |
| 同步采集 | grab_image 阻塞等待相机曝光 |
采集耗时占总耗时比例过高 | 使用 grab_image_async 异步采集 |
| 频繁内存分配 | 循环内反复创建大尺寸图像 | 观察内存峰值和 GC 频率 | 复用图像缓冲区,使用 gen_image 预分配 |
| 模板匹配参数过严 | find_shape_model 的 Greediness 设置过低 |
对比不同 Greediness 值的耗时 |
调高 Greediness 至 0.7~0.9,或使用金字塔层级 |
3.4 案例实战:一个典型的视觉定位瓶颈分析
假设我们有一个 PCB 板定位项目,视觉流程为:相机采集 → 彩色转灰度 → 阈值分割 → 形态学处理 → 模板匹配定位。初始实现的总耗时为 85 ms,不满足 50 ms 的节拍要求。以下是完整的分析过程:
3.4.1 分层计时结果
阶段划分与耗时:
[采集] grab_image_async         28.5 ms  (33.5%)
[预处理] rgb1_to_gray            4.2 ms  ( 4.9%)
[分割] threshold + connection    6.8 ms  ( 8.0%)
[形态学] opening + closing       3.5 ms  ( 4.1%)
[定位] find_shape_model         38.0 ms  (44.7%)
[后处理] 结果显示                4.0 ms  ( 4.7%)
----------------------------------------------
总耗时: 85.0 ms初步结论:瓶颈在模板匹配(44.7%)和图像采集(33.5%)。但进一步分析发现,find_shape_model 的输入图像是完整的 2448×2048 彩色图像转换后的灰度图,而模板实际只覆盖了图像中央约 1/4 的区域。
3.4.2 深入剖析与优化
针对模板匹配环节,我们进行了算子级剖析:
find_shape_model 内部耗时分解:
- 金字塔构建: 12.3 ms
- 边缘提取:    8.7 ms
- 相似度计算:  14.5 ms
- 位姿精化:    2.5 ms
优化措施:
- 缩小搜索域:使用
reduce_domain将匹配区域裁剪为 ROI(约原图的 1/4),耗时从 38 ms 降至 11 ms。 - 调整金字塔层级:将
NumLevels从默认的 4 提升到 6,利用粗金字塔快速排除大部分候选位置,耗时进一步降至 7 ms。 - 异步采集:将
grab_image改为grab_image_async,使采集与上一帧的算法处理重叠,采集耗时从 28.5 ms 降至约 5 ms(实际等待时间)。
优化后总耗时:5 + 4.2 + 6.8 + 3.5 + 7 + 4 = 30.5 ms,满足 50 ms 节拍要求,且未引入任何 GPU 加速。
find_shape_model 最多能将 7 ms 降至 2 ms,但 ROI 裁剪和异步采集带来了 50 ms 以上的收益。正确的顺序永远是:先消除结构性浪费,再考虑硬件加速。
3.5 误区与复盘:性能分析中的典型错误
在多年工程实践中,以下三个误区反复出现,值得每位工程师警惕:
误区一:只测一次,不取平均值
视觉系统的耗时受 CPU 频率波动、缓存命中率、操作系统调度等因素影响,单次测量误差可达 ±20%。正确的做法是:连续运行 100 次以上,取 P50(中位数)和 P95(95 分位)作为性能指标。P95 比平均值更能反映真实生产环境中的最差情况。
// 正确的性能测试模式
double times[100];
for (int i = 0; i < 100; i++) {
    count_seconds(&t0);
    // 执行视觉流程
    count_seconds(&t1);
    times[i] = (t1 - t0) * 1000.0;
}
// 排序后取 P50 和 P95
sort(times);
double p50 = times[49];
double p95 = times[94];
误区二:忽略图像分辨率对耗时的非线性影响
许多算子的耗时与图像面积呈线性关系,但部分算子(如 find_shape_model、edges_sub_pix)的耗时与图像内容复杂度相关。当图像分辨率从 500 万像素提升到 1200 万像素时,某些算子的耗时可能增长 3~5 倍而非 2.4 倍。因此,在性能测试时必须使用与生产环境一致的分辨率和图像内容。
误区三:将 HDevelop 中的耗时等同于生产环境耗时
HDevelop 是解释执行环境,其算子调用开销远高于编译后的 C++ 程序。通常 HDevelop 中的耗时比 C++ 环境高出 10%~30%。此外,HDevelop 的 Profiler 本身会引入额外开销。因此,HDevelop 只适合做相对比较和瓶颈定位,最终的性能验收必须在目标部署环境中进行。