2. 缺陷分类基础
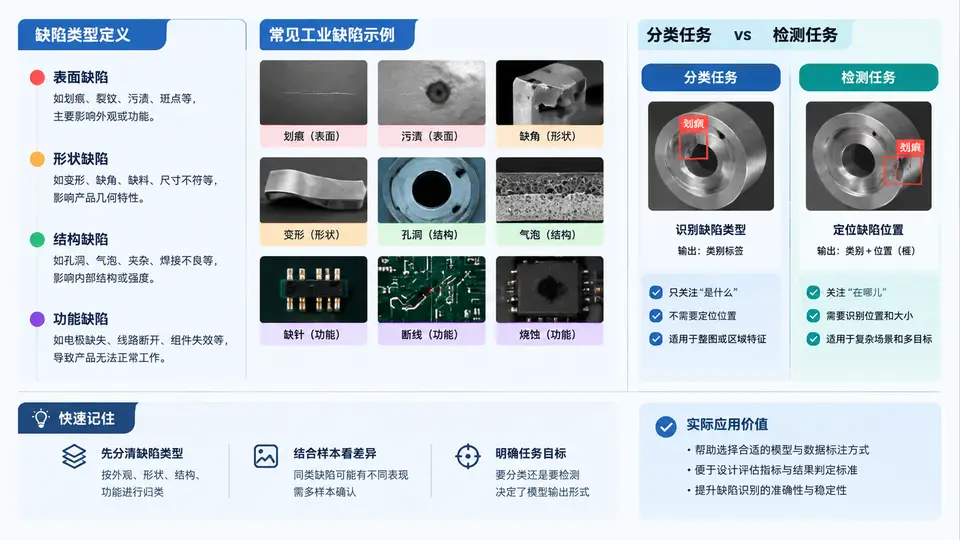
在构建任何基于Halcon的视觉检测系统之前,必须首先厘清一个根本性问题:我们究竟要让算法完成什么任务?是判断“产品有没有缺陷”,还是判断“这个缺陷属于哪一类”?这决定了整个模型训练与评估的路径。本章将系统性地建立缺陷分类的认知框架,为后续的模型训练与评估打下坚实的语义基础。
2.1 缺陷类型定义:从像素到语义的抽象层级
缺陷分类的本质是将图像中的异常区域映射到一个离散的语义标签空间。在Halcon的语境下,这个映射过程通常发生在区域(Region)或子像素轮廓(Subpixel Contour)提取之后。我们需要先定义缺陷的“类型”边界,才能让分类器有明确的输出目标。
从工程实践角度,缺陷类型定义应遵循以下三个原则:
- 互斥性:一个缺陷实例只能属于一个类别,不能出现“既是划伤又是脏污”的模糊定义。若存在复合缺陷,应单独定义复合类别。
- 可观测性:缺陷类型必须能通过图像特征(灰度、纹理、几何形状)进行区分。如果两类缺陷在图像上完全无法区分,则不应拆分为两个类别。
- 业务关联性:分类粒度应与后续工艺处理(返修、报废、放行)挂钩。例如,对于金属表面,“压伤”和“划伤”虽然都是凹陷,但返修策略不同,必须分开。
在Halcon中,缺陷类型通常通过一个整数标签(Class ID)或字符串标签(Class Name)来表示。训练数据准备阶段,我们使用tuple或dictionary来维护标签与图像样本的对应关系。一个典型的标签定义文件(例如CSV格式)如下:
class_id,class_name,description
0,scratch,线性凹槽,宽度小于0.1mm
1,contamination,表面附着异物,形状不规则
2,dent,局部凹陷,边缘光滑,深度大于0.3mm
3,hole,贯穿性孔洞,背景可见
4,edge_break,边缘崩缺,轮廓不完整这里需要特别强调:缺陷类型定义不是一次性的。在项目初期,我们可能只定义3-4个大类,但随着产线反馈的积累,会发现某些“大类”内部存在显著差异,需要进一步细分。例如,“contamination”可能包含油污(低灰度、边缘模糊)和金属屑(高灰度、边缘锐利),这两种情况在图像特征上差异巨大,混为一类会严重降低分类器的置信度。
2.2 常见工业缺陷示例:特征维度与视觉表现
为了训练有效的分类模型,我们需要理解不同缺陷在图像中的底层特征差异。下表总结了六种典型工业缺陷的视觉特征维度,这些维度将直接指导我们选择Halcon中的特征提取算子(如region_features、gray_features、texture_laws等)。
| 缺陷类型 | 典型场景 | 灰度特征 | 几何特征 | 纹理特征 |
|---|---|---|---|---|
| 划伤(Scratch) | 金属轴、玻璃面板 | 与背景对比度低,呈暗线或亮线 | 长条形,长宽比大,方向性明显 | 局部灰度突变,沿长度方向连续 |
| 脏污(Contamination) | PCB板、透镜 | 灰度值随机,可能高于或低于背景 | 形状不规则,面积大小不一 | 高频分量增加,局部熵增大 |
| 压伤(Dent) | 冲压件、外壳 | 灰度渐变,中心与边缘有过渡带 | 圆形或椭圆形,边缘光滑 | 低频变化为主,纹理被抑制 |
| 毛刺(Burr) | 精密齿轮、连接器 | 与基体灰度接近,但边缘有突起 | 附着于边缘,呈尖角或锯齿状 | 边缘梯度方向异常 |
| 气泡(Bubble) | 透明件、涂层 | 中心高亮(透光)或暗斑(反射) | 圆形,内部灰度均匀 | 边缘清晰,内部无纹理 |
| 缺料(Short Shot) | 注塑件 | 灰度低于正常区域,且边缘模糊 | 面积较大,形状与设计轮廓不符 | 表面粗糙度降低,纹理缺失 |
在实际Halcon开发中,我们通常使用create_class_mlp或create_class_svm来构建分类器,而输入特征向量正是从上述维度中提取的。例如,对于划伤,我们可能提取length、width、orientation等区域特征;对于脏污,则更依赖mean、deviation等灰度特征。
sample_images算子可以帮助你从图像序列中批量提取样本区域。
2.3 分类任务与检测任务的区别:目标、输出与评估指标
这是本章最核心的概念辨析。很多初学者将“缺陷分类”和“缺陷检测”混为一谈,导致在模型选型和评估时走入误区。
缺陷检测(Defect Detection)的任务是回答“图像中是否存在缺陷,以及缺陷在哪里”。它的输出是一个区域(Region)或边界框(Bounding Box),通常是一个像素级或区域级的定位结果。检测任务不关心这个缺陷是划伤还是脏污,只关心“有”或“无”,以及“在哪个位置”。在Halcon中,检测通常通过anomaly_detection(异常检测)、variation_model(差异模型)或传统的图像差分(difference)来实现。
缺陷分类(Defect Classification)的任务是回答“这个已知的缺陷区域属于哪一类”。它的输入是一个已经分割好的缺陷区域(通常由检测阶段提供),输出是一个类别标签及其置信度。分类任务不关心缺陷的具体位置和形状,只关心其“种类”。在Halcon中,分类通常通过classify_class_mlp、classify_class_svm或深度学习分类器(apply_dl_classifier)来实现。
两者的关系可以用下图表示:
从评估指标来看,两者的差异更为明显:
- 检测任务的评估指标是检出率(Recall)、误检率(False Alarm Rate)以及定位精度(如IoU)。我们关心的是“该检出的缺陷是否被找到”,以及“找到的区域是否准确”。
- 分类任务的评估指标是分类准确率(Accuracy)、混淆矩阵(Confusion Matrix)、精确率(Precision)和召回率(Recall)(针对每个类别)。我们关心的是“对于已检出的缺陷,类别判断是否正确”。
在Halcon中,评估分类模型通常使用test_samples_class_mlp或evaluate_class_svm,它们会返回混淆矩阵和全局准确率。而评估检测模型则使用area_intersection和area_union来计算IoU,或者通过false_positive_rate和true_positive_rate绘制ROC曲线。
variation_model)找出候选区域,再用分类器对候选区域进行精细分类。这种“检测+分类”的两级架构是工业视觉系统的标准范式。
2.4 案例:金属表面缺陷分类的工程实现
下面通过一个简化的Halcon代码片段,展示分类任务与检测任务如何协同工作。假设我们有一个金属垫圈,需要区分“划伤”和“脏污”两类缺陷。
// 第一步:检测阶段 - 使用差异模型找出异常区域
create_variation_model(50, 50, 'byte', &ModelID)
train_variation_model(ReferenceImages, ModelID)
reduce_domain(Image, InspectionRegion, ImageReduced)
compare_variation_model(ImageReduced, ModelID, &RegionDiff)
connection(RegionDiff, &ConnectedRegions)
select_shape(ConnectedRegions, &CandidateRegions, 'area', 'and', 20, 1000)

// 第二步:分类阶段 - 对每个候选区域提取特征并分类
create_class_mlp(5, 8, 2, 'softmax', 'normalization', &MLPHandle)
// 假设已经用训练样本训练好了MLPHandle

for i := 1 to |CandidateRegions| by 1
    // 提取特征:面积、长度、宽度、灰度均值、灰度方差
    area_center(CandidateRegions[i], &Area, &Row, &Column)
    feret_diameter(CandidateRegions[i], &Length, &Width)
    gray_features(ImageReduced, CandidateRegions[i], 'mean', &MeanGray)
    gray_features(ImageReduced, CandidateRegions[i], 'deviation', &DevGray)

    // 构造特征向量
    Features := [Area, Length, Width, MeanGray, DevGray]

    // 分类
    classify_class_mlp(MLPHandle, Features, 1, &ClassID, &Confidence)

    // 输出结果
    if (ClassID == 0)
        write_string(WindowHandle, '划伤,置信度:' + Confidence)
    else
        write_string(WindowHandle, '脏污,置信度:' + Confidence)
    endif
endfor在这个案例中,compare_variation_model负责检测(定位),而classify_class_mlp负责分类(识别)。两者各司其职,缺一不可。如果检测阶段漏掉了一个小划伤,那么分类阶段再准确也无法将其找回;反之,如果检测阶段产生了大量误检区域,分类阶段就需要处理大量无意义的候选区域,降低系统效率。
2.5 误区与复盘:分类模型训练中的常见陷阱
在多年的Halcon项目交付中,我们总结了以下四个高频误区,它们往往导致模型训练失败或上线后效果不佳。
weight参数为不同类别设置不同的误分类代价。
region_features)、灰度特征(gray_features)和纹理特征(texture_laws或cooc_feature_image)。在Halcon中,可以使用select_features算子进行特征筛选,剔除冗余维度。
classify_class_mlp返回的Confidence值来实现这一逻辑。
复盘一个真实案例:某汽车零部件供应商在训练压伤分类器时,只采集了光亮表面的压伤样本。上线后,遇到哑光表面的压伤,分类器将其误判为脏污。原因在于,哑光表面的灰度方差远大于光亮表面,导致灰度特征失效。解决方案是重新采集样本,并在特征向量中加入基于局部二值模式(LBP)的纹理特征,最终将准确率从82%提升至96%。这个案例告诉我们,缺陷类型定义必须覆盖所有工艺变体,特征选择必须与表面状态解耦。
综上所述,缺陷分类不是简单的“贴标签”过程,而是需要深入理解缺陷的物理本质、图像表现和业务语义。只有清晰地区分分类任务与检测任务,合理定义缺陷类型,并规避常见的训练陷阱,才能构建出真正稳定可靠的Halcon缺陷分类系统。