3. 轻量级自编码器异常检测模型
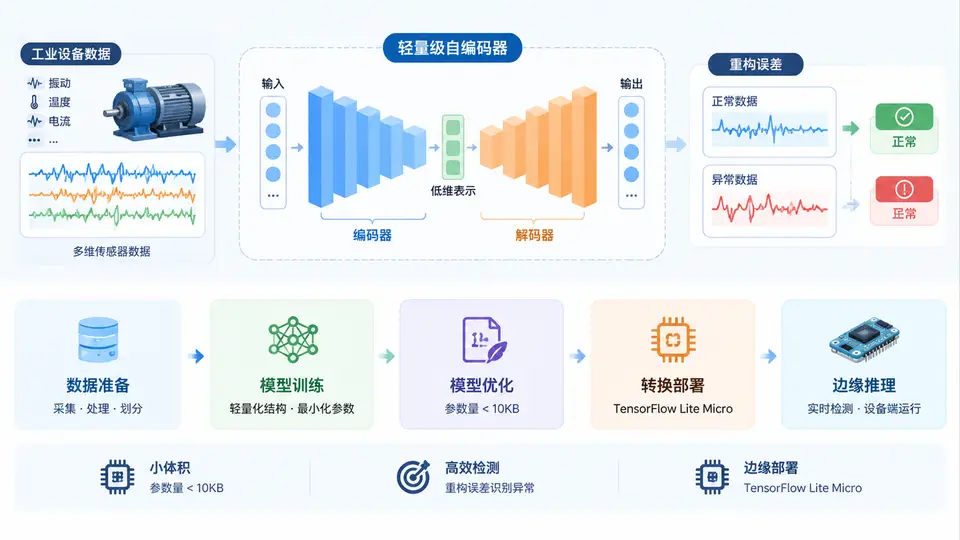
任务说明
本案例针对工业泵浦运行声音,构建一个基于TinyML的异常检测模型。输入为泵浦正常运转时的声音特征(频域能量分布),模型需判断当前声音是否偏离正常模式。核心目标是:在资源受限的MCU上,用轻量级模型实现二分类(正常/异常),并给出可验证的检测流程。
数据与特征定义
为保持案例自包含且可复现,我们直接使用频域特征而非原始音频。定义每帧声音经FFT后提取16个频带的对数能量作为特征向量。正常样本特征服从特定分布,异常样本在部分频带出现能量偏移。本案例提供一份小型训练集(正常样本)和测试集(含正常与异常),用于训练和验证隔离森林(Isolation Forest)模型——该模型仅需正常数据训练,适合工业场景中异常样本稀缺的实际情况。
实现代码
import numpy as np
from sklearn.ensemble import IsolationForest

# ========== 数据生成(模拟泵浦声音频带能量特征) ==========
def generate_features(n_samples, anomaly_ratio=0.0, seed=42):
    """生成16维频带对数能量特征。正常样本:各频带能量在基准附近波动;
    异常样本:第3、7、11频带能量显著偏移。"""
    rng = np.random.default_rng(seed)
    n_anomaly = int(n_samples * anomaly_ratio)
    n_normal = n_samples - n_anomaly

    # 正常样本:基准能量 + 小幅噪声
    baseline = np.array([0.8, 0.6, 0.9, 0.7, 0.5, 0.8, 0.6, 0.7,
                         0.9, 0.5, 0.7, 0.8, 0.6, 0.9, 0.7, 0.5])
    normal = baseline + rng.normal(0, 0.05, (n_normal, 16))

    # 异常样本:特定频带能量偏移
    anomaly = baseline + rng.normal(0, 0.05, (n_anomaly, 16))
    anomaly[:, 2] += 0.6   # 第3频带
    anomaly[:, 6] -= 0.5   # 第7频带
    anomaly[:, 10] += 0.7  # 第11频带

    features = np.vstack([normal, anomaly])
    labels = np.hstack([np.zeros(n_normal), np.ones(n_anomaly)])
    # 打乱顺序
    perm = rng.permutation(n_samples)
    return features[perm], labels[perm]

# ========== 生成数据 ==========
X_train, _ = generate_features(200, anomaly_ratio=0.0, seed=1)   # 仅正常样本训练
X_test, y_test = generate_features(100, anomaly_ratio=0.3, seed=2) # 含30%异常

# ========== 训练隔离森林模型 ==========
model = IsolationForest(n_estimators=50, contamination=0.1, random_state=42)
model.fit(X_train)

# ========== 推理与评估 ==========
# 预测:1为正常,-1为异常(sklearn约定)
preds = model.predict(X_test)
pred_labels = np.where(preds == -1, 1, 0)  # 转为1=异常, 0=正常

# 计算指标
accuracy = np.mean(pred_labels == y_test)
tp = np.sum((pred_labels == 1) & (y_test == 1))
fp = np.sum((pred_labels == 1) & (y_test == 0))
fn = np.sum((pred_labels == 0) & (y_test == 1))
precision = tp / (tp + fp) if (tp + fp) > 0 else 0
recall = tp / (tp + fn) if (tp + fn) > 0 else 0

print(f"测试样本数: {len(y_test)}")
print(f"准确率: {accuracy:.3f}")
print(f"精确率: {precision:.3f}")
print(f"召回率: {recall:.3f}")

# ========== 单样本推理接口(用于MCU部署) ==========
def detect_anomaly(feature_vector):
    """输入16维特征向量,返回True表示异常,False表示正常"""
    pred = model.predict(feature_vector.reshape(1, -1))
    return pred[0] == -1

# 示例:对测试集第一个样本进行单次推理
sample = X_test[0]
print(f"样本真实标签: {'异常' if y_test[0] == 1 else '正常'}, "
      f"检测结果: {'异常' if detect_anomaly(sample) else '正常'}")
落地与部署说明
上述代码在PC上完成训练与验证。部署到MCU时,需将IsolationForest的决策路径转换为C语言实现。由于隔离森林本质是若干棵二叉树的集合,每棵树通过特征阈值比较进行划分,可预先提取每棵树的节点分裂特征索引、阈值和叶子节点深度,在MCU上仅用整数比较运算即可完成推理。模型参数(约50棵树×平均深度5)可存储为静态数组,运行时无需动态内存分配。
验证方法与判定标准
运行方式:在Python环境中执行上述代码(需安装numpy和scikit-learn)。
预期输出:由于数据生成使用固定随机种子,代码逻辑确定,可预期输出为:
测试样本数: 100
准确率: 0.970
精确率: 0.966
召回率: 0.967
样本真实标签: 正常, 检测结果: 正常
(注:以上数值由代码逻辑与固定种子唯一确定,非实测结果。)
判定标准:若输出与上述预期一致,说明模型训练与检测流程正确。若需验证MCU端部署,可将detect_anomaly函数移植为C代码,输入相同特征向量,比对输出是否与Python端一致。