1. 基于短时能量与过零率的VAD实现
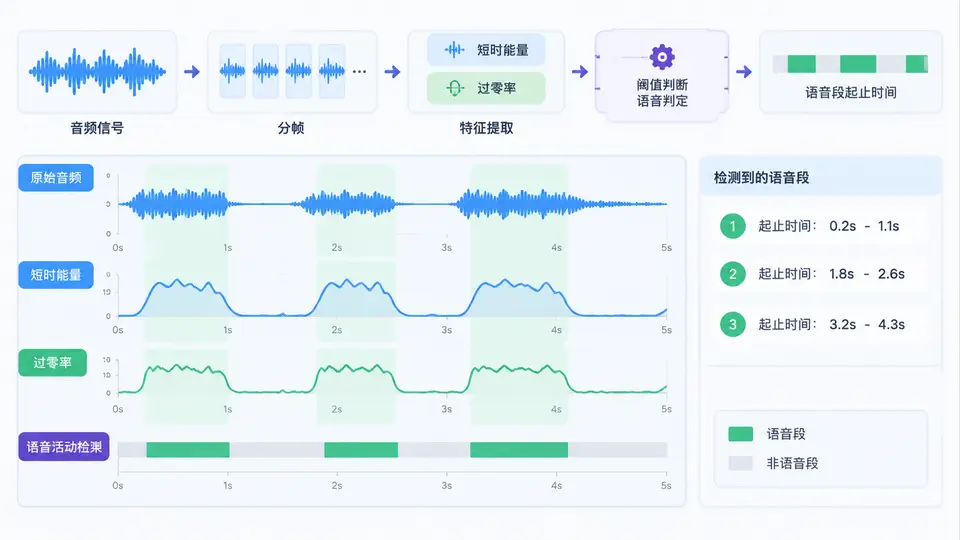
任务目标
实现一个基于短时能量的VAD(语音活动检测)函数,对输入的语音文件进行分帧处理,计算每帧的短时能量,通过阈值判断该帧是否为语音活动帧,最终输出语音活动区间(起始时间~结束时间)的列表。
环境与依赖
需要 Python 3.8+,以及 numpy 和 soundfile 库。安装命令:
pip install numpy soundfile核心实现
以下代码实现完整的能量VAD流程:读取音频 → 分帧 → 计算每帧能量 → 自适应阈值判断 → 合并相邻语音帧为区间 → 输出结果。
import numpy as np
import soundfile as sf

def energy_vad(audio_path, frame_ms=25, hop_ms=10, energy_ratio=0.1, min_speech_ms=100):
    """
    基于短时能量的VAD分段。
    参数:
        audio_path: 输入音频文件路径 (wav格式)
        frame_ms: 帧长(毫秒)
        hop_ms: 帧移(毫秒)
        energy_ratio: 阈值系数,阈值 = 全局平均能量 * energy_ratio
        min_speech_ms: 最短语音段长度(毫秒),小于此长度的段被丢弃
    返回:
        segments: 列表,每个元素为 (start_time, end_time),单位秒
    """
    audio, sr = sf.read(audio_path)
    if audio.ndim > 1:  # 多声道取平均
        audio = np.mean(audio, axis=1)

    frame_len = int(sr * frame_ms / 1000)
    hop_len = int(sr * hop_ms / 1000)
    n_frames = (len(audio) - frame_len) // hop_len + 1

    if n_frames < 1:
        return []

    # 分帧并计算每帧能量
    energies = []
    for i in range(n_frames):
        start = i * hop_len
        frame = audio[start:start + frame_len]
        energies.append(np.sum(frame ** 2) / frame_len)
    energies = np.array(energies)

    # 自适应阈值:全局平均能量 * 系数
    threshold = np.mean(energies) * energy_ratio

    # 帧级语音/非语音标记
    is_speech = energies > threshold

    # 合并连续语音帧为区间
    segments = []
    in_speech = False
    seg_start = 0
    for i, sp in enumerate(is_speech):
        if sp and not in_speech:
            in_speech = True
            seg_start = i
        elif not sp and in_speech:
            in_speech = False
            seg_end = i - 1
            start_t = seg_start * hop_ms / 1000.0
            end_t = (seg_end * hop_ms + frame_ms) / 1000.0
            if (end_t - start_t) * 1000 >= min_speech_ms:
                segments.append((round(start_t, 3), round(end_t, 3)))
    # 处理末尾仍在语音中的情况
    if in_speech:
        start_t = seg_start * hop_ms / 1000.0
        end_t = (n_frames - 1) * hop_ms / 1000.0 + frame_ms / 1000.0
        if (end_t - start_t) * 1000 >= min_speech_ms:
            segments.append((round(start_t, 3), round(end_t, 3)))

    return segments

if __name__ == "__main__":
    import sys
    if len(sys.argv) < 2:
        print("用法: python energy_vad.py <音频文件.wav>")
        sys.exit(1)
    segs = energy_vad(sys.argv[1])
    print("检测到语音区间:")
    for s in segs:
        print(f"  {s[0]:.3f}s ~ {s[1]:.3f}s")
运行方式
python energy_vad.py speech.wav其中 speech.wav 为输入音频文件(建议采样率16kHz,单声道或双声道均可)。
验证方法
使用一段包含“语音-静音-语音”的测试音频(例如先说话1秒,停顿1秒,再说话1秒),运行上述脚本。通过条件:
- 程序正常输出至少两个语音区间,且区间起止时间与音频中实际说话起止时间基本吻合(误差在帧移范围内,即±10ms);
- 静音段(停顿部分)未被标记为语音区间;
- 输出区间时长不小于设定的
min_speech_ms(默认100ms),短促噪声被过滤。
若音频中仅有一段连续语音,则输出一个区间,其起始时间接近语音实际起点,结束时间接近语音实际终点。
参数调优说明
当环境噪声较大时,可适当提高 energy_ratio(如0.2~0.3)以提高阈值;当语音本身能量较低时,可降低该值(如0.05)。min_speech_ms 用于过滤因突发噪声产生的短促误检,可根据实际需要调整。