4. PCAP文件格式解析与字段级读取
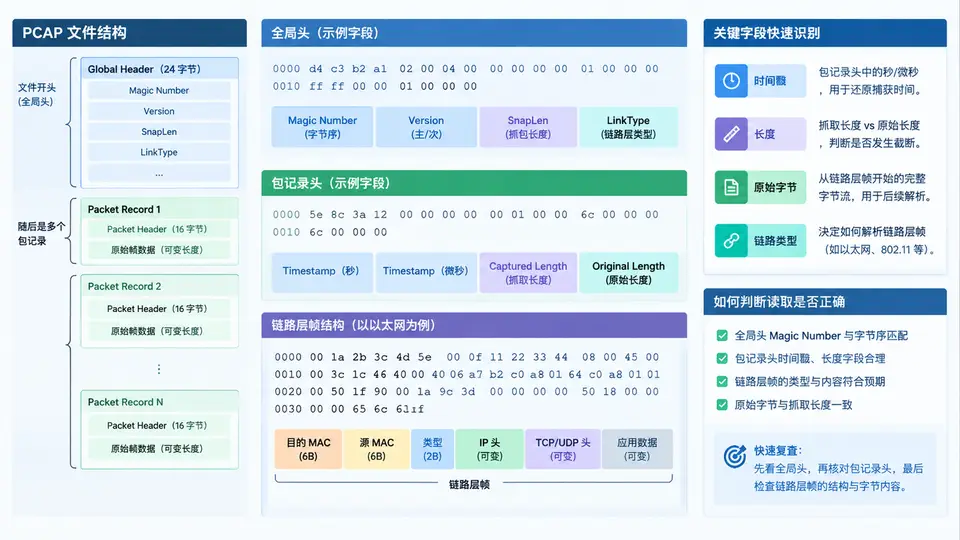
PCAP 文件的三层结构
PCAP 文件由固定 24 字节的全局头、紧随其后的若干条包记录、以及每条记录携带的原始链路层帧组成。解析时按“全局头 → 包记录头 → 帧字节”的顺序逐层推进,任何一层长度算错都会导致后续记录错位。
- 全局头(24 B):magic number 决定字节序与时间精度;version 为 2.4;snaplen 是抓包时截断长度;network 是链路类型(1 = Ethernet)。
- 包记录头(16 B):ts_sec / ts_usec 为时间戳;incl_len 是文件内实际保存的字节数;orig_len 是线上原始帧长。当 incl_len < orig_len 说明被 snaplen 截断。
- 帧数据:长度等于 incl_len,内容是以太网帧(含目的 MAC、源 MAC、EtherType 及载荷)。
用 Python 逐字段读取并验证
下面代码不依赖 scapy 等高层库,直接用 struct 按偏移读取,便于观察每个字段的真实字节。示例文件为教学构造的 3 包 PCAP,包含一条被 snaplen 截断的记录。
import struct

def parse_pcap(path):
    with open(path, "rb") as f:
        data = f.read()

    # ---- 全局头 24B ----
    magic = data[0:4]
    if magic == b"\xd4\xc3\xb2\xa1":
        endian = "<"          # 小端
    elif magic == b"\xa1\xb2\xc3\xd4":
        endian = ">"          # 大端
    else:
        raise ValueError("不是标准 PCAP 文件")

    ver_major, ver_minor, thiszone, sigfigs, snaplen, network = \
        struct.unpack(endian + "HHiIII", data[4:24])

    print(f"字节序={endian}  版本={ver_major}.{ver_minor}  "
          f"snaplen={snaplen}  network={network}")

    # ---- 逐条包记录 ----
    offset = 24
    idx = 0
    while offset + 16 <= len(data):
        ts_sec, ts_usec, incl_len, orig_len = \
            struct.unpack(endian + "IIII", data[offset:offset+16])
        offset += 16

        frame = data[offset:offset+incl_len]
        offset += incl_len
        idx += 1

        # 链路层帧解析(Ethernet)
        dst_mac = ":".join(f"{b:02x}" for b in frame[0:6])
        src_mac = ":".join(f"{b:02x}" for b in frame[6:12])
        ethertype = struct.unpack(">H", frame[12:14])[0]

        truncated = "截断" if incl_len < orig_len else "完整"
        print(f"#{idx} ts={ts_sec}.{ts_usec:06d} "
              f"incl={incl_len} orig={orig_len} [{truncated}]")
        print(f"   dst={dst_mac} src={src_mac} "
              f"ethertype=0x{ethertype:04x}")

    print(f"共读取 {idx} 条记录,文件总长 {len(data)} 字节")

parse_pcap("sample.pcap")
验证读取正确性的三个检查点
- 偏移闭合检查:循环结束后
offset应恰好等于文件总长度。若不等,说明某条记录的 incl_len 被误读或字节序判断错误。 - 长度一致性检查:每条记录满足
incl_len ≤ orig_len且incl_len ≤ snaplen。违反则文件损坏或解析偏移错位。 - 帧结构检查:当 network=1 时,每条帧长度至少 14 字节(6+6+2),EtherType 常见值为 0x0800(IPv4)、0x86dd(IPv6)、0x8100(VLAN)。
若 magic 为
0xa1b2c3d4 但按小端读取后 snaplen 出现异常大值(如 0x01000000 级别),说明字节序判断反了,应切换为 > 重新解包。PCAP 的 ts_usec 字段在纳秒精度变体中实际为 ts_nsec,magic 为
0xa1b23c4d。若直接按微秒解释,时间戳会放大 1000 倍,需先根据 magic 区分精度。关键字段速查
| 层级 | 字段 | 偏移 | 长度 | 判读要点 |
|---|---|---|---|---|
| 全局头 | magic | 0 | 4 B | d4c3b2a1=小端微秒;a1b23c4d=小端纳秒 |
| 全局头 | snaplen | 16 | 4 B | 抓包截断上限,通常 65535 或 262144 |
| 全局头 | network | 20 | 4 B | 1=Ethernet,101=Raw IP,113=Linux SLL |
| 记录头 | ts_sec / ts_usec | 0 / 4 | 4+4 B | 秒 + 微秒(或纳秒) |
| 记录头 | incl_len | 8 | 4 B | 文件内实际字节数,决定帧数据读取长度 |
| 记录头 | orig_len | 12 | 4 B | 线上原始长度,与 incl_len 比较判断截断 |
| 帧 | dst / src MAC | 0 / 6 | 6+6 B | 十六进制冒号分隔 |
| 帧 | EtherType | 12 | 2 B | 大端读取,0x0800=IPv4 |