3. 信息泄露与敏感文件路径探测
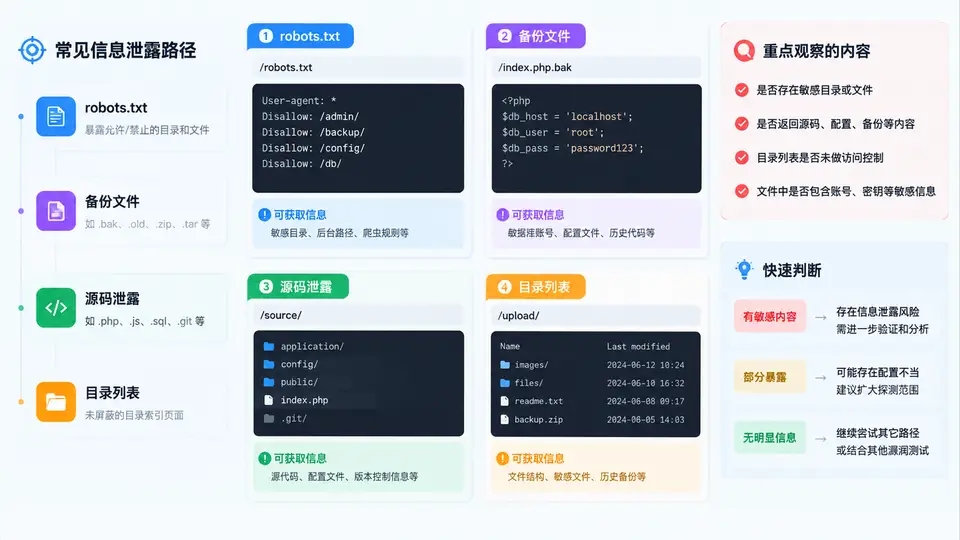
探测目标与常见泄露面
信息泄露路径探测的核心不是“扫目录”,而是围绕站点可能无意暴露的文件与接口,构造少量高价值请求并判读响应。常见对象包括:
- robots.txt / sitemap.xml:声明爬虫规则与站点地图,常暴露后台、测试、上传等路径。
- 备份与临时文件:如
index.php.bak、www.zip、config.php~、.index.php.swp。 - 源码与配置泄露:
.git/HEAD、.svn/entries、.env、web.config、composer.json。 - 目录列表:服务器未关闭
autoindex时,访问目录返回文件清单。 - 错误页与调试信息:堆栈、绝对路径、数据库连接串、框架版本。
请求构造与判读逻辑
对每个候选路径发送 GET 请求,重点观察状态码、Content-Type、Content-Length 与响应体特征。下面给出一个可运行的 Python 探测脚本,使用标准库即可执行,不依赖第三方包。
import urllib.request, urllib.error, re, sys

TARGET = "http://127.0.0.1:8080"   # 替换为授权测试目标
PATHS = [
    "/robots.txt", "/sitemap.xml",
    "/.git/HEAD", "/.svn/entries", "/.env",
    "/backup.zip", "/www.zip", "/db.sql",
    "/index.php.bak", "/config.php~", "/.index.php.swp",
    "/uploads/", "/admin/", "/static/",
]

# 命中敏感信息的特征(示例,可按目标技术栈扩展)
SENSITIVE = [
    (r"DB_PASSWORD|DB_USER|APP_KEY", "配置变量"),
    (r"ref:\s*refs/heads", "Git 仓库引用"),
    (r"<title>Index of /", "目录列表"),
    (r"root:.*:0:0:", "passwd 内容"),
    (r"mysql_connect|SQLSTATE", "数据库错误"),
]

def probe(base, path):
    url = base.rstrip("/") + path
    req = urllib.request.Request(url, method="GET",
                                 headers={"User-Agent": "SecTest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=5) as r:
            body = r.read(4096).decode("utf-8", "ignore")
            return r.status, r.headers.get("Content-Type", ""), len(body), body
    except urllib.error.HTTPError as e:
        body = e.read(2048).decode("utf-8", "ignore")
        return e.code, e.headers.get("Content-Type", ""), len(body), body
    except Exception as e:
        return None, str(e), 0, ""

for p in PATHS:
    code, ctype, size, body = probe(TARGET, p)
    if code is None:
        print(f"[ERR ] {p:24} {ctype}")
        continue
    hits = [name for pat, name in SENSITIVE if re.search(pat, body, re.I)]
    flag = "HIT " if hits else "    "
    print(f"[{flag}] {code} {p:24} {ctype:28} {size:5}B  {','.join(hits)}")
运行后按以下规则判读:
- 200 + 敏感特征命中:确认泄露,记录 URL、命中字段与响应片段。
- 200 但无敏感特征:可能是正常页面或软 404,需对比首页响应长度与内容。
- 403:路径存在但被拒绝,仍属信息泄露(暴露了目录结构)。
- 301/302 跳转:记录 Location,可能指向真实资源。
- 404 且与随机路径响应一致:视为不存在。
先用一个随机路径(如
/a1b2c3x/)获取“基线 404 响应”,再与候选路径对比长度和内容,可显著降低软 404 误报。泄露路径与判读关系图
验证与证据留存
确认泄露后,需要保留可复核的证据。建议记录以下字段:
| 字段 | 示例值 | 用途 |
|---|---|---|
| 请求 URL | http://target/.env | 定位泄露点 |
| 状态码 | 200 | 判断可访问性 |
| Content-Type | text/plain | 判断文件类型 |
| 命中特征 | DB_PASSWORD=... | 证明敏感信息 |
| 响应片段 | 前 200 字符 | 复核与报告 |
仅在获得明确授权的目标上执行探测。对生产环境应控制请求频率,避免触发防护或影响业务;发现真实泄露后应通过安全渠道上报,不要公开传播敏感内容。
常见误报与排除
- 软 404:服务器对不存在路径返回 200 和自定义页面。用基线对比排除。
- WAF 拦截页:返回 200 但内容是拦截提示,不含真实文件内容。
- CDN 缓存:缓存了旧版本页面,需加随机参数或检查缓存头。
- 编码差异:响应体为 gzip 或非 UTF-8,需先解码再匹配特征。