1. OCT光谱原始干涉信号读取与格式解析
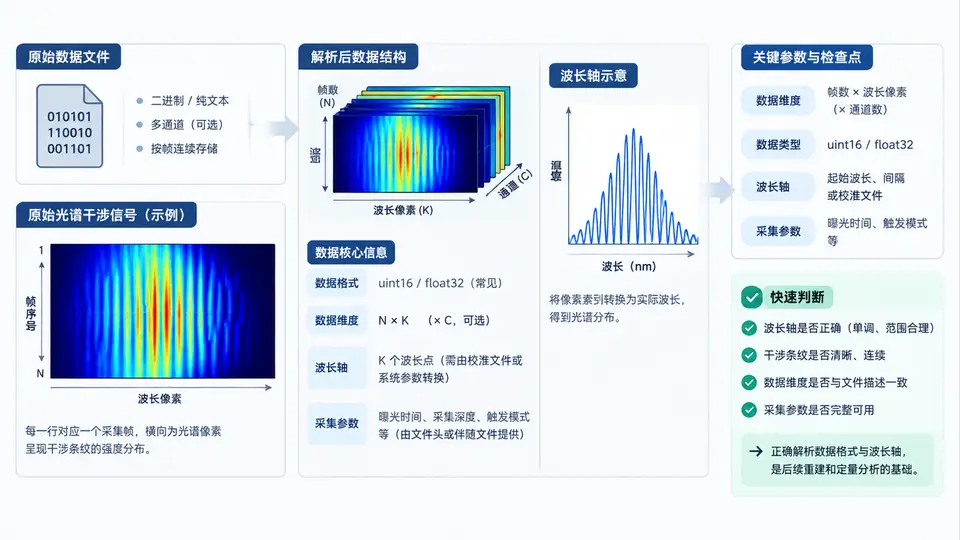
原始光谱干涉信号的文件形态
OCT 系统采集到的原始光谱干涉信号,通常由线阵相机或平衡探测器输出,保存为二进制或文本文件。常见格式包括:
- 二进制原始帧:每帧按 A-line 顺序排列,每个采样点为 16 位无符号整数(uint16),文件头可能包含帧数、每帧 A-line 数、每 A-line 采样点数等元信息。
- 文本/CSV:每行一条 A-line,列对应波长采样点,便于快速查看但体积大。
- 厂商私有格式:如 .oct、.raw 等,需结合采集软件导出的参数文件(波长标定、曝光、增益)一起解析。
无论哪种格式,解析的核心都是建立四元组:数据矩阵 (A-line 数 × 采样点数)、波长轴、波数轴、采集参数。只有这四者对齐,后续去背景、重采样和 FFT 才有意义。
解析流程与关键参数
以最常见的 uint16 二进制帧为例,解析步骤为:
- 读取文件头或伴随的参数文件,获取
width(每 A-line 采样点数)、height(A-line 数)、bit_depth、endianness。 - 按
np.fromfile(path, dtype='<u2')读入一维数组,再reshape(height, width)得到二维光谱矩阵。 - 读取波长标定文件,得到每个采样点对应的中心波长 λ(i),通常为线性或多项式映射。
- 由 λ 计算波数 k = 2π/λ,检查 k 是否单调,为后续重采样做准备。
- 记录曝光时间、参考臂功率、是否已做 K-clock 等采集参数,写入元数据字典。
若文件头缺失,可通过文件总字节数反推:
总字节数 / 2 / width = height,再用已知的 A-line 数验证。数据入口的校验要点
解析完成后,必须做三项快速校验,避免把错误数据带入后续处理:
- 维度校验:
spectra.shape == (height, width),且width与波长标定点数一致。 - 数值范围校验:uint16 数据应在 0–65535 之间,若大量出现 0 或 65535,可能是饱和或丢帧。
- 波长轴校验:λ 应单调递增,k 应单调递减(或递增,取决于定义),且相邻 k 间隔不均匀——这正是后续需要重采样的原因。
可复用的解析代码骨架
以下代码给出一个最小可运行的解析入口,假设数据为小端 uint16 二进制,参数由外部字典传入:
import numpy as np

def load_oct_spectra(raw_path, width, height, lambda_path=None):
    # 1. 读取二进制光谱矩阵
    data = np.fromfile(raw_path, dtype='<u2')
    if data.size != width * height:
        raise ValueError(f"文件大小不匹配: {data.size} != {width*height}")
    spectra = data.reshape(height, width)

    # 2. 读取波长标定
    if lambda_path:
        lam = np.loadtxt(lambda_path, delimiter=',')
    else:
        lam = np.linspace(1250, 1350, width)  # 示例默认值,需替换为实际标定

    # 3. 计算波数轴
    k = 2 * np.pi / (lam * 1e-9)  # 单位: rad/m

    # 4. 组装元数据
    meta = {
        'width': width,
        'height': height,
        'bit_depth': 16,
        'endianness': 'little',
        'lambda_range_nm': (lam.min(), lam.max()),
        'k_monotonic': bool(np.all(np.diff(k) > 0) or np.all(np.diff(k) < 0)),
    }
    return spectra, lam, k, meta

# 示例调用
spectra, lam, k, meta = load_oct_spectra(
    'spectra.raw', width=2048, height=500, lambda_path='lambda_calib.csv'
)
print(spectra.shape, lam.shape, k.shape)
print(meta)
运行后应输出 (500, 2048) (2048,) (2048,) 以及元数据字典。若 k_monotonic 为 False,说明波长标定存在跳变或重复点,需要先修正标定文件再继续。
常见格式陷阱与处理
| 现象 | 可能原因 | 处理方式 |
|---|---|---|
| reshape 报错 | 文件头字节未跳过 | 先读文件头长度,再 np.fromfile(offset=header_bytes) |
| 图像呈条纹状错位 | 字节序错误 | 改用 dtype='>u2' 大端读取 |
| 波长轴与采样点不匹配 | 标定文件列数或顺序错误 | 检查 CSV 列名与 width 是否一致 |
| k 非单调 | 标定多项式过拟合或数据缺失 | 剔除异常点后重新拟合 λ(i) |
不要跳过维度校验直接进入 FFT。若
width 与波长标定点数不一致,后续重采样会静默产生错误结果,且难以从图像上直接发现。