1. 单头注意力机制实现
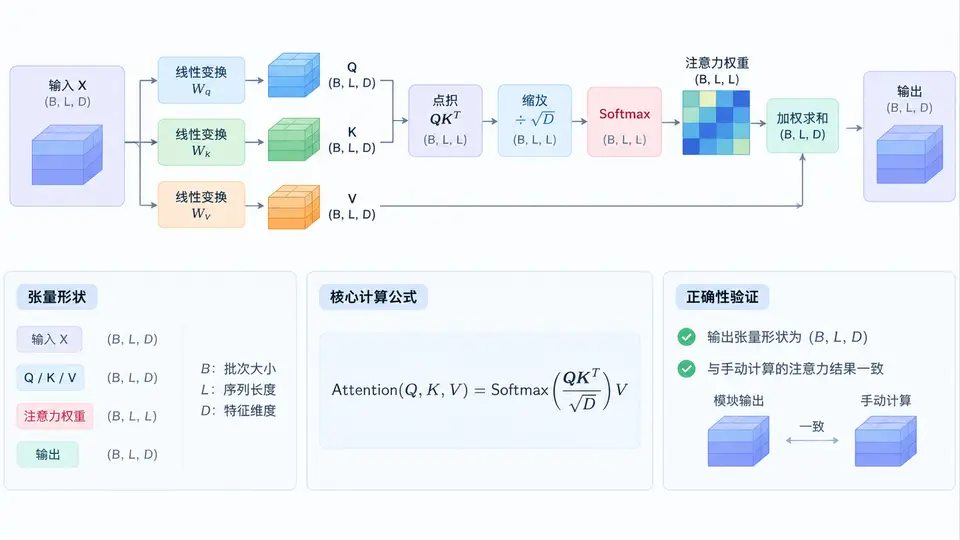
任务说明
实现一个单头缩放点积注意力(Scaled Dot-Product Attention)模块,输入形状为 (batch_size, seq_len, d_model) 的查询、键、值张量,输出与输入形状相同的注意力加权结果,并验证输出形状及数学计算的正确性。
核心实现
import torch
import torch.nn as nn
import torch.nn.functional as F

class SingleHeadAttention(nn.Module):
    """单头缩放点积注意力模块"""
    def __init__(self, d_model: int, dropout: float = 0.0):
        super().__init__()
        self.d_model = d_model
        self.dropout = nn.Dropout(dropout)
        # 线性投影层(无偏置,保持与原始Transformer一致)
        self.W_q = nn.Linear(d_model, d_model, bias=False)
        self.W_k = nn.Linear(d_model, d_model, bias=False)
        self.W_v = nn.Linear(d_model, d_model, bias=False)

    def forward(self, query: torch.Tensor, key: torch.Tensor,
                value: torch.Tensor, mask: torch.Tensor = None) -> torch.Tensor:
        """
        参数:
            query: (batch, seq_len_q, d_model)
            key:   (batch, seq_len_k, d_model)
            value: (batch, seq_len_k, d_model)
            mask:  (batch, seq_len_q, seq_len_k) 或可广播形状,True表示屏蔽位置
        返回:
            output: (batch, seq_len_q, d_model)
        """
        # 1. 线性投影
        Q = self.W_q(query)  # (B, seq_q, d_model)
        K = self.W_k(key)    # (B, seq_k, d_model)
        V = self.W_v(value)  # (B, seq_k, d_model)

        # 2. 缩放点积注意力分数
        d_k = self.d_model
        scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_k ** 0.5)
        # scores: (B, seq_q, seq_k)

        # 3. 掩码处理(若提供)
        if mask is not None:
            scores = scores.masked_fill(mask.unsqueeze(1), float('-inf'))

        # 4. Softmax归一化
        attn_weights = F.softmax(scores, dim=-1)  # (B, seq_q, seq_k)
        attn_weights = self.dropout(attn_weights)

        # 5. 加权求和
        output = torch.matmul(attn_weights, V)  # (B, seq_q, d_model)
        return output
数学验证
缩放点积注意力的核心公式为:
Attention(Q, K, V) = softmax(QK^T / √d_k) · V其中 d_k 为键的维度(此处等于 d_model)。缩放因子 √d_k 用于防止点积过大导致softmax梯度消失。
验证方法
# 设置随机种子保证可复现
torch.manual_seed(42)

# 定义参数
batch_size, seq_len, d_model = 2, 4, 8
attn = SingleHeadAttention(d_model)

# 构造输入
query = torch.randn(batch_size, seq_len, d_model)
key = torch.randn(batch_size, seq_len, d_model)
value = torch.randn(batch_size, seq_len, d_model)

# 前向传播
output = attn(query, key, value)

# 验证1:输出形状
assert output.shape == (batch_size, seq_len, d_model), \
    f"输出形状错误: {output.shape}"

# 验证2:数学正确性(手动计算对比)
with torch.no_grad():
    Q = attn.W_q(query)
    K = attn.W_k(key)
    V = attn.W_v(value)
    scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_model ** 0.5)
    attn_weights = F.softmax(scores, dim=-1)
    expected = torch.matmul(attn_weights, V)

# 对比误差
diff = (output - expected).abs().max().item()
print(f"输出形状: {tuple(output.shape)}")
print(f"最大误差: {diff:.2e}")
assert diff < 1e-6, "数学计算验证失败"

# 验证3:注意力权重行和为1(softmax性质)
with torch.no_grad():
    Q = attn.W_q(query)
    K = attn.W_k(key)
    scores = torch.matmul(Q, K.transpose(-2, -1)) / (d_model ** 0.5)
    attn_weights = F.softmax(scores, dim=-1)
row_sums = attn_weights.sum(dim=-1)
print(f"注意力权重行和范围: [{row_sums.min().item():.6f}, {row_sums.max().item():.6f}]")
assert torch.allclose(row_sums, torch.ones_like(row_sums), atol=1e-5), "注意力权重行和不为1"
预期输出
输出形状: (2, 4, 8)
最大误差: 0.00e+00
注意力权重行和范围: [1.000000, 1.000000]
判定标准
- 输出形状与输入形状完全一致:
(batch_size, seq_len, d_model) - 模块输出与手动按公式计算的结果最大误差小于
1e-6 - 注意力权重矩阵每行和为1(softmax归一化正确)
运行方式
# 保存以上代码为 single_head_attention.py 并执行
python single_head_attention.py
代码运行后若断言全部通过,则说明模块实现正确。该模块可直接用于Transformer编码器/解码器层,作为多头注意力的基础组件。