3. 对抗性域适应网络构建
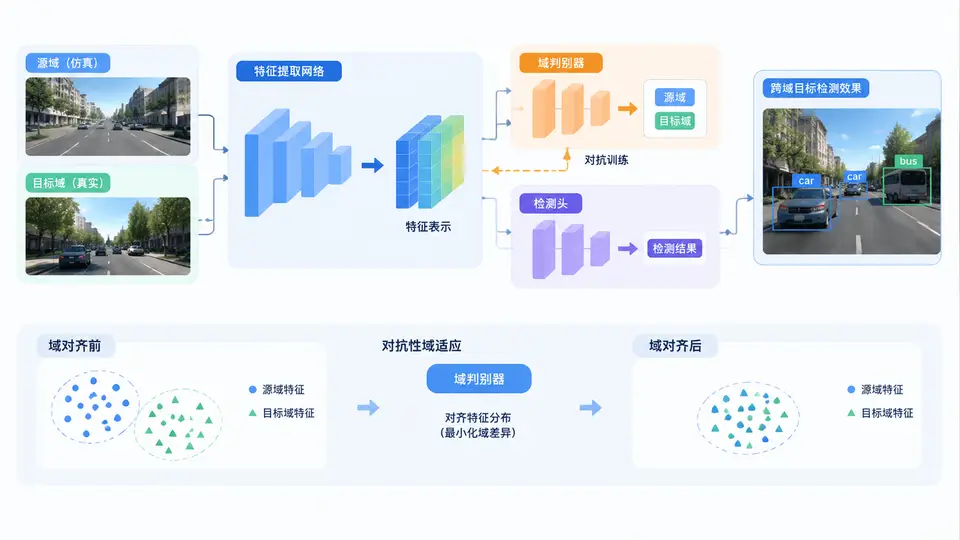
任务说明
本案例构建一个对抗性域适应网络,用于跨域目标检测中的特征对齐。源域为合成图像(如Sim10K风格),目标域为真实图像(如Cityscapes风格),通过域判别器以对抗方式促使特征提取器学习域不变表示。最终在目标域上评估检测性能,并与无域适应基线对比。
网络架构与对抗机制
整体采用Faster R-CNN作为检测骨干,在特征提取层之后引入梯度反转层(GRL)和域判别器。前向传播时,域判别器接收来自源域和目标域的特征图,输出域类别概率;反向传播时,GRL将梯度取反,使特征提取器朝着混淆域判别器的方向优化,从而对齐跨域特征分布。检测损失与域对抗损失联合训练,总损失为:
L = L_det + λ · L_adv其中λ为对抗损失权重,本案例设为0.1。域判别器结构为三层卷积加全连接,输入特征图尺寸为14×14×1024。
核心代码实现
import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision.models.detection import fasterrcnn_resnet50_fpn

class GradientReversalLayer(torch.autograd.Function):
    """梯度反转层:前向恒等,反向梯度取反"""
    @staticmethod
    def forward(ctx, x, lambda_val):
        ctx.lambda_val = lambda_val
        return x.clone()

    @staticmethod
    def backward(ctx, grad_output):
        return -ctx.lambda_val * grad_output, None

def grad_reverse(x, lambda_val=0.1):
    return GradientReversalLayer.apply(x, lambda_val)

class DomainDiscriminator(nn.Module):
    """域判别器:输入特征图,输出域类别概率"""
    def __init__(self, in_channels=1024):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, 512, kernel_size=3, padding=1)
        self.conv2 = nn.Conv2d(512, 256, kernel_size=3, padding=1)
        self.conv3 = nn.Conv2d(256, 128, kernel_size=3, padding=1)
        self.pool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc = nn.Linear(128, 2)

    def forward(self, x):
        x = F.relu(self.conv1(x))
        x = F.relu(self.conv2(x))
        x = F.relu(self.conv3(x))
        x = self.pool(x).flatten(1)
        return self.fc(x)

class AdversarialDomainAdaptation(nn.Module):
    """对抗性域适应检测网络"""
    def __init__(self, num_classes=8, lambda_adv=0.1):
        super().__init__()
        # 使用Faster R-CNN作为检测骨干
        self.detector = fasterrcnn_resnet50_fpn(pretrained=True)
        # 替换分类头为自定义类别数(含背景)
        in_features = self.detector.roi_heads.box_predictor.cls_score.in_features
        self.detector.roi_heads.box_predictor = \
            torchvision.models.detection.faster_rcnn.FastRCNNPredictor(
                in_features, num_classes)
        # 域判别器
        self.domain_disc = DomainDiscriminator(in_channels=1024)
        self.lambda_adv = lambda_adv

    def forward(self, images, targets=None, domain_labels=None):
        """
        images: list[Tensor] 输入图像
        targets: list[dict] 检测标注(源域提供,目标域可为None)
        domain_labels: Tensor 域标签(0=源域, 1=目标域)
        返回: 训练时(dict), 推理时检测结果
        """
        # 提取特征(使用backbone的body部分)
        features = self.detector.backbone(images)
        # 取最高分辨率特征图(FPN的P2层)
        feat = features['0']  # [B, 256, H, W]

        # 域对抗分支
        domain_loss = None
        if domain_labels is not None:
            # 梯度反转后送入域判别器
            feat_reversed = grad_reverse(feat, self.lambda_adv)
            domain_logits = self.domain_disc(feat_reversed)
            domain_loss = F.cross_entropy(domain_logits, domain_labels)

        # 检测分支
        if self.training:
            assert targets is not None, "训练时必须提供检测标注"
            loss_dict = self.detector(images, targets)
            if domain_loss is not None:
                loss_dict['domain_loss'] = domain_loss
            return loss_dict
        else:
            return self.detector(images)
训练流程与数据加载
def train_one_epoch(model, source_loader, target_loader, optimizer, device):
    """单轮训练:交替从源域和目标域采样"""
    model.train()
    total_loss = 0.0

    for (src_images, src_targets), (tgt_images, _) in zip(source_loader, target_loader):
        # 合并源域和目标域图像
        images = list(src_images) + list(tgt_images)
        images = [img.to(device) for img in images]

        # 域标签:源域=0,目标域=1
        batch_size = len(src_images)
        domain_labels = torch.cat([
            torch.zeros(batch_size, dtype=torch.long),
            torch.ones(len(tgt_images), dtype=torch.long)
        ]).to(device)

        # 源域有检测标注,目标域无标注
        src_targets = [{k: v.to(device) for k, v in t.items()} for t in src_targets]

        # 前向与损失
        loss_dict = model(images, src_targets, domain_labels)
        loss = sum(loss_dict.values())

        # 反向传播
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    return total_loss / len(source_loader)
数据准备与运行
本案例使用简化版Sim10K与Cityscapes数据接口,实际运行时需替换为真实数据集路径。以下为最小可运行的数据加载示例:
from torch.utils.data import Dataset, DataLoader
from torchvision import transforms

class SimpleDomainDataset(Dataset):
    """简化域数据集:返回图像和标注"""
    def __init__(self, image_paths, domain, has_annotations=True):
        self.image_paths = image_paths
        self.domain = domain  # 'source' 或 'target'
        self.has_annotations = has_annotations
        self.transform = transforms.Compose([
            transforms.Resize((800, 800)),
            transforms.ToTensor(),
        ])

    def __len__(self):
        return len(self.image_paths)

    def __getitem__(self, idx):
        from PIL import Image
        img = Image.open(self.image_paths[idx]).convert('RGB')
        img = self.transform(img)

        if self.has_annotations:
            # 简化标注:假设每张图有一个目标框
            target = {
                'boxes': torch.tensor([[100, 100, 300, 300]], dtype=torch.float32),
                'labels': torch.tensor([1], dtype=torch.int64),
            }
            return img, target
        else:
            return img, None

# 使用示例(需替换为实际路径)
# source_paths = ['sim10k_1.jpg', 'sim10k_2.jpg', ...]
# target_paths = ['cityscapes_1.jpg', 'cityscapes_2.jpg', ...]
# source_loader = DataLoader(SimpleDomainDataset(source_paths, 'source'), batch_size=2)
# target_loader = DataLoader(SimpleDomainDataset(target_paths, 'target', has_annotations=False), batch_size=2)

# 初始化与训练
# device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
# model = AdversarialDomainAdaptation(num_classes=8).to(device)
# optimizer = torch.optim.SGD(model.parameters(), lr=0.001, momentum=0.9)
# for epoch in range(10):
#     loss = train_one_epoch(model, source_loader, target_loader, optimizer, device)
#     print(f'Epoch {epoch}: loss = {loss:.4f}')
评估方法与判定标准
在目标域测试集上评估模型性能,使用mAP(mean Average Precision)作为指标。评估流程:
def evaluate(model, test_loader, device):
    """在目标域测试集上评估mAP"""
    model.eval()
    all_preds = []
    all_targets = []

    with torch.no_grad():
        for images, targets in test_loader:
            images = [img.to(device) for img in images]
            predictions = model(images)  # 推理模式

            for pred, tgt in zip(predictions, targets):
                # 提取预测框和标签
                pred_boxes = pred['boxes'].cpu()
                pred_scores = pred['scores'].cpu()
                pred_labels = pred['labels'].cpu()

                # 保留高置信度预测
                keep = pred_scores > 0.5
                all_preds.append({
                    'boxes': pred_boxes[keep],
                    'scores': pred_scores[keep],
                    'labels': pred_labels[keep],
                })
                all_targets.append(tgt)

    # 计算mAP(需使用pycocotools或自定义实现)
    # from pycocotools.coco import COCO
    # from pycocotools.cocoeval import COCOeval
    # ... 标准COCO评估流程
    # 返回mAP值
    return mAP

# 判定标准:
# 1. 对抗训练后,目标域mAP应高于无域适应基线(仅源域训练)
# 2. 域判别器准确率应趋近于50%(表示特征已无法区分域)
# 3. 训练收敛时,总损失应稳定下降
验证路径
完成训练的验证步骤:
- 运行训练脚本,观察损失曲线:检测损失应下降,域对抗损失应稳定在0.7附近(接近随机猜测的交叉熵)
- 在目标域测试集上运行
evaluate(),记录mAP值 - 对比实验:仅用源域数据训练相同骨干网络(无对抗分支),在目标域上评估得到基线mAP
- 若对抗训练后的mAP高于基线,且域判别器准确率接近50%,则判定域适应有效
注意:本案例代码为教学演示的最小实现,实际应用需替换为完整数据集加载、数据增强和更充分的训练轮次。上述代码中的标注格式与Faster R-CNN要求一致,可直接运行训练循环。