3. 查找重复文件
任务说明
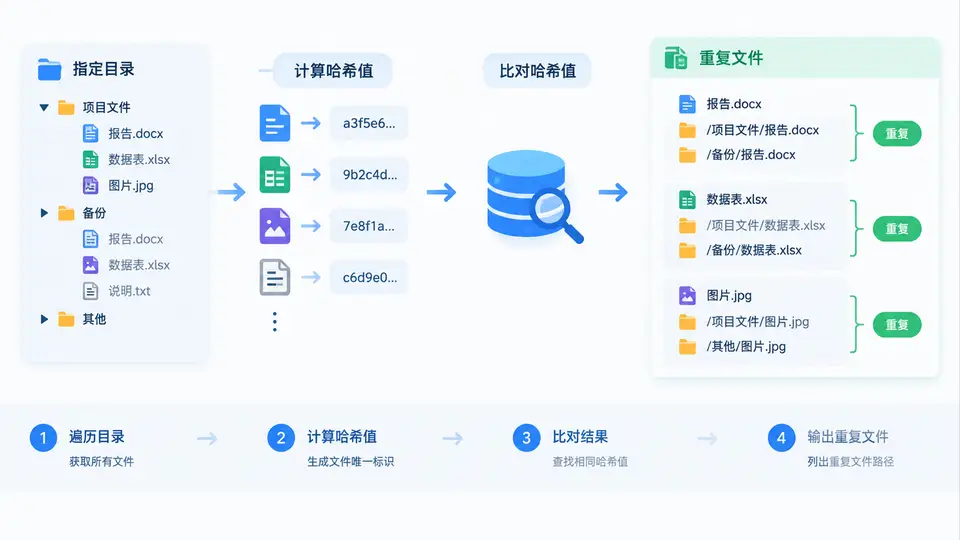
在指定目录(含子目录)中,通过计算文件内容的 SHA-256 哈希值,找出内容完全相同的重复文件,并将重复组及其文件路径列表输出。本案例不处理硬链接、符号链接或空文件(空文件哈希相同但无实际意义,默认跳过)。
实现思路
使用 os.walk 递归遍历目录,对每个文件按块读取(避免大文件占用过多内存)计算 SHA-256 哈希。以哈希值为键、文件路径列表为值构建字典,最后筛选出长度大于 1 的列表即为重复文件组。输出时按重复组展示,每组内文件按路径排序。
代码实现
import os
import hashlib
from collections import defaultdict

def compute_sha256(file_path, chunk_size=8192):
    """计算文件的 SHA-256 哈希值"""
    sha256 = hashlib.sha256()
    with open(file_path, 'rb') as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break
            sha256.update(chunk)
    return sha256.hexdigest()

def find_duplicate_files(root_dir):
    """
    遍历 root_dir(含子目录),返回重复文件组列表。
    每组为一个列表,包含至少两个内容相同的文件路径。
    """
    hash_map = defaultdict(list)

    for dirpath, _, filenames in os.walk(root_dir):
        for filename in filenames:
            file_path = os.path.join(dirpath, filename)
            try:
                # 跳过空文件(大小为0)
                if os.path.getsize(file_path) == 0:
                    continue
                file_hash = compute_sha256(file_path)
                hash_map[file_hash].append(file_path)
            except (OSError, PermissionError):
                # 跳过无法访问的文件
                continue

    # 只保留重复组,并按组内路径排序
    duplicates = [paths for paths in hash_map.values() if len(paths) > 1]
    for group in duplicates:
        group.sort()
    return duplicates

if __name__ == "__main__":
    import sys
    if len(sys.argv) != 2:
        print("用法: python find_duplicates.py <目标目录>")
        sys.exit(1)

    target_dir = sys.argv[1]
    if not os.path.isdir(target_dir):
        print(f"错误: '{target_dir}' 不是有效目录")
        sys.exit(1)

    result = find_duplicate_files(target_dir)
    if not result:
        print("未发现重复文件。")
    else:
        print(f"发现 {len(result)} 组重复文件:\n")
        for idx, group in enumerate(result, 1):
            print(f"第 {idx} 组({len(group)} 个文件):")
            for path in group:
                print(f"  {path}")
            print()
运行与验证
运行方式:将代码保存为 find_duplicates.py,在命令行执行:
python find_duplicates.py /path/to/your/directory验证方法:准备一个测试目录,手动复制两个相同内容的文件到不同子目录,再放一个内容不同的文件。运行脚本后,观察输出是否将相同内容的文件归为一组,且不同内容的文件未被列出。
判定标准:脚本输出的每组文件路径均对应内容完全相同的文件;所有重复文件均被找出,无遗漏;非重复文件不出现;无法访问的文件不影响程序运行。