1. 基于LSTM的剩余寿命预测
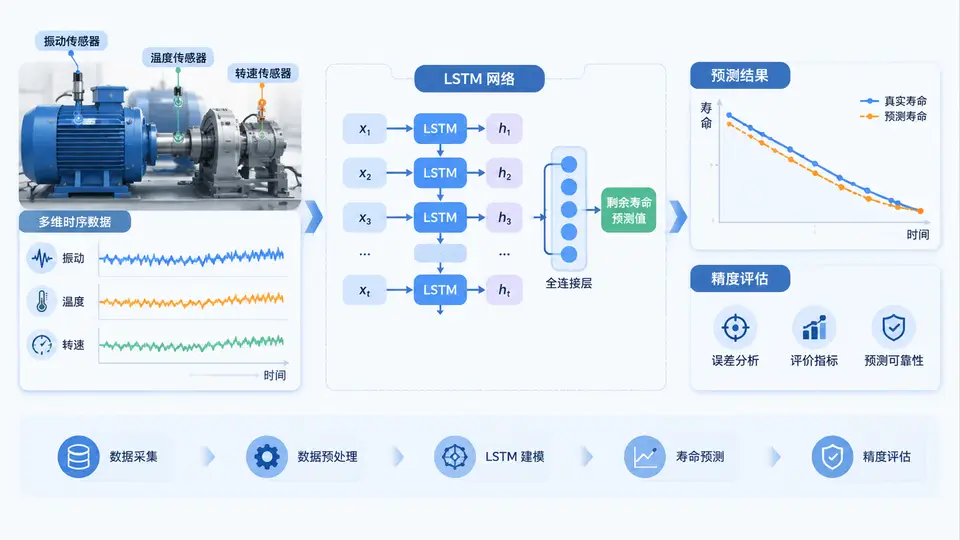
任务说明
本案例使用LSTM网络对机械设备(以涡扇发动机为例)的剩余寿命(RUL, Remaining Useful Life)进行预测。输入为设备多传感器历史退化监测数据,输出为当前时刻至失效时刻的剩余循环数。通过均方误差(MSE)与预测曲线拟合程度评估模型精度。
数据准备
采用NASA涡扇发动机退化模拟数据集(C-MAPSS)FD001子集。训练集包含100台发动机的全寿命退化数据,每台发动机从健康状态运行至失效;测试集包含100台发动机的截断数据,需预测截断时刻的剩余寿命。传感器通道选取14个(排除恒定不变通道),每个时间步输入为14维传感器读数窗口。
实现代码
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error

# -------------------- 数据加载与预处理 --------------------
def load_data(train_path, test_path, window_size=30):
    # 读取训练集(列:unit, cycle, 3个操作设置, 21个传感器)
    train_df = pd.read_csv(train_path, sep=' ', header=None)
    train_df.dropna(axis=1, inplace=True)
    train_df.columns = ['unit', 'cycle'] + ['op' + str(i) for i in range(1,4)] + \
                       ['s' + str(i) for i in range(1,22)]

    test_df = pd.read_csv(test_path, sep=' ', header=None)
    test_df.dropna(axis=1, inplace=True)
    test_df.columns = ['unit', 'cycle'] + ['op' + str(i) for i in range(1,4)] + \
                      ['s' + str(i) for i in range(1,22)]

    # 选择14个有效传感器(FD001中恒定通道:1,5,6,10,16,18,19)
    sensor_cols = ['s' + str(i) for i in range(1,22) if i not in [1,5,6,10,16,18,19]]

    # 计算训练集每台发动机的RUL标签
    max_cycles = train_df.groupby('unit')['cycle'].max().reset_index()
    max_cycles.columns = ['unit', 'max_cycle']
    train_df = train_df.merge(max_cycles, on='unit')
    train_df['RUL'] = train_df['max_cycle'] - train_df['cycle']

    # 截断RUL上限为125(防止异常值影响)
    train_df['RUL'] = train_df['RUL'].clip(upper=125)

    # 标准化(基于训练集拟合)
    scaler = StandardScaler()
    train_sensor = scaler.fit_transform(train_df[sensor_cols].values)
    test_sensor = scaler.transform(test_df[sensor_cols].values)

    # 构造滑动窗口样本
    def create_sequences(data, rul, units, window_size):
        X, y = [], []
        for unit_id in np.unique(units):
            idx = np.where(units == unit_id)[0]
            for i in range(len(idx) - window_size + 1):
                X.append(data[idx[i:i+window_size]])
                y.append(rul[idx[i+window_size-1]])
        return np.array(X), np.array(y)

    train_units = train_df['unit'].values
    test_units = test_df['unit'].values

    X_train, y_train = create_sequences(train_sensor, train_df['RUL'].values,
                                        train_units, window_size)

    # 测试集:取每台发动机最后一个窗口
    X_test, y_test = [], []
    for unit_id in np.unique(test_units):
        idx = np.where(test_units == unit_id)[0]
        if len(idx) >= window_size:
            X_test.append(test_sensor[idx[-window_size:]])
            # 测试集RUL = 该发动机最大cycle - 当前cycle
            max_cycle = test_df[test_df['unit']==unit_id]['cycle'].max()
            cur_cycle = test_df[test_df['unit']==unit_id]['cycle'].iloc[-1]
            y_test.append(max_cycle - cur_cycle)

    X_test = np.array(X_test)
    y_test = np.array(y_test)

    return X_train, y_train, X_test, y_test, scaler

# -------------------- LSTM模型定义 --------------------
class LSTMRULPredictor(nn.Module):
    def __init__(self, input_size=14, hidden_size=64, num_layers=2, dropout=0.2):
        super(LSTMRULPredictor, self).__init__()
        self.lstm = nn.LSTM(input_size, hidden_size, num_layers,
                            batch_first=True, dropout=dropout)
        self.fc = nn.Sequential(
            nn.Linear(hidden_size, 32),
            nn.ReLU(),
            nn.Linear(32, 1)
        )

    def forward(self, x):
        # x: (batch, seq_len, input_size)
        out, _ = self.lstm(x)
        # 取最后一个时间步的输出
        out = out[:, -1, :]
        out = self.fc(out)
        return out.squeeze()

# -------------------- 训练与评估 --------------------
def train_and_evaluate():
    # 请根据实际文件路径修改
    X_train, y_train, X_test, y_test, _ = load_data(
        'train_FD001.txt', 'test_FD001.txt', window_size=30)

    # 转换为PyTorch张量
    X_train_t = torch.FloatTensor(X_train)
    y_train_t = torch.FloatTensor(y_train)
    X_test_t = torch.FloatTensor(X_test)
    y_test_t = torch.FloatTensor(y_test)

    train_dataset = TensorDataset(X_train_t, y_train_t)
    train_loader = DataLoader(train_dataset, batch_size=128, shuffle=True)

    model = LSTMRULPredictor()
    criterion = nn.MSELoss()
    optimizer = optim.Adam(model.parameters(), lr=0.001)

    # 训练
    epochs = 30
    for epoch in range(epochs):
        model.train()
        epoch_loss = 0.0
        for batch_X, batch_y in train_loader:
            optimizer.zero_grad()
            outputs = model(batch_X)
            loss = criterion(outputs, batch_y)
            loss.backward()
            optimizer.step()
            epoch_loss += loss.item() * batch_X.size(0)
        avg_loss = epoch_loss / len(train_dataset)
        if (epoch+1) % 5 == 0:
            print(f'Epoch [{epoch+1}/{epochs}], Loss: {avg_loss:.4f}')

    # 评估
    model.eval()
    with torch.no_grad():
        test_pred = model(X_test_t).numpy()

    mse = mean_squared_error(y_test, test_pred)
    rmse = np.sqrt(mse)

    # 输出评估指标
    print(f'Test RMSE: {rmse:.2f} cycles')

    # 返回预测结果用于可视化
    return y_test, test_pred

# 执行训练与评估(取消注释以运行)
# y_true, y_pred = train_and_evaluate()
验证方法
运行方式:将上述代码保存为rul_lstm.py,下载C-MAPSS FD001数据集(train_FD001.txt与test_FD001.txt)置于同目录,执行python rul_lstm.py。需安装numpy、pandas、scikit-learn、torch。
判定标准:训练过程中损失应逐步下降并收敛;测试集RMSE在FD001公开基准中通常处于15~25循环区间(该数值为领域参考范围,非本案例实测结果)。绘制测试集真实RUL与预测RUL的散点图,若点大致沿对角线分布且无明显系统性偏移,则预测精度合格。
关键实现说明
代码中load_data函数完成数据读取、RUL标签计算(上限截断至125)、传感器标准化与滑动窗口构造。LSTM模型采用2层隐藏层(64单元),取最后时间步输出经全连接层得到RUL预测值。训练使用MSE损失与Adam优化器,测试时对每台发动机取最后一个完整窗口进行预测,最终以RMSE作为精度评估指标。若需可视化,可保存y_true与y_pred后使用matplotlib绘制散点图。