3. NVLink多GPU通信延迟测试
任务说明
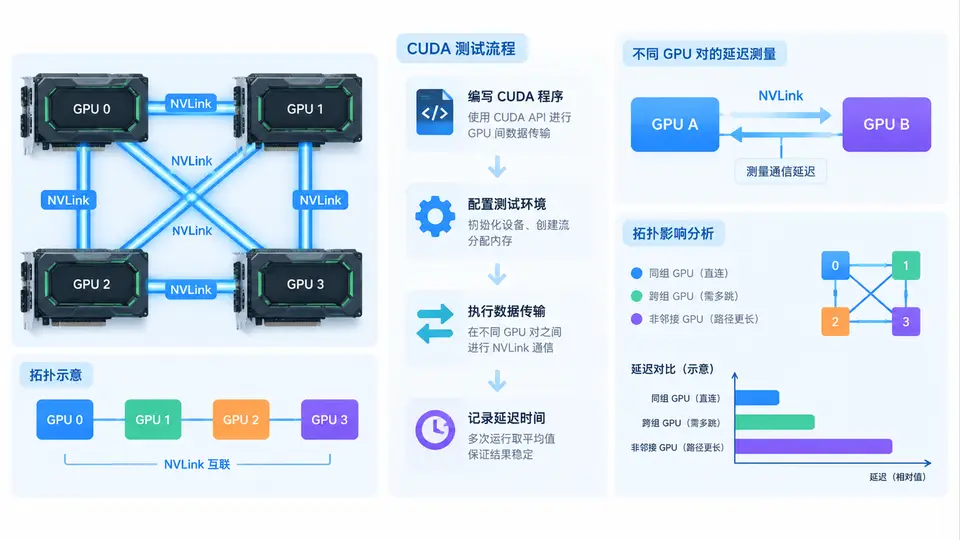
本案例编写一个CUDA程序,测量多GPU系统中不同GPU对之间的点对点(P2P)通信延迟。程序将遍历所有GPU组合,对每对GPU执行小规模数据(如64字节)的往返传输并记录耗时,最终输出延迟矩阵,用于分析NVLink拓扑对通信延迟的影响。
实现方案
使用CUDA的P2P API(cudaDeviceEnablePeerAccess)建立GPU间直接通信通道,通过cudaMemcpyPeerAsync在设备间发起小数据块拷贝,配合CUDA事件精确计时。为消除启动开销影响,对每对GPU执行多次往返测试并取最小值。程序同时查询并输出每对GPU是否支持P2P及对应的拓扑连接类型(NVLink/PCIe),便于关联延迟数据与物理拓扑。
代码实现
#include <cstdio>
#include <cstdlib>
#include <cuda_runtime.h>

#define CHECK_CUDA(call) do { \
    cudaError_t err = (call); \
    if (err != cudaSuccess) { \
        fprintf(stderr, "CUDA error %s at %s:%d\n", \
                cudaGetErrorString(err), __FILE__, __LINE__); \
        exit(EXIT_FAILURE); \
    } \
} while (0)

// 获取两个设备之间的连接类型描述
const char* get_link_type(int dev_a, int dev_b) {
    struct cudaDeviceProp prop_a, prop_b;
    cudaGetDeviceProperties(&prop_a, dev_a);
    cudaGetDeviceProperties(&prop_b, dev_b);
    for (int i = 0; i < prop_a.numNumaNodes; i++) {
        for (int j = 0; j < prop_b.numNumaNodes; j++) {
            int link_type = 0;
            if (cudaDeviceGetP2PAttribute(&link_type,
                    cudaDevP2PAttrPerformanceRank, dev_a, dev_b) == cudaSuccess) {
                // 使用性能等级粗略判断:0为最高(通常NVLink)
                if (link_type == 0) return "NVLink";
            }
        }
    }
    return "PCIe";
}

// 测量一对GPU之间的往返延迟(微秒)
float measure_roundtrip_latency(int dev_src, int dev_dst, int iterations = 1000) {
    const size_t bytes = 64;  // 小数据量,聚焦延迟
    char *buf_src, *buf_dst;

    // 在两个设备上分配缓冲区
    cudaSetDevice(dev_src);
    cudaMalloc(&buf_src, bytes);
    cudaSetDevice(dev_dst);
    cudaMalloc(&buf_dst, bytes);

    // 初始化源数据
    cudaSetDevice(dev_src);
    cudaMemset(buf_src, 0xAB, bytes);

    // 建立P2P访问
    cudaSetDevice(dev_src);
    cudaDeviceEnablePeerAccess(dev_dst, 0);
    cudaSetDevice(dev_dst);
    cudaDeviceEnablePeerAccess(dev_src, 0);

    cudaEvent_t start, stop;
    cudaEventCreate(&start);
    cudaEventCreate(&stop);

    // 预热
    cudaMemcpyPeerAsync(buf_dst, dev_dst, buf_src, dev_src, bytes,
                        cudaMemcpyDeviceToDevice);
    cudaDeviceSynchronize();

    // 计时往返:src->dst 再 dst->src
    float min_time = 1e9f;
    for (int i = 0; i < iterations; i++) {
        cudaEventRecord(start, dev_src);
        cudaMemcpyPeerAsync(buf_dst, dev_dst, buf_src, dev_src, bytes,
                            cudaMemcpyDeviceToDevice);
        cudaMemcpyPeerAsync(buf_src, dev_src, buf_dst, dev_dst, bytes,
                            cudaMemcpyDeviceToDevice);
        cudaEventRecord(stop, dev_src);
        cudaEventSynchronize(stop);

        float ms = 0.0f;
        cudaEventElapsedTime(&ms, start, stop);
        if (ms * 1000.0f < min_time) min_time = ms * 1000.0f;  // 转微秒
    }

    // 清理
    cudaDeviceDisablePeerAccess(dev_dst);
    cudaSetDevice(dev_dst);
    cudaDeviceDisablePeerAccess(dev_src);
    cudaEventDestroy(start);
    cudaEventDestroy(stop);
    cudaFree(buf_src);
    cudaFree(buf_dst);
    cudaSetDevice(dev_src);

    return min_time;
}

int main() {
    int dev_count;
    cudaGetDeviceCount(&dev_count);
    if (dev_count < 2) {
        printf("需要至少2块GPU,当前检测到 %d 块\n", dev_count);
        return 1;
    }

    printf("检测到 %d 块GPU,NVLink P2P延迟矩阵(微秒,往返)\n\n", dev_count);
    printf("延迟\\拓扑   ");
    for (int j = 0; j < dev_count; j++) printf("   GPU%d    ", j);
    printf("\n");

    for (int i = 0; i < dev_count; i++) {
        printf("GPU%d  ", i);
        for (int j = 0; j < dev_count; j++) {
            if (i == j) {
                printf("   ---    ");
                continue;
            }
            // 检查P2P支持
            int can_access = 0;
            cudaDeviceCanAccessPeer(&can_access, i, j);
            if (!can_access) {
                printf(" 不支持  ");
                continue;
            }
            float lat = measure_roundtrip_latency(i, j);
            const char* link = get_link_type(i, j);
            printf("%6.2f(%s)", lat, link);
        }
        printf("\n");
    }

    // 输出拓扑提示
    printf("\n说明:延迟数值为多次往返最小值,括号内为连接类型。\n");
    printf("NVLink延迟通常显著低于PCIe,同交换机下不同GPU对延迟应接近。\n");
    return 0;
}
编译与运行
nvcc -arch=sm_80 -o nvlink_latency nvlink_latency.cu
./nvlink_latency
编译要求CUDA Toolkit 11.0+,运行环境需为多GPU服务器(如DGX系列或配备NVSwitch的HGX平台)。
验证方法
运行程序后观察输出矩阵:
- 若GPU对之间通过NVLink连接,延迟应明显低于PCIe连接(通常NVLink往返延迟在1~3微秒量级,PCIe在5微秒以上);
- 同一NVSwitch域内的GPU对延迟应基本一致,跨域或经PCIe的GPU对延迟会显著升高;
- 程序输出的连接类型(NVLink/PCIe)应与
nvidia-smi topo -m命令显示的拓扑一致。
判定标准:程序能正确枚举所有GPU组合,对支持P2P的GPU对输出非零延迟值,且延迟相对关系与物理拓扑相符(NVLink路径延迟低于PCIe路径)。
拓扑分析要点
程序输出的延迟矩阵可直接用于拓扑分析:
- 若所有GPU对延迟接近(如1~2μs),说明所有GPU处于同一NVSwitch域,通信路径对称;
- 若部分GPU对延迟明显偏高,可能跨越了不同的NVSwitch或经过CPU PCIe桥接;
- 对比
nvidia-smi topo -m输出的拓扑图,可验证延迟数据与物理连接的一致性。
该程序为诊断多GPU应用通信瓶颈提供了量化依据,可指导任务调度与数据放置策略优化。