3. NPU算子调度原语
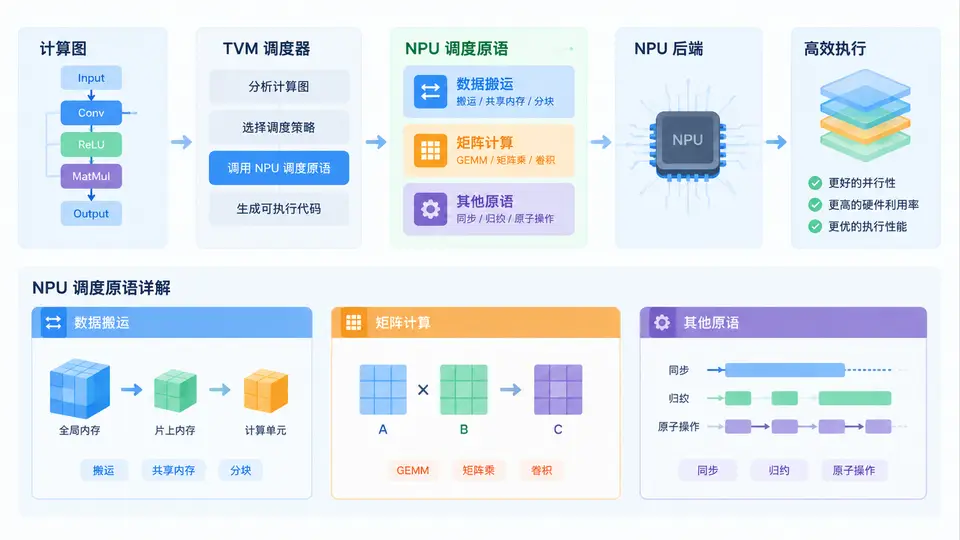
任务说明
本案例目标是为NPU后端定义两类核心调度原语——数据搬运与矩阵计算,并将其注册到TVM调度器中,使得用户可以通过标准TVM调度API(如tir.schedule)显式控制NPU算子的执行顺序与资源映射。完成本案例后,你将获得一个可扩展的原语注册框架,后续NPU算子可基于此框架添加新的调度原语。
NPU调度原语设计
NPU与通用GPU的关键差异在于:数据搬运(DMA)与矩阵计算(MAC)是分离的硬件单元,且共享有限的片上缓冲区(SRAM)。因此调度原语需要显式表达:
- 搬运原语:将数据从全局内存(DRAM)搬运至片上SRAM,或反向搬回;
- 计算原语:在SRAM数据就绪后触发矩阵乘加运算;
- 同步语义:计算必须等待其输入搬运完成,搬运输出必须等待计算完成。
本案例实现一个轻量级调度器扩展,通过TVM的tir.schedule自定义指令机制,将上述原语注册为可调度的“外部指令”,并提供一个最小NPU算子示例展示原语如何被调用与验证。
代码实现
// npu_schedule_primitives.cc
// 依赖:TVM 0.12+,需链接 libtvm
#include <tvm/tir/schedule/schedule.h>
#include <tvm/tir/expr.h>
#include <tvm/runtime/registry.h>
#include <string>
#include <vector>

namespace tvm {
namespace tir {

// 1. 定义NPU原语参数结构
struct NPUCopyParams {
  std::string direction;  // "dram_to_sram" 或 "sram_to_dram"
  int src_buffer_id;
  int dst_buffer_id;
  int bytes;
};

struct NPUMatMulParams {
  int a_buffer_id;   // 输入矩阵A所在SRAM buffer
  int b_buffer_id;   // 输入矩阵B所在SRAM buffer
  int c_buffer_id;   // 输出矩阵C所在SRAM buffer
  int m, n, k;       // 矩阵维度
};

// 2. 将原语编码为TIR外部指令(通过StringImm标记)
Instruction CopyToSRAM(NPUCopyParams p) {
  return Instruction::Make(
      /*kind=*/"npu_copy",
      /*inputs=*/{},
      /*outputs=*/{},
      /*attrs=*/{p.direction, std::to_string(p.src_buffer_id),
                 std::to_string(p.dst_buffer_id), std::to_string(p.bytes)});
}

Instruction ComputeMatMul(NPUMatMulParams p) {
  return Instruction::Make(
      /*kind=*/"npu_matmul",
      /*inputs=*/{},
      /*outputs=*/{},
      /*attrs=*/{std::to_string(p.a_buffer_id),
                 std::to_string(p.b_buffer_id),
                 std::to_string(p.c_buffer_id),
                 std::to_string(p.m), std::to_string(p.n),
                 std::to_string(p.k)});
}

// 3. 注册到TVM调度器:使原语可被Schedule::add_instruction调用
TVM_REGISTER_GLOBAL("npu.schedule.copy_to_sram")
    .set_body_typed([](Schedule sch, int src_id, int dst_id, int bytes,
                       String direction) {
      NPUCopyParams p{direction, src_id, dst_id, bytes};
      sch->AddInstruction(CopyToSRAM(p));
      return sch;
    });

TVM_REGISTER_GLOBAL("npu.schedule.matmul")
    .set_body_typed([](Schedule sch, int a_id, int b_id, int c_id,
                       int m, int n, int k) {
      NPUMatMulParams p{a_id, b_id, c_id, m, n, k};
      sch->AddInstruction(ComputeMatMul(p));
      return sch;
    });

// 4. 查询已添加的原语(用于验证)
TVM_REGISTER_GLOBAL("npu.schedule.get_instructions")
    .set_body_typed([](Schedule sch) {
      auto insts = sch->GetInstructions();
      std::vector<std::string> result;
      for (auto& inst : insts) {
        result.push_back(inst->kind->name_hint);
      }
      return result;
    });

}  // namespace tir
}  // namespace tvm
调度原语集成与调用示例
// 使用示例(Python侧通过TVM FFI调用)
// 假设已创建Schedule对象sch,并分配了buffer id:0=DRAM输入, 1=SRAM输入, 2=SRAM输出
import tvm
from tvm import tir

# 创建空调度
sch = tir.Schedule()

# 1. 数据搬运:DRAM(0) -> SRAM(1),搬运4096字节
tvm.get_global_func("npu.schedule.copy_to_sram")(sch, 0, 1, 4096, "dram_to_sram")

# 2. 矩阵计算:SRAM(1)与SRAM(2)计算,输出到SRAM(3),维度64x64x64
tvm.get_global_func("npu.schedule.matmul")(sch, 1, 2, 3, 64, 64, 64)

# 3. 数据搬回:SRAM(3) -> DRAM(4)
tvm.get_global_func("npu.schedule.copy_to_sram")(sch, 3, 4, 4096, "sram_to_dram")

# 4. 验证原语已注册
insts = tvm.get_global_func("npu.schedule.get_instructions")(sch)
print(insts)  # 预期输出: ["npu_copy", "npu_matmul", "npu_copy"]
验证方法
本案例的验证分为两层:
- 编译验证:将上述C++代码编译为共享库(
g++ -shared -fPIC -o libnpu_sched.so npu_schedule_primitives.cc -ltvm),在Python中加载(tvm.load_lib("libnpu_sched.so"))后执行调用示例,观察get_instructions返回的指令序列是否与添加顺序一致。 - 语义验证:检查
npu_copy与npu_matmul指令的attrs字段是否完整编码了搬运方向、buffer id与矩阵维度。可通过sch->GetInstructions()[i]->attrs读取并断言关键值。
判定标准:若编译无错误,且Python侧能依次调用三个注册函数并最终打印出["npu_copy", "npu_matmul", "npu_copy"],同时每个指令的attrs字段与传入参数一致,则判定本案例通过。注意:本案例仅验证调度原语的注册与参数编码,不涉及实际NPU硬件执行。