1. 基于规则的情感极性分类器
任务说明
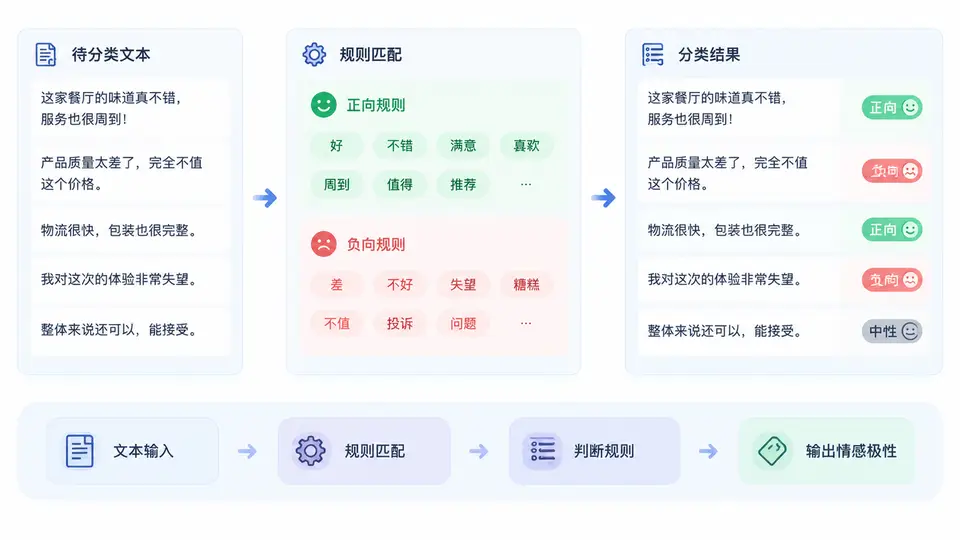
构建一个基于规则的中文情感极性分类器,输入为一段中文评本,输出为“正面”或“负面”判定。规则采用情感词典匹配加否定词反转的方式实现,不依赖任何机器学习库,仅使用Python标准库完成。
实现方案
分类器核心逻辑包含三个部分:情感词典(正面词与负面词列表)、否定词表(如“不”“没”“无”等)、程度副词表(如“很”“太”“非常”等,用于加权)。处理流程为:对输入文本进行简单分词(按字符与常用分隔符切分),遍历每个情感词,向前回溯查找否定词与程度副词,计算加权情感得分;最终得分为正输出“正面”,为负输出“负面”,为零输出“中性”。
代码实现
import re

# 情感词典(示例规模,可扩展)
POSITIVE_WORDS = {"好", "棒", "赞", "喜欢", "满意", "推荐", "优秀", "开心", "值得"}
NEGATIVE_WORDS = {"差", "烂", "垃圾", "讨厌", "失望", "坑", "后悔", "糟糕", "贵"}

# 否定词表
NEGATION_WORDS = {"不", "没", "无", "非", "莫", "勿", "别", "未"}

# 程度副词及其权重
DEGREE_WORDS = {
    "很": 1.5, "太": 1.8, "非常": 2.0, "特别": 1.8,
    "有点": 0.7, "稍微": 0.6, "极其": 2.2, "最": 2.0
}

def simple_tokenize(text: str) -> list:
    """按非中文字符分割,保留中文字符序列"""
    return re.findall(r'[\u4e00-\u9fff]+', text)

def classify_sentiment(text: str) -> str:
    """基于规则的情感极性分类"""
    score = 0.0
    segments = simple_tokenize(text)

    for seg in segments:
        # 在单个连续中文片段内查找情感词
        for word in POSITIVE_WORDS | NEGATIVE_WORDS:
            if word not in seg:
                continue
            # 计算该情感词出现次数
            count = seg.count(word)
            base = 1.0 if word in POSITIVE_WORDS else -1.0

            # 向前查找否定词与程度副词(最多回溯5个字符)
            start = seg.find(word)
            context = seg[max(0, start-5):start]

            # 否定词反转
            negated = any(n in context for n in NEGATION_WORDS)

            # 程度副词加权
            degree = 1.0
            for d, w in DEGREE_WORDS.items():
                if d in context:
                    degree = w
                    break

            # 计算该词贡献
            val = base * degree
            if negated:
                val = -val * 0.5  # 否定后极性反转且强度减半

            score += val * count

    if score > 0:
        return "正面"
    elif score < 0:
        return "负面"
    else:
        return "中性"

# 测试样例
if __name__ == "__main__":
    samples = [
        "这个手机很好用,非常喜欢",
        "质量太差了,很失望",
        "价格有点贵,但还能接受",
        "不好用,不推荐"
    ]
    for s in samples:
        print(f"输入: {s} → 判定: {classify_sentiment(s)}")
运行与验证
将上述代码保存为 sentiment_rule.py,在命令行执行 python sentiment_rule.py。程序会输出四条测试样例的判定结果。判定标准为:
- “这个手机很好用,非常喜欢”包含正面词“好”“喜欢”,且“非常”加权,应输出正面;
- “质量太差了,很失望”包含负面词“差”“失望”,应输出负面;
- “价格有点贵,但还能接受”中“贵”为负面词但“有点”降低权重,且无正面词,应输出负面;
- “不好用,不推荐”中“好”前有否定词“不”,极性反转,应输出负面。
若输出与上述预期一致,则分类器逻辑正确。可自行替换 samples 中的文本进行更多测试。
判定边界说明
本分类器为教学演示用途,词典规模有限,仅覆盖示例词汇。对于未登录词、复杂句式(如双重否定、反问句)可能误判,这是基于规则方法的固有局限。实际应用中需扩展词典并增加更精细的上下文处理规则。