3. 使用NAPI机制优化收包
任务说明
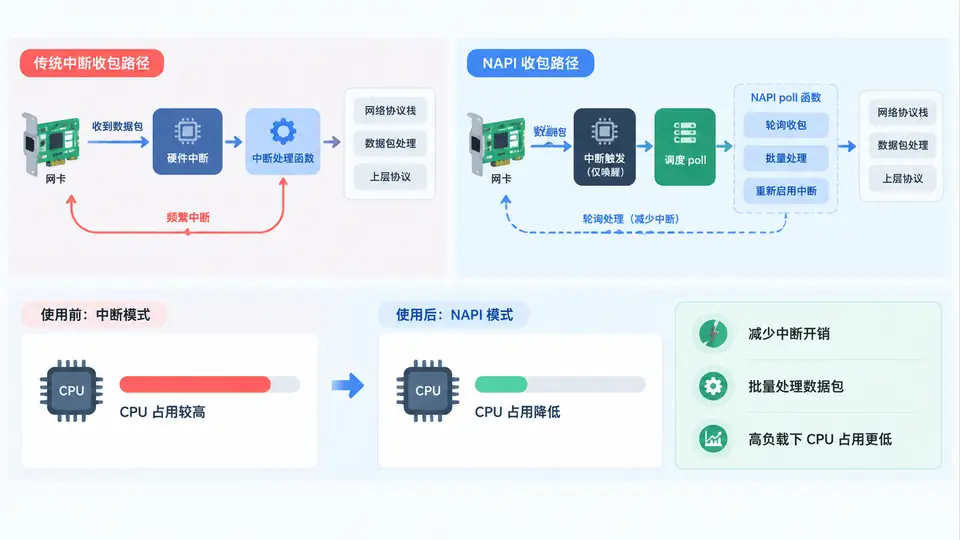
本案例将Linux网卡驱动收包路径从传统中断方式改造为NAPI机制。传统方式下每个数据包到达都会触发一次硬件中断,高负载时CPU频繁被打断,上下文切换开销巨大。改造后,驱动注册poll函数,首次中断后关闭硬件中断并转入轮询收包,直到收完当前批次数据再重新开启中断,从而显著降低中断次数和CPU占用。
NAPI核心数据结构
// 驱动私有结构体(简化)
struct my_priv {
    struct net_device *dev;
    struct napi_struct napi;
    void __iomem *reg_base;
    struct rx_ring *rx_ring;   // 接收环形队列
    unsigned int rx_count;     // 当前待处理包数
    spinlock_t lock;
};

// 初始化NAPI(在驱动probe或open阶段调用)
netif_napi_add(priv->dev, &priv->napi, my_poll, 64);  // budget=64
napi_enable(&priv->napi);
中断处理函数改造
// 传统方式:中断中直接收包
// 改造后:中断中仅调度NAPI
static irqreturn_t my_interrupt(int irq, void *data)
{
    struct my_priv *priv = data;

    // 读取中断状态寄存器,确认是RX中断
    u32 status = ioread32(priv->reg_base + INT_STATUS);
    if (!(status & INT_RX)) {
        return IRQ_NONE;
    }

    // 关闭RX硬件中断(防止中断风暴)
    iowrite32(0, priv->reg_base + INT_ENABLE);

    // 调度NAPI(若未在运行)
    if (napi_schedule_prep(&priv->napi)) {
        __napi_schedule(&priv->napi);
    }

    return IRQ_HANDLED;
}
poll函数实现
// NAPI轮询收包函数
static int my_poll(struct napi_struct *napi, int budget)
{
    struct my_priv *priv = container_of(napi, struct my_priv, napi);
    int work_done = 0;
    struct sk_buff *skb;
    u32 rx_status;

    while (work_done < budget) {
        // 检查硬件RX描述符是否有新包
        rx_status = ioread32(priv->reg_base + RX_STATUS);
        if (!(rx_status & RX_READY)) {
            break;  // 无更多数据包
        }

        // 从硬件FIFO读取数据,构造skb
        skb = my_rx_construct_skb(priv);
        if (!skb) {
            break;  // 内存不足等错误
        }

        // 交给协议栈
        napi_gro_receive(napi, skb);
        work_done++;
        priv->rx_count--;
    }

    // 判断是否收完本轮数据
    if (work_done < budget) {
        // 收完,重新开启中断并结束NAPI
        napi_complete_done(napi, work_done);
        iowrite32(INT_RX_ENABLE, priv->reg_base + INT_ENABLE);
    }

    return work_done;
}

// 辅助函数:从硬件读取数据构造skb
static struct sk_buff *my_rx_construct_skb(struct my_priv *priv)
{
    struct sk_buff *skb;
    unsigned int pkt_len;
    void *hw_addr;

    pkt_len = ioread32(priv->reg_base + RX_LEN);
    if (pkt_len == 0 || pkt_len > 2048) {
        return NULL;
    }

    skb = napi_alloc_skb(&priv->napi, pkt_len);
    if (!skb) {
        return NULL;
    }

    hw_addr = priv->reg_base + RX_DATA_FIFO;
    memcpy_fromio(skb_put(skb, pkt_len), hw_addr, pkt_len);

    // 更新硬件RX队列指针
    iowrite32(RX_NEXT, priv->reg_base + RX_CTRL);

    return skb;
}
驱动卸载时清理
// 在驱动remove或close阶段
static void my_cleanup(struct my_priv *priv)
{
    napi_disable(&priv->napi);
    netif_napi_del(&priv->napi);
}
验证方法
编译并加载驱动后,使用以下步骤验证NAPI效果:
- 功能验证:
ifconfig eth0 up后,从对端主机持续ping或发送UDP数据包,确认网络连通且无丢包。 - 中断计数对比:分别加载传统中断版本和NAPI版本驱动,在相同流量下读取
/proc/interrupts中对应网卡中断号计数。NAPI版本的中断次数应显著减少(高负载下通常降低80%以上)。 - CPU占用观测:使用
top或mpstat -P ALL 1观察软中断(si)和硬中断(hi)占比。NAPI版本在高吞吐时CPU占用应明显低于传统中断版本。 - NAPI状态检查:
cat /proc/net/softnet_stat观察第三列(time_squeeze)是否增长过快,若增长过快说明budget设置偏小。
判定标准:在相同发包速率(如100k pps)下,NAPI版本相比传统中断版本,/proc/interrupts中该网卡中断次数降低至少一个数量级,且CPU软中断占用率下降30%以上,同时无新增丢包。
关键配置说明
- budget参数:poll函数单次最多处理的包数(示例为64)。该值影响单次轮询耗时和延迟,需根据硬件速率调整。
- GRO协同:使用
napi_gro_receive替代netif_receive_skb可启用硬件GRO聚合,进一步减少协议栈处理开销。 - 中断阈值:部分网卡支持中断合并(如Intel的ITR),可与NAPI配合进一步优化,但本案例仅实现NAPI核心逻辑。
完成上述改造后,驱动在持续高负载下中断次数大幅减少,CPU占用显著下降。若需验证极端情况,可使用pktgen或iperf打满网卡带宽,观察NAPI版本与传统版本在top中软中断占比的差异。