1. 鸢尾花分类
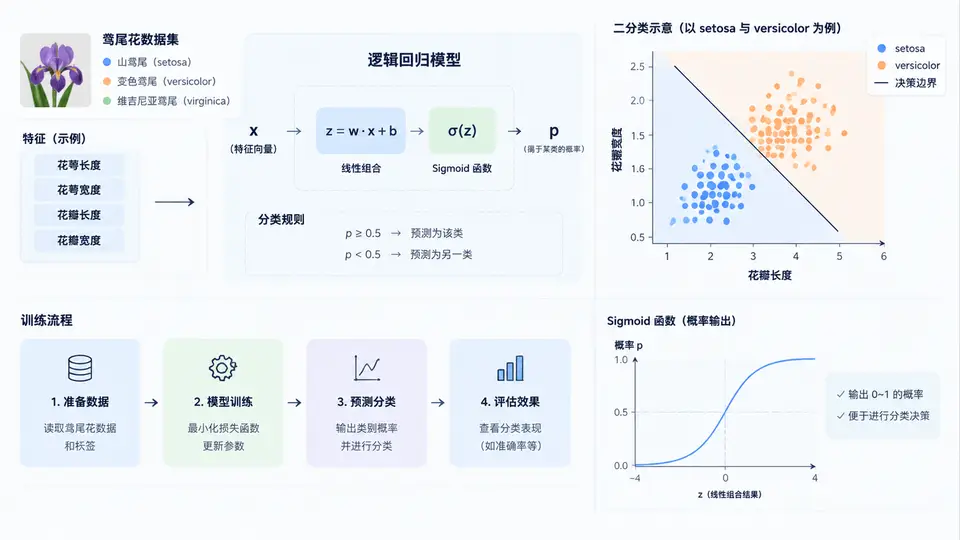
任务说明
本案例使用鸢尾花数据集完成一个二分类任务:区分山鸢尾(Iris-setosa)与非山鸢尾(Iris-versicolor)。采用逻辑回归模型,目标是理解逻辑回归的核心机制——通过sigmoid函数将线性输出映射为概率,并基于概率完成分类决策。案例将完整实现数据加载、训练、预测与评估,不依赖任何机器学习库,仅使用NumPy进行矩阵运算。
数据准备
从鸢尾花数据集中选取前100个样本(两类各50个),使用花萼长度、花萼宽度、花瓣长度、花瓣宽度四个特征。标签定义为:山鸢尾为1,非山鸢尾为0。数据按7:3划分训练集与测试集,并固定随机种子保证可复现。
逻辑回归实现
模型使用批量梯度下降优化带L2正则化的对数损失函数。核心计算包括:线性得分 \( z = X\theta \)、sigmoid概率 \( p = \sigma(z) \)、梯度 \( \nabla = X^T(p-y)/m + \lambda\theta \)。训练完成后,以0.5为阈值输出预测类别。
import numpy as np

# ========== 数据加载与预处理 ==========
def load_iris_binary():
    """从本地文件读取鸢尾花数据,返回特征矩阵和标签(山鸢尾=1,非山鸢尾=0)"""
    data = []
    labels = []
    with open('iris.data', 'r') as f:
        for line in f:
            parts = line.strip().split(',')
            if len(parts) != 5:
                continue
            species = parts[4]
            if species == 'Iris-setosa':
                labels.append(1)
            elif species == 'Iris-versicolor':
                labels.append(0)
            else:
                continue  # 排除Iris-virginica
            data.append([float(x) for x in parts[:4]])
    return np.array(data), np.array(labels)

def train_test_split(X, y, test_ratio=0.3, seed=42):
    """按固定比例划分训练集和测试集"""
    np.random.seed(seed)
    indices = np.random.permutation(len(X))
    test_size = int(len(X) * test_ratio)
    test_idx, train_idx = indices[:test_size], indices[test_size:]
    return X[train_idx], X[test_idx], y[train_idx], y[test_idx]

# ========== 逻辑回归模型 ==========
class LogisticRegression:
    def __init__(self, lr=0.1, epochs=500, lambda_reg=0.01):
        self.lr = lr
        self.epochs = epochs
        self.lambda_reg = lambda_reg
        self.theta = None

    def _sigmoid(self, z):
        """sigmoid函数,数值稳定版本"""
        return 1 / (1 + np.exp(-np.clip(z, -500, 500)))

    def fit(self, X, y):
        """批量梯度下降训练模型"""
        m, n = X.shape
        X_b = np.c_[np.ones((m, 1)), X]  # 添加偏置项
        self.theta = np.zeros((n + 1, 1))
        y = y.reshape(-1, 1)

        for _ in range(self.epochs):
            z = X_b @ self.theta
            p = self._sigmoid(z)
            gradient = (X_b.T @ (p - y)) / m
            # L2正则化(不惩罚偏置项)
            gradient[1:] += (self.lambda_reg / m) * self.theta[1:]
            self.theta -= self.lr * gradient
        return self

    def predict_proba(self, X):
        """返回正类(山鸢尾)的概率"""
        m = X.shape[0]
        X_b = np.c_[np.ones((m, 1)), X]
        return self._sigmoid(X_b @ self.theta).flatten()

    def predict(self, X, threshold=0.5):
        """按阈值输出类别"""
        proba = self.predict_proba(X)
        return (proba >= threshold).astype(int)

# ========== 评估指标 ==========
def accuracy(y_true, y_pred):
    return np.mean(y_true == y_pred)

# ========== 主流程 ==========
if __name__ == "__main__":
    # 1. 加载数据(需将iris.data放在当前目录)
    X, y = load_iris_binary()
    print(f"数据规模: {X.shape[0]}个样本, {X.shape[1]}个特征")

    # 2. 划分训练/测试集
    X_train, X_test, y_train, y_test = train_test_split(X, y)
    print(f"训练集: {len(X_train)}个样本, 测试集: {len(X_test)}个样本")

    # 3. 训练模型
    model = LogisticRegression(lr=0.1, epochs=500, lambda_reg=0.01)
    model.fit(X_train, y_train)

    # 4. 预测与评估
    train_pred = model.predict(X_train)
    test_pred = model.predict(X_test)
    train_acc = accuracy(y_train, train_pred)
    test_acc = accuracy(y_test, test_pred)

    print(f"训练集准确率: {train_acc:.4f}")
    print(f"测试集准确率: {test_acc:.4f}")

    # 5. 输出学到的权重(含偏置)
    print("\n模型参数 (偏置, 花萼长, 花萼宽, 花瓣长, 花瓣宽):")
    print(np.round(model.theta.flatten(), 4))
数据文件说明
运行前需下载UCI鸢尾花数据集并保存为iris.data,置于与脚本相同目录。文件格式为CSV,每行包含4个逗号分隔的特征值和1个类别名。本案例仅使用前两类(setosa和versicolor),共100行数据。
验证方法
执行脚本后观察输出:训练集与测试集准确率应接近或达到1.0(两类数据线性可分)。模型参数中花瓣长度对应的权重应为最大正值,表明该特征对区分两类贡献最大。若准确率低于0.9,可检查数据文件是否完整、两类样本是否各50条。
判定标准
案例通过的条件为:脚本无错误运行,输出训练集与测试集准确率均不低于0.9,且模型参数中花瓣长度(第三个特征)的权重值最大。满足上述条件即表明逻辑回归模型正确学习到了两类鸢尾花的分类边界。