3. 并行归并排序
任务说明
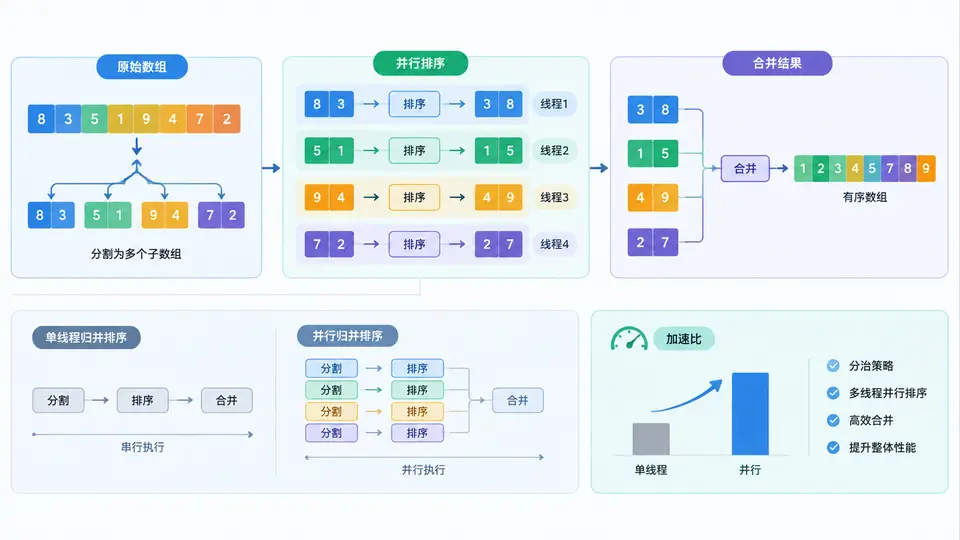
实现一个并行归并排序程序:将输入数组递归分割为多个子数组,各子数组并行执行排序,最后合并为完整有序序列。通过改变并行线程数,观察并分析加速比变化。本案例使用C++标准线程库,不依赖外部并行框架。
并行归并排序实现
// parallel_merge_sort.cpp
#include <iostream>
#include <vector>
#include <thread>
#include <algorithm>
#include <chrono>
#include <random>

// 串行归并排序(用于基础比较和递归基)
void merge_sort_serial(std::vector<int>& arr, int left, int right) {
    if (left >= right) return;
    int mid = left + (right - left) / 2;
    merge_sort_serial(arr, left, mid);
    merge_sort_serial(arr, mid + 1, right);

    // 合并两个有序区间
    std::vector<int> temp(right - left + 1);
    int i = left, j = mid + 1, k = 0;
    while (i <= mid && j <= right) {
        if (arr[i] <= arr[j]) temp[k++] = arr[i++];
        else temp[k++] = arr[j++];
    }
    while (i <= mid) temp[k++] = arr[i++];
    while (j <= right) temp[k++] = arr[j++];
    for (int p = 0; p < temp.size(); ++p) arr[left + p] = temp[p];
}

// 并行归并排序
void merge_sort_parallel(std::vector<int>& arr, int left, int right, int depth) {
    if (left >= right) return;
    if (depth <= 0) {  // 达到深度限制,转串行
        merge_sort_serial(arr, left, right);
        return;
    }

    int mid = left + (right - left) / 2;

    // 创建两个子任务并行执行
    std::thread t1([&]() { merge_sort_parallel(arr, left, mid, depth - 1); });
    std::thread t2([&]() { merge_sort_parallel(arr, mid + 1, right, depth - 1); });
    t1.join();
    t2.join();

    // 合并(与串行版本相同)
    std::vector<int> temp(right - left + 1);
    int i = left, j = mid + 1, k = 0;
    while (i <= mid && j <= right) {
        if (arr[i] <= arr[j]) temp[k++] = arr[i++];
        else temp[k++] = arr[j++];
    }
    while (i <= mid) temp[k++] = arr[i++];
    while (j <= right) temp[k++] = arr[j++];
    for (int p = 0; p < temp.size(); ++p) arr[left + p] = temp[p];
}

// 验证排序正确性
bool verify_sorted(const std::vector<int>& arr) {
    for (size_t i = 1; i < arr.size(); ++i) {
        if (arr[i] < arr[i - 1]) return false;
    }
    return true;
}

int main(int argc, char* argv[]) {
    const int N = (argc > 1) ? std::stoi(argv[1]) : 1000000;  // 数组大小
    const int MAX_THREADS = (argc > 2) ? std::stoi(argv[2]) : 4;  // 最大线程数

    // 生成随机数据
    std::vector<int> data(N);
    std::mt19937 rng(42);
    std::uniform_int_distribution<int> dist(0, N * 10);
    for (int& x : data) x = dist(rng);

    // 串行排序计时
    std::vector<int> arr_serial = data;
    auto t0 = std::chrono::high_resolution_clock::now();
    merge_sort_serial(arr_serial, 0, N - 1);
    auto t1 = std::chrono::high_resolution_clock::now();
    double serial_time = std::chrono::duration<double>(t1 - t0).count();

    std::cout << "串行排序时间: " << serial_time << " 秒\n";
    std::cout << "串行排序正确: " << (verify_sorted(arr_serial) ? "是" : "否") << "\n";

    // 并行排序(不同线程数)
    for (int threads = 2; threads <= MAX_THREADS; threads *= 2) {
        std::vector<int> arr_par = data;
        int depth = 0;
        int temp = threads;
        while (temp > 1) { depth++; temp /= 2; }  // 计算递归深度

        auto t2 = std::chrono::high_resolution_clock::now();
        merge_sort_parallel(arr_par, 0, N - 1, depth);
        auto t3 = std::chrono::high_resolution_clock::now();
        double par_time = std::chrono::duration<double>(t3 - t2).count();

        std::cout << "\n线程数 " << threads << ":\n";
        std::cout << "  并行排序时间: " << par_time << " 秒\n";
        std::cout << "  排序正确: " << (verify_sorted(arr_par) ? "是" : "否") << "\n";
        std::cout << "  加速比: " << (serial_time / par_time) << "\n";
    }

    return 0;
}
编译与运行
g++ -O3 -std=c++11 -pthread parallel_merge_sort.cpp -o parallel_merge_sort
./parallel_merge_sort 1000000 4
并行策略说明
程序通过递归深度控制并行度:深度为0时转为串行排序,避免线程过多导致开销过大。每个递归层级创建两个线程分别处理左右子数组,线程数按2的幂次增长。合并阶段仍由父线程完成,保证数据一致性。
验证方法
运行程序后观察输出:
- 串行与各并行配置的排序结果均显示“正确: 是”,证明排序功能无误;
- 比较不同线程数下的排序时间,计算加速比(串行时间/并行时间);
- 在4核及以上CPU上,预期2线程加速比接近1.5~1.8,4线程接近2.5~3.5(受内存带宽和合并开销限制,无法达到线性加速);
- 若加速比小于1,说明数据量过小或线程开销占主导,可增大数组规模重新测试。
加速比分析要点
加速比受以下因素影响:
- 数据规模:N越大,并行计算占比越高,加速比越明显;
- 线程开销:线程创建与上下文切换有固定成本,小数据量时可能抵消并行收益;
- 合并瓶颈:合并阶段为串行操作,是并行归并排序的固有瓶颈;
- 内存带宽:多线程同时访问内存可能造成带宽竞争,限制扩展性。
建议测试N=10⁶和N=10⁷两组数据,对比加速比变化趋势。若机器核心数较多,可尝试8线程观察是否继续提升。