3. 批量数据块(Batch)设计与实现
任务说明
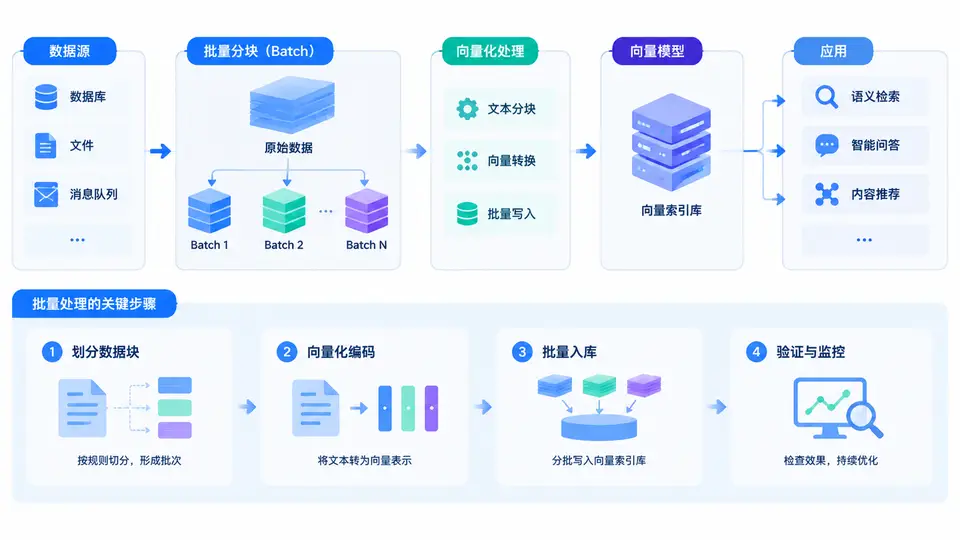
在火山模型(Volcano Model)中,每次调用next()只返回一行数据,导致函数调用开销巨大。本案例的目标是设计并实现一个批量数据块(Batch),将多行数据打包传递,为后续向量化执行奠定基础。你需要完成:定义Batch的数据结构、实现行与列的存取操作、提供批量迭代器接口,并通过一个最小示例验证Batch能正确存储和读取多行多列数据。
Batch数据结构设计
Batch采用列式存储(Columnar Layout),即同一列的数据在内存中连续存放。这种布局对向量化计算友好,能够充分利用CPU缓存。Batch包含以下核心组件:
- 列集合:使用
std::vector<Column>存储所有列,每列是一个std::vector<int32_t>(为简化,本案例仅支持INT32类型)。 - 行数:记录当前Batch中有效数据的行数,所有列的长度必须一致。
- 容量:Batch预分配的最大行数,避免频繁内存分配。
代码实现
#include <iostream>
#include <vector>
#include <stdexcept>
#include <cstdint>

// 批量数据块:列式存储,仅支持INT32类型
class Batch {
private:
    std::vector<std::vector<int32_t>> columns_;  // 每列数据
    size_t num_rows_ = 0;                        // 当前有效行数
    size_t capacity_ = 0;                        // 最大容量

public:
    // 构造:指定列数和容量
    Batch(size_t num_cols, size_t capacity)
        : columns_(num_cols), capacity_(capacity) {
        for (auto& col : columns_) {
            col.reserve(capacity);
        }
    }

    // 向指定列追加一个值
    void append(size_t col_idx, int32_t value) {
        if (col_idx >= columns_.size()) {
            throw std::out_of_range("列索引越界");
        }
        if (num_rows_ >= capacity_) {
            throw std::overflow_error("Batch容量已满");
        }
        columns_[col_idx].push_back(value);
    }

    // 完成一行的写入:所有列必须已追加,然后增加行数
    void end_row() {
        if (num_rows_ >= capacity_) {
            throw std::overflow_error("Batch容量已满");
        }
        // 检查所有列长度一致
        for (const auto& col : columns_) {
            if (col.size() != num_rows_ + 1) {
                throw std::runtime_error("列长度不一致,无法结束当前行");
            }
        }
        num_rows_++;
    }

    // 获取某行某列的值
    int32_t get(size_t row_idx, size_t col_idx) const {
        if (row_idx >= num_rows_ || col_idx >= columns_.size()) {
            throw std::out_of_range("行或列索引越界");
        }
        return columns_[col_idx][row_idx];
    }

    // 获取列数
    size_t num_cols() const { return columns_.size(); }

    // 获取当前有效行数
    size_t num_rows() const { return num_rows_; }

    // 获取指定列的原始数据引用(供向量化操作使用)
    const std::vector<int32_t>& column(size_t col_idx) const {
        return columns_.at(col_idx);
    }

    // 重置Batch以便复用
    void reset() {
        for (auto& col : columns_) {
            col.clear();
        }
        num_rows_ = 0;
    }
};

// 批量迭代器:按行遍历Batch
class BatchIterator {
private:
    const Batch& batch_;
    size_t row_idx_ = 0;

public:
    explicit BatchIterator(const Batch& batch) : batch_(batch) {}

    bool has_next() const { return row_idx_ < batch_.num_rows(); }

    // 返回当前行的所有列值
    std::vector<int32_t> next() {
        if (!has_next()) {
            throw std::out_of_range("迭代器越界");
        }
        std::vector<int32_t> row(batch_.num_cols());
        for (size_t c = 0; c < batch_.num_cols(); ++c) {
            row[c] = batch_.get(row_idx_, c);
        }
        row_idx_++;
        return row;
    }
};

// 使用示例:写入3行2列数据并遍历
int main() {
    Batch batch(2, 10);  // 2列,容量10行

    // 写入第1行: (10, 20)
    batch.append(0, 10);
    batch.append(1, 20);
    batch.end_row();

    // 写入第2行: (30, 40)
    batch.append(0, 30);
    batch.append(1, 40);
    batch.end_row();

    // 写入第3行: (50, 60)
    batch.append(0, 50);
    batch.append(1, 60);
    batch.end_row();

    std::cout << "Batch行数: " << batch.num_rows() << std::endl;
    std::cout << "Batch列数: " << batch.num_cols() << std::endl;

    // 使用迭代器遍历
    BatchIterator it(batch);
    int row_num = 0;
    while (it.has_next()) {
        auto row = it.next();
        std::cout << "第" << row_num++ << "行: ";
        for (int32_t val : row) {
            std::cout << val << " ";
        }
        std::cout << std::endl;
    }

    // 验证随机访问
    std::cout << "get(2,1) = " << batch.get(2, 1) << std::endl;  // 应为60

    return 0;
}
关键设计说明
本实现采用追加-结束行两阶段写入模式:先向各列追加值,再调用end_row()确认该行完成。这种设计保证了列间长度一致性——end_row()会校验所有列长度是否都等于num_rows_+1,防止写入不完整行。列式存储使得column()方法能直接暴露连续内存,供后续SIMD向量化操作直接访问,无需行转列转换。
验证方法
将上述代码保存为batch_demo.cpp,使用以下命令编译并运行:
g++ -std=c++11 -O2 -o batch_demo batch_demo.cpp
./batch_demo
预期输出(由代码逻辑直接推出):
Batch行数: 3
Batch列数: 2
第0行: 10 20
第1行: 30 40
第2行: 50 60
get(2,1) = 60
判定标准:程序正常退出且输出与上述预期一致,说明Batch的写入、行结束校验、随机读取和迭代遍历均工作正常。若end_row()前各列追加次数不一致,程序应抛出std::runtime_error异常,可自行添加错误路径测试验证。