1. 工业场景OCR系统环境搭建与图像采集
任务说明
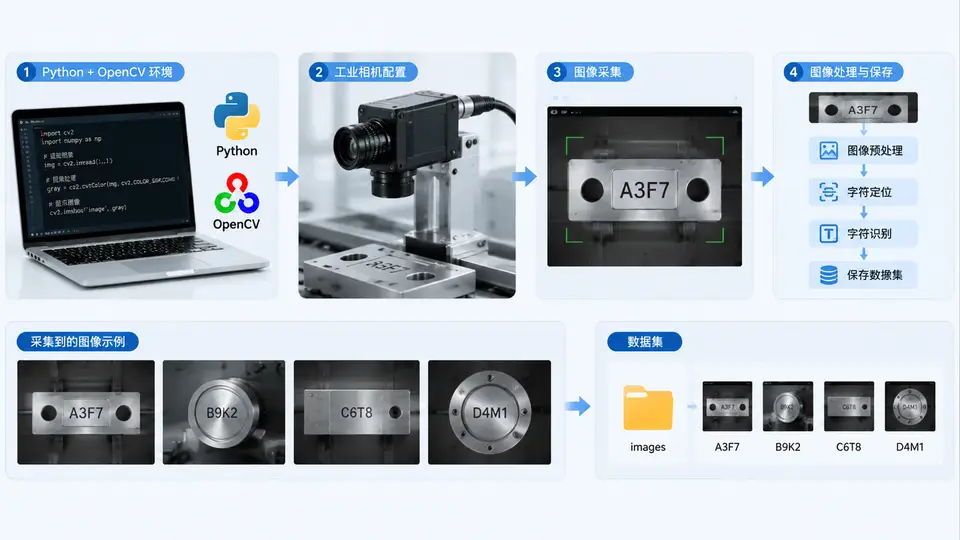
本案例完成工业OCR系统的第一步:搭建Python+OpenCV开发环境,配置工业相机(以USB接口相机为例),实现包含字符的工件图像采集,并按统一命名规则保存为本地数据集,为后续字符识别提供原始图像输入。
环境搭建
需要Python 3.8+、OpenCV(含contrib模块)、NumPy及相机厂商SDK(如Basler pylon、海康MVS)。以下命令安装核心依赖:
pip install opencv-python opencv-contrib-python numpy工业相机驱动安装后,通过OpenCV的VideoCapture或厂商SDK访问。本案例以通用USB工业相机为例,使用OpenCV直接读取,兼容多数免驱或UVC协议相机。
相机配置与图像采集实现
以下代码实现相机枚举、参数设置(分辨率、曝光、增益)、单帧采集与批量保存。采集时自动创建带时间戳的目录,文件名包含工件编号与采集时间,便于数据集管理。
import cv2
import os
import time
from datetime import datetime

class IndustrialCamera:
    """工业相机采集器(USB/UVC接口)"""
    def __init__(self, camera_index=0, width=1280, height=1024):
        self.cap = cv2.VideoCapture(camera_index)
        if not self.cap.isOpened():
            raise RuntimeError(f"无法打开相机 {camera_index},请检查连接与驱动")
        # 设置分辨率
        self.cap.set(cv2.CAP_PROP_FRAME_WIDTH, width)
        self.cap.set(cv2.CAP_PROP_FRAME_HEIGHT, height)
        # 关闭自动曝光,启用手动控制
        self.cap.set(cv2.CAP_PROP_AUTO_EXPOSURE, 0.25)  # 0.25表示手动模式
        self.cap.set(cv2.CAP_PROP_EXPOSURE, 100)        # 曝光值(相机相关)
        self.cap.set(cv2.CAP_PROP_GAIN, 1.0)            # 增益
        # 等待传感器稳定
        time.sleep(0.2)
        # 丢弃前几帧不稳定图像
        for _ in range(5):
            self.cap.read()

    def capture_single(self):
        """采集单帧图像,返回BGR格式numpy数组"""
        ret, frame = self.cap.read()
        if not ret:
            raise RuntimeError("图像采集失败,请检查相机连接")
        return frame

    def release(self):
        self.cap.release()

def create_dataset_dir(base_dir="dataset"):
    """创建带时间戳的数据集目录"""
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    save_dir = os.path.join(base_dir, f"batch_{timestamp}")
    os.makedirs(save_dir, exist_ok=True)
    return save_dir

def collect_samples(camera, save_dir, num_samples=10, part_prefix="part"):
    """
    连续采集num_samples张工件图像并保存
    文件名格式: {part_prefix}_{编号:03d}_{时间戳}.png
    """
    for i in range(num_samples):
        frame = camera.capture_single()
        # 可在此处添加字符区域ROI裁剪逻辑
        timestamp = datetime.now().strftime("%H%M%S_%f")[:-3]
        filename = f"{part_prefix}_{i+1:03d}_{timestamp}.png"
        filepath = os.path.join(save_dir, filename)
        cv2.imwrite(filepath, frame)
        print(f"已保存: {filepath}")
        # 实时显示,按q可提前终止
        cv2.imshow("Capture", frame)
        if cv2.waitKey(300) & 0xFF == ord('q'):
            break
    cv2.destroyAllWindows()

if __name__ == "__main__":
    # 初始化相机
    cam = IndustrialCamera(camera_index=0, width=1280, height=1024)
    try:
        # 创建数据集目录
        save_path = create_dataset_dir()
        print(f"数据集目录: {save_path}")
        # 采集10张工件图像
        collect_samples(cam, save_path, num_samples=10, part_prefix="gear")
    finally:
        cam.release()
        print("相机已释放")
关键实现说明
代码中IndustrialCamera类封装了相机打开、参数设置与单帧采集逻辑。手动曝光与增益设置确保不同光照条件下图像亮度一致,是工业字符识别的关键预处理。采集循环中每帧间隔300ms,便于操作者调整工件位置。文件名中的编号与毫秒级时间戳保证数据集唯一性与可追溯性。
验证方法
将印有字符的金属工件(如齿轮、铭牌)置于相机视野内,运行上述脚本。判定标准:
- 程序无报错,控制台输出每张图像的保存路径;
- 目标目录下生成10张PNG图像,文件命名符合
gear_编号_时间戳.png格式; - 用图像查看器打开图片,字符区域清晰可辨、无明显运动模糊,分辨率与设置一致(1280×1024);
- 相机释放后,任务管理器或系统设备中无残留相机进程占用。
判定标准
满足以下条件即视为案例目标达成:
- 环境依赖安装成功,
import cv2无报错; - 相机能被正确枚举与打开,采集图像无条纹、花屏等传输错误;
- 保存的图像文件可在文件管理器中正常预览,字符边缘锐利,无过度曝光或欠曝;
- 数据集目录按
batch_时间戳自动创建,文件命名规范,可直接作为后续OCR训练或模板匹配的输入。