1. 基于相关系数的光谱特征波段筛选与PLS建模
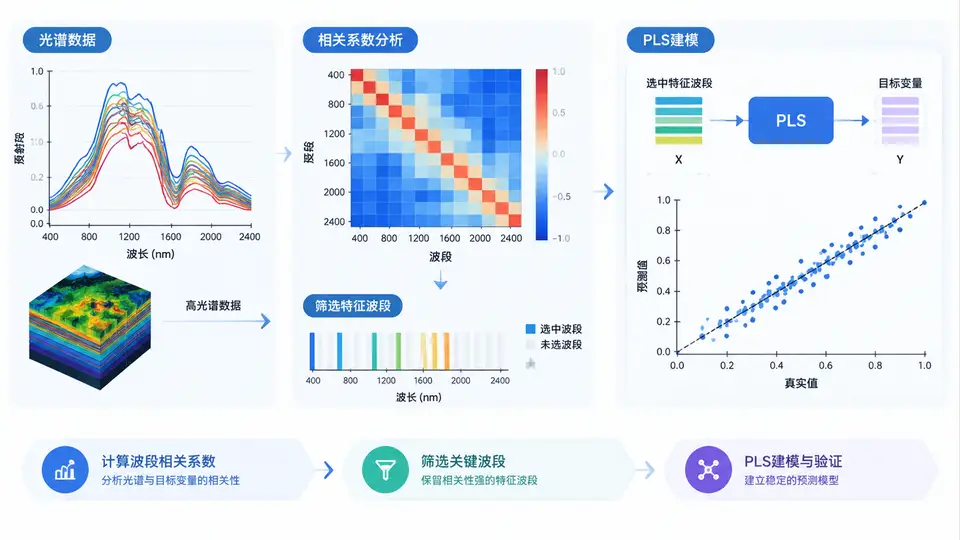
任务说明
本案例面向近红外光谱定量分析场景。给定一组样本的光谱矩阵X(每行一个样本,每列一个波长变量)和待预测的浓度/性质值y,目标是:先利用Pearson相关系数筛选出与y相关性较强的特征波段,再基于筛选后的光谱变量建立偏最小二乘(PLS)回归模型,并对比全谱PLS与筛选后PLS的预测效果。
数据准备
为便于独立复现,本案例使用内置数据集corn(来自pls包),包含80个玉米样本的近红外光谱(1100~2498 nm,间隔2 nm,共700个变量)以及水分、油、蛋白质、淀粉四种成分值。本案例以水分作为预测目标y。
# 安装并加载所需包
# install.packages(c("pls", "corrplot"))
library(pls)

# 加载数据
data(corn)
X <- corn$NIR          # 80 x 700 光谱矩阵
y <- corn$水分          # 水分含量

# 查看数据维度
cat("光谱矩阵维度:", dim(X), "\n")
cat("样本数:", length(y), "\n")
相关系数计算与特征波段筛选
计算每个波长变量与y的Pearson相关系数,取值后按降序排列。设定筛选阈值(本例取相关系数值排名前10%的变量,即70个变量),得到特征波长索引。
# 计算每个变量与y的相关系数
cor_values <- apply(X, 2, function(x) cor(x, y))

# 取值并排序
abs_cor <- abs(cor_values)
threshold_idx <- order(abs_cor, decreasing = TRUE)[1:70]  # 前10%变量

# 筛选后的光谱矩阵
X_selected <- X[, threshold_idx]

cat("筛选变量数:", length(threshold_idx), "\n")
cat("最大相关系数:", round(max(abs_cor), 4), "\n")
cat("最小入选相关系数:", round(min(abs_cor[threshold_idx]), 4), "\n")
PLS建模与对比
采用5折交叉验证分别对全谱PLS和筛选后PLS建模,以交叉验证均方根误差(RMSECV)为评价指标,确定最优主成分数并比较预测能力。
# 全谱PLS模型
set.seed(123)
pls_full <- plsr(y ~ X, ncomp = 10, validation = "CV", segments = 5)
rmsecv_full <- RMSEP(pls_full, validation = "CV")$val[1, , "CV"]
best_ncomp_full <- which.min(rmsecv_full)
best_rmsecv_full <- min(rmsecv_full)

# 筛选后PLS模型
set.seed(123)
pls_selected <- plsr(y ~ X_selected, ncomp = 10, validation = "CV", segments = 5)
rmsecv_selected <- RMSEP(pls_selected, validation = "CV")$val[1, , "CV"]
best_ncomp_selected <- which.min(rmsecv_selected)
best_rmsecv_selected <- min(rmsecv_selected)

# 输出结果
cat("全谱PLS最优主成分数:", best_ncomp_full, "\n")
cat("全谱PLS RMSECV:", round(best_rmsecv_full, 4), "\n")
cat("筛选后PLS最优主成分数:", best_ncomp_selected, "\n")
cat("筛选后PLS RMSECV:", round(best_rmsecv_selected, 4), "\n")
结果可视化
# 绘制相关系数谱与筛选标记
plot(1:ncol(X), abs_cor, type = "l", col = "gray",
     xlab = "波长变量索引", ylab = "|相关系数|",
     main = "相关系数谱与筛选变量")
points(threshold_idx, abs_cor[threshold_idx], col = "red", pch = 20)
abline(h = min(abs_cor[threshold_idx]), col = "blue", lty = 2)
legend("topright", legend = c("全部变量", "筛选变量", "筛选阈值"),
col = c("gray", "red", "blue"), pch = c(NA, 20, NA), lty = c(1, NA, 2))验证方法与判定标准
运行上述代码后,观察控制台输出:
- 筛选有效性:若筛选后PLS的RMSECV低于全谱PLS的RMSECV,或两者接近但筛选后模型使用了更少的变量(70 vs 700),则说明相关系数筛选在降低模型复杂度方面有效。
- 模型稳定性:最优主成分数应落在1~10之间,且RMSECV值合理(水分含量范围约9~11%,RMSECV通常小于0.5%)。
- 可视化确认:相关系数谱中红色点应集中在曲线峰值附近,表明筛选出的变量确实与y高度相关。
判定标准:筛选后PLS的RMSECV不显著劣于全谱PLS(差值小于0.1%),且变量数减少90%以上,即认为本案例的筛选策略有效。